


物理AIのための姿勢推定:キーポイントとモーションデータを使ってロボットに動きを教える方法
姿勢推定とは、体のキーポイント(関節や顔のランドマーク)を特定し、それらを接続して、体の姿勢がどのように変化するかを記述する骨格を作成するコンピュータビジョンタスクです。

対話型AIとは何か?その仕組みと、データ層が全てを決定する理由とは?
会話型 AI がパーソナライズされたインタラクションで業界をどのように変えているのかをご覧ください。インフォグラフィックをご覧ください。
コンピュータビジョンにおいて合成データが有効な場合(そして裏目に出る場合)
インフォグラフィックをダウンロード すべてのコンピュータビジョンチームは最終的に同じ壁にぶつかります。最も必要なデータは、入手できないデータなのです。

多言語音声データがグローバルAIにとって重要な理由
インフォグラフィックをダウンロード デモでは音声モデルが完璧に機能します。次に、実際のユーザー、つまりスコットランド訛りでヒングリッシュで注文する人と出会います。
データ注釈の未来:2026年以降
自動化はアノテーターに取って代わるものではなく、彼らの能力を強化するものです。データアノテーションは「ラベル付け作業」からAIデータ運用へと進化し、より高度な判断、より強固なガバナンス、より厳密な評価へとつながっています。

2026年のOCR:AIがあらゆる文書をデータに変換し、それに基づいて行動する方法
OCR は、機械が印刷されたテキストと画像を読み取れるようにする技術です。 これは、保存や処理のためにドキュメントをデジタル化するなどのビジネス アプリケーションや、経費精算のために領収書をスキャンするなどの消費者向けアプリケーションでよく使用されます。


ロボット工学における合成データと実世界データ:物理AIプロジェクトにはどちらを購入すべきか
物理AIでは、モデルがボトルネックになることはほとんどなく、データがボトルネックになります。デモでは完璧に動作するロボットポリシーが、その後停止してしまうことがあります。

プロジェクトを加速させるコンピュータービジョン用無料画像データセット22選【2026年更新】
コンピュータビジョンモデルの精度は、学習に使用する画像の精度に左右されます。クリーンでラベル付けされたデータセットを入力すると、
フィルタ:


物理AIとヒューマノイドロボットの規模拡大
シーン設定、QRマッピング、5センサー追跡を含むエンドツーエンドのデータ操作パイプラインにより、大規模な具現化AIデータセット向けに定義された100のタスクをサポートします。
表示

音声クローン品質と人間による評価
音声クローンモデルはデモでは印象的に聞こえるものの、実際の使用ではしばしば問題が生じるため、クライアントはインド英語の改善度を確実に測定する方法を必要としていた。
表示

インド諸言語に対応した多言語対話型AI構築のための高品質なトレーニングデータ
同社のAI搭載型音声処理多言語音声スイートのトレーニングのために、高品質な音声データ収集、文字起こし、および注釈サービスを提供した。
表示
30 以上のドキュメント Web がスクラップされ、コンテンツモデレーションのために注釈が付けられました
有害、成人向け、または性的に露骨なカテゴリに分割された自動コンテンツ モデレーション ML モデルを構築します。
表示


スマートシティ自律走行車向け LiDAR アノテーション プロジェクト
Shaip が SmartCity の LiDAR とカメラの 15,000 フレームのデータにどのようにして注釈を付けたかをご覧ください。
表示


人体キーポイント注釈
Shaip氏は、姿勢推定、動作解析、フィットネス追跡、およびヘルスケア動作AIをサポートするために、36のキーポイントを用いた全身スキーマを使用して、150,000万枚の画像およびビデオフレームに注釈を付けました。
表示
スマートバスルーム健康モニタリング:便器画像分類の事例研究
スマートバスルーム健康モニタリング:便器画像分類事例研究 Shaip社が10,000万枚の便器画像を分類する構造化された医療画像アノテーションパイプラインをどのように提供したか...
表示
地盤掘削ツール(GET)の境界ボックス注釈
Shaipは、KITTI 1.0フォーマットと99%以上の精度ゲートを使用して、15種類の地中掘削工具クラスにわたって、毎月40,000万件のGETバウンディングボックス注釈を摩耗監視AIに提供しました。
表示
鉄道マルチモーダルLiDARと2Dアノテーション
Shaipは、39種類以上の鉄道オブジェクトクラス、8種類のラベルタイプ、25種類以上の信号状態にわたる2Dカメラおよび3D LiDARアノテーションを提供し、自律走行列車の認識と鉄道安全AIをサポートしました。
表示
自動運転のための3D LiDARバウンディングボックス注釈
Shaipは、自動運転車の認識のために3D LiDARとカメラのアノテーションを提供し、スマートモビリティAI向けの物体検出、センサーアライメント、モデル対応のトレーニングデータをサポートしています。
表示
小売ファッション製品の注釈
Shaipは、マネキン、フラットレイ、ライブモデルの画像全体にわたって、複数の属性を持つファッション製品のアノテーションを提供し、ビジュアル検索、コーディネートの提案、バーチャル試着、在庫自動化AIをサポートしました。
表示
シーン全体のセマンティックセグメンテーション
Shaipは、街路全体のシーンにわたってピクセルレベルのセマンティックセグメンテーションを実現し、自動運転、スマートシティ、環境AIアプリケーション向けに、あらゆる物体と表面にラベルを付けました。
表示
農業における果物検出のためのバウンディングボックス注釈
Shaip氏は、収量予測、ロボットによる収穫、作物の健康状態に関するAIを支援するため、果樹園の画像に写っているすべてのリンゴに、厳密な境界ボックスと3層の状態属性を注釈として付与した。
表示
OCRによるテキスト検出と文字起こし注釈
Shaipは、OCRおよび文書インテリジェンスAI向けに、文書、手書き文字、標識、領収書、ナンバープレート、その他のテキストソース全体にわたって、単語レベルのバウンディングボックスと文字レベルの文字起こしを提供しました。
表示
自動診断および遠隔歯科医療AIのための歯科画像アノテーション
Shaip氏は、自動診断、治療計画、遠隔歯科医療AIを支援するため、歯科X線写真、口腔内画像、臨床写真から個々の歯のポリゴンセグメンテーションを実行した。
表示
サービスロボットと身体化されたAIのための屋内シーンオブジェクト注釈
Shaipは、ロボットの知覚、ナビゲーション、およびインタラクションAIを支援するために、密集した屋内シーンにバウンディングボックス、ポリゴン、空間的な関係、およびオブジェクト属性を注釈付けした。
表示
倫理的規律の下、多様な人口統計学的属性にわたる顔認識アノテーション
Shaipは、顔認識、感情検出、年齢推定、本人確認、および関連する顔AIアプリケーション向けに、顔の境界ボックス、顔のランドマークマッピング、および10以上の属性レイヤーを提供しました。
表示
農業技術AIのための衛星画像アノテーション
Shaipは、精密農業と地理空間AI向けに、航空写真や衛星写真などの農業画像全体にわたって区画レベルのポリゴン分割を実現し、9種類以上の土地区分タイプと6層の土地情報を提供します。
表示
保険金請求、修理見積もり、車両検査のための車両画像アノテーションAI
Shaipは、保険および検査AI向けに、ポリゴン分割、11クラスの損傷分類、深刻度タグ付け、および修理推奨属性を使用して、車両のボディパーツと損傷に注釈を付けました。
表示
高精度医療画像アノテーションによるAIを活用した便分析の高速化
Shaipは、自動的な消化器系健康分析を支援するため、多角形による便のセグメンテーション、容器の境界ボックス、およびAOI分類を用いて、700,000万枚以上の便関連の医療画像に注釈を付けました。
表示
LiDARと2Dアノテーションによる鉄道シーン理解の変革
Shaipは、鉄道シーンの理解のためにLiDARと2D画像の注釈を提供し、鉄道物体の検出、シーン認識、自律移動AIのためのモデル対応データセットを作成しました。
表示これらの条件に一致する事例研究はありません。


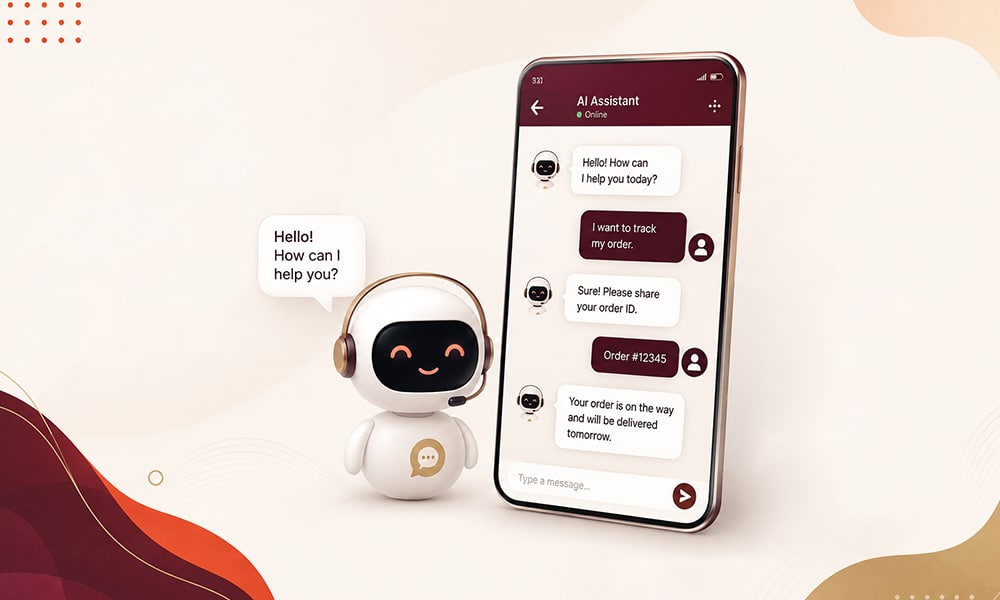
対話型AIとは何か?その仕組みと、データ層が全てを決定する理由とは?
会話型 AI がパーソナライズされたインタラクションで業界をどのように変えているのかをご覧ください。インフォグラフィックをご覧ください。
コンピュータビジョンにおいて合成データが有効な場合(そして裏目に出る場合)
インフォグラフィックをダウンロード すべてのコンピュータビジョンチームは最終的に同じ壁にぶつかります。最も必要なデータは、
2026年のOCR:AIがあらゆる文書をデータに変換し、それに基づいて行動する方法
OCR は、機械が印刷されたテキストと画像を読み取れるようにする技術です。 これは、保存や処理のためにドキュメントをデジタル化するなどのビジネス アプリケーションや、経費精算のために領収書をスキャンするなどの消費者向けアプリケーションでよく使用されます。

ハーディック氏は、企業にとって真の課題はデータ量ではなく、データの準備状況である理由を説明する。
記録を見る
当社のCRO(最高収益責任者)であるハーディック・パリク氏が、ラスベガスで開催されたAi4 2022において、「コンピュータビジョンデータ収集における課題解決」をテーマに基調講演を行いました。
記録を見る
このウェビナーでは、音声技術が様々な分野でどのように活用できるか、そして対話型AIがエンドユーザーエクスペリエンスをどのように向上させるかについて解説します。

このウェビナーでは、AIの活用事例、トレーニングデータセット、データ処理などを通じて、医療分野でデータをどのように活用できるかを解説します。
物理AIのための姿勢推定:キーポイントとモーションデータを使ってロボットに動きを教える方法
姿勢推定とは、体のキーポイント(関節や顔のランドマーク)を特定し、それらを接続して、体の姿勢がどのように変化するかを記述する骨格を作成するコンピュータビジョンタスクです。
対話型AIとは何か?その仕組みと、データ層が全てを決定する理由とは?
会話型 AI がパーソナライズされたインタラクションで業界をどのように変えているのかをご覧ください。インフォグラフィックをご覧ください。
コンピュータビジョンにおいて合成データが有効な場合(そして裏目に出る場合)
インフォグラフィックをダウンロード すべてのコンピュータビジョンチームは最終的に同じ壁にぶつかります。最も必要なデータは、入手できないデータなのです。
多言語音声データがグローバルAIにとって重要な理由
インフォグラフィックをダウンロード デモでは音声モデルが完璧に機能します。次に、実際のユーザー、つまりスコットランド訛りでヒングリッシュで注文する人と出会います。
データ注釈の未来:2026年以降
自動化はアノテーターに取って代わるものではなく、彼らの能力を強化するものです。データアノテーションは「ラベル付け作業」からAIデータ運用へと進化し、より高度な判断、より強固なガバナンス、より厳密な評価へとつながっています。
2026年のOCR:AIがあらゆる文書をデータに変換し、それに基づいて行動する方法
OCR は、機械が印刷されたテキストと画像を読み取れるようにする技術です。 これは、保存や処理のためにドキュメントをデジタル化するなどのビジネス アプリケーションや、経費精算のために領収書をスキャンするなどの消費者向けアプリケーションでよく使用されます。
ロボット工学における合成データと実世界データ:物理AIプロジェクトにはどちらを購入すべきか
物理AIでは、モデルがボトルネックになることはほとんどなく、データがボトルネックになります。デモでは完璧に動作するロボットポリシーが、その後停止してしまうことがあります。
プロジェクトを加速させるコンピュータービジョン用無料画像データセット22選【2026年更新】
コンピュータビジョンモデルの精度は、学習に使用する画像の精度に左右されます。クリーンでラベル付けされたデータセットを入力すると、
