-
会社
実際のパフォーマンスを実現するために収集、転記、注釈付けされた多言語音声データを使用して、より高精度のチャットボット、ボイスボット、デジタル アシスタントをトレーニングします。
70以上の言語の音声データ― 収集、文字起こし、注釈付け済み。
既製のライセンス、またはお客様の意図、発言内容、属性に合わせてカスタマイズされたデータプログラム。
50万人を超える協力者からなる従業員が、品質と納期へのコミットメントをもってサービスを提供します。
収集から評価まで必要なものだけを選択するか、サービスを組み合わせて完全なデータ パイプラインを構築します。
リモートでもオンサイトでも、さまざまな言語、アクセント、環境のスクリプト化された自然な音声を収集します。
オプションのタイムスタンプとスピーカーラベルを使用した正確な音声テキスト変換により、ASR と会話型 AI のトレーニングをサポートします。
地域の言語、語調、文化的背景に合わせて音声トランスクリプトを翻訳およびローカライズします。
オーディオとトランスクリプトにインテント、エンティティ、その他のタグを付けて、AI モデルをトレーニングおよび微調整します。
モデル出力をテストおよびレビューして品質を測定し、本番稼働前にギャップを見つけます。
収集、転記、ラベル付け全体で品質チェックを実行し、正確性、一貫性、受け入れ可能な配信を保証します。
ASR、音声アシスタント、チャットボット向けにすぐに使える音声データセットで、会話型AIの開発を加速させましょう。70以上の言語、70万時間以上の音声データからお選びいただけます。実際のアクセント、話し方、ユースケースを反映するように構築されています。
入手できるコンテンツには、コールセンターの会話、一般的な会話、ウェイクワード/キーフレーズ、TTS(テキスト音声合成)、IVR(自動音声応答)、ポッドキャストなどが含まれます。
データセットは、柔軟なライセンス オプションを備えたメタデータを含む標準形式で提供されるため、ワークフローの統合が容易になります。
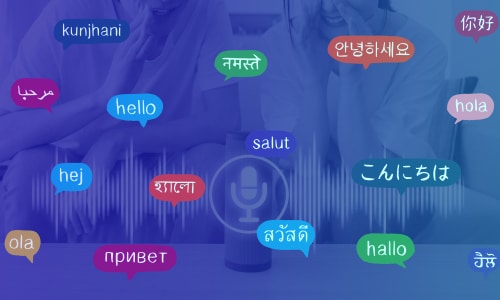
チャットボットからコンタクト センターまで、意図を理解し、実際の会話を処理し、言語間で拡張できるモデルをトレーニングします。
意図認識を改善し、フォールバック応答を削減します。
実際の会話の言い回しや変化に基づいて通話フローをトレーニングします。
正確な音声理解により、リアルタイムの提案が向上し、解決が迅速化されます。
トピック、意図、結果の洞察を得るために会話を構成します。
応答性を高め、実際の使用時の誤作動を減らします。
ラベル付きオーディオ、トランスクリプト、多様なスピーカーを使用して精度を高めます。
厳選された音声アセットを使用して自然な音声エクスペリエンスをサポートします。
大規模な言語と方言をカバーした新しい地域でサービスを開始します。
特定の意図、フレーズ、キーワードに関するプロンプトベースの音声を収集します。
現実世界の話し方のパターンを反映するために、自然な、台本のないスピーチをキャプチャします。
複数のスピーカーの音声をクリアなスピーカーターンに分割して、よりきれいなトランスクリプトを作成します。
プライバシー保護のため、音声とトランスクリプトから機密情報を検出して削除します。
品質、ガバナンス、配信に対する企業の期待に応えるように設計されています。
70 以上の言語と方言の音声データ。さまざまな地域やアクセントで会話型 AI が機能できるように構築されています。
50 万人以上の協力者からなる世界的な労働力により、一貫性を保ちながら収集、転写、注釈付けを拡大します。
実際の使用状況(さまざまな話し方、デバイス、環境)を反映した音声をキャプチャすることで、モデルのパフォーマンスをラボの条件を超えて高めます。
GDPR および HIPAA の要件に準拠した匿名化されたデータを使用して、Fortune 500 プログラムを 10 年以上サポートしています。
効率的なワークフローに裏打ちされたモバイルおよび Web ベースの収集により、期限が厳しい場合でも、一貫したデータを複数の地域に迅速に送信できます。
ニーズ(意図、発話、人口統計、データ仕様)に合わせてカスタマイズされたカスタム プログラムは、トレーニングと微調整の準備が整っています。
Shaipは、大手クラウドベース音声サービスプロバイダー向けに40以上の言語に対応したデジタルアシスタントを開発し、世界中で自然で直感的なユーザーインタラクションを実現しました。

課題: 40言語にわたる20,000時間以上の偏りのないデータを収集する
解決策: 3,000人以上の言語専門家が30週間以内に高品質の音声/文字起こしを提供しました。
結果:複数の言語を理解できる、高度に訓練されたデジタルアシスタントモデル
音声アシスタントは、ユーザーが「最寄りの病院はどこですか?」「近くの病院を探してください」「近くに病院はありますか?」など、同じ意図をさまざまな方法で表現するため、自然な発話に対応できるように訓練する必要があります。

課題: 13言語にわたる22,250時間以上の偏りのないデータを収集する
解決策: 7万件以上の音声発話を収集、文字起こしし、28週間以内に納品
結果:複数の言語を理解できる、高度に訓練された音声認識モデル
音声データセットのさまざまなアクセント、言語、スタイルを探索します。

チームが世界をリードするAI製品を構築できるようにします。


独自のAIソリューションのカスタムデータセットを収集する方法については、今すぐお問い合わせください。
会話型 AI は、チャットボットや仮想アシスタントなどのテクノロジーを使用して、自然言語処理 (NLP) と機械学習 (ML) を通じて人間の会話をシミュレートします。
自動音声認識 (ASR) を使用してテキストまたは音声を処理し、NLP を使用して意図を分析し、応答を生成し、ML を使用して時間の経過とともに改善します。
24 時間 7 日の顧客サポートを提供し、タスクを自動化し、応答時間を短縮し、コストを削減し、顧客とのやり取りをパーソナライズします。
顧客サポート、音声アシスタント、メモを取るためのヘルスケア、製品サポートのための小売、音声統合のためのモバイル アプリで使用されます。
はい、データセットは特定の言語、方言、意図、人口統計に合わせてカスタマイズできます。
はい、Shaip は 150 を超える言語と方言の多言語データセットを提供しています。
すべてのデータは匿名化されており、GDPR や HIPAA などの世界的なプライバシー標準に準拠しています。
費用はデータセットの種類、量、カスタマイズ内容によって異なります。お見積りはShaipまでお問い合わせください。
納品スケジュールはプロジェクトの範囲によって異なりますが、合意された期限に間に合うように設計されています。
Shaip は、プライバシー、スケーラビリティ、コンプライアンスを重視した、高品質でカスタマイズ可能な多言語データセットを提供しています。

当サイトでは、お客様の利便性向上のためクッキーを使用しています。当サイトを利用することで、お客様はクッキーの使用に同意したことになります。
以下の Cookie 設定を管理します。
エッセンシャルCookieは、基本的な機能を有効にし、Webサイトが適切に機能するために必要です。
Google タグ マネージャーを使用すると、コードを変更することなく、ウェブサイト上のマーケティング タグの管理が簡単になります。
統計 Cookie は匿名で情報を収集します。この情報は、訪問者が当社の Web サイトをどのように使用しているかを理解するのに役立ちます。
Google アナリティクスは、ウェブサイトのトラフィックを追跡、分析し、情報に基づいたマーケティングの意思決定を行う強力なツールです。
サービスURL:policies.google.com (新しいウィンドウで開きます)
マーケティング クッキーは、ウェブサイトへの訪問者を追跡するために使用されます。その目的は、個々のユーザーにとって関連性が高く、魅力的な広告を表示することです。
Google広告は、企業がGoogle検索結果や提携サイトに表示されるターゲット広告を作成できるオンライン広告プラットフォームです。
サービスURL:policies.google.com (新しいウィンドウで開きます)
HubSpotは、ビジネスの成長を効率化するオールインワンのマーケティング、セールス、カスタマーサービスプラットフォームです。
サービスURL:legal.hubspot.com (新しいウィンドウで開きます)
詳細については、当社のクッキーポリシーおよびプライバシーポリシーをご覧ください。