音声アシスタントに、長い会議の内容を要約させ、スペイン語に翻訳させ、アクションアイテムをCRMにプッシュさせる――これらすべてを、たった1つの音声メモから実行できることを想像してみてください。
その「魔法」の背後にあるのは、Whisperのような強力なモデルや、GeminiやChatGPTのようなLLMだけではありません。それらのモデルの学習と微調整に使用される音声認識データセットこそが、その秘密なのです。
2025年には、音声認識は数十億ドル規模の市場となり、2032年までには80億ドルを超える規模になると予測されている。
AI製品が音声入力に依存している場合(コンタクトセンターの通話、音声入力、音声検索など)、音声データセットの質、多様性、および合法性が、 AIの「聞き取り能力」を左右します。
この記事では、さまざまな音声認識データセットについて説明します。 AI モデルに最適なデータセットを選択できるように、そのタイプを調べていきます。
まずは、基本的なことから見ていきましょう。
音声認識データセットとは何ですか?
たとえば、同じフレーズを言ったとしても、テキサスの人とロンドンの人の発音は異なります。優れたデータセットはこの多様性を捉えています。これは、AI が人間の会話のニュアンスを聞き取り、理解するのに役立ちます。
このデータセットは、AI モデルの開発において重要な役割を果たします。 AI が言語の理解と言語生成を学習するために必要なデータを提供します。豊富で多様なデータセットにより、AI モデルは人間の言語をより理解して対話できるようになります。したがって、音声認識データセットは、インテリジェントで応答性が高く、正確な音声 AI モデルを作成するのに役立ちます。
高品質の音声認識データセットが必要な理由は何ですか?
音声ネイティブ LLM の台頭により、新しいデータセット タイプが登場しています。
- 自然言語による説明を使用した表現豊かな音声 (例: SpeechCraft) - スタイル、感情、韻律を理解するトレーニング モデルをサポートします。
- 実際のデータを補強するために、TTS + LLM 生成テキスト (例: Magpie Speech) を使用して作成された合成音声コーパス。
- 音声セキュリティと詐欺検出のための偽音声/なりすまし検出データセット (例: LlamaPartialSpoof)。
使用例:音声言語モデル、表現力豊かな音声合成(TTS)、またはAIによる安全性/不正検出に取り組んでいる場合。
適切な音声認識データセットの選び方(ステップバイステップ)
これを実用的な意思決定フレームワークとして使用します。
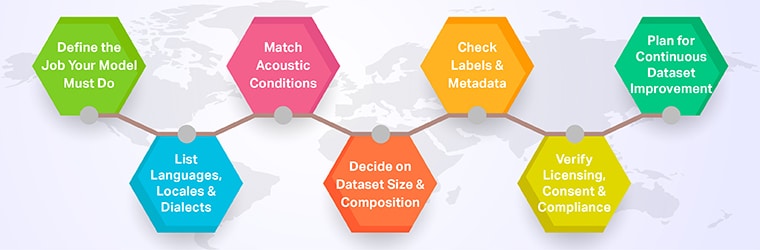
ステップ1 – モデルが実行する必要があるジョブを定義する
- 課題・テーマ: ディクテーション、音声検索、コンタクト センター分析、リアルタイム キャプション、コンプライアンス監視など。
- チャンネル: 電話(8 kHz)、モバイル アプリ、遠距離スマート スピーカー、車載マイク。
- 品質バー: ターゲット WER、レイテンシ、応答時間、規制要件。
ステップ2 – 言語、ロケール、方言を一覧表示する
- どの言語とその変種(例:米国英語、インド英語、シンガポール英語)ですか?
- あなたが必要です コード混合 スピーチ(ヒンディー語-英語、スペイン語-英語など)?
- オープンデータがまばらなリソースの少ない言語をターゲットにしていますか?
ステップ3 – 音響条件を合わせる
- テレフォニー vs ワイドバンド vs マルチマイクアレイ。
- 静かなオフィス vs 騒がしい通り vs 走行中の車。
- 近距離場マイクと遠距離場マイク。
データセットは、ユーザーが実際に利用する環境を反映している必要があります。
ステップ4 – データセットのサイズと構成を決定する
経験則(厳密ではない):
- 事前学習済みモデルの微調整 (Whisper、wav2vec2など)
- 数十時間から数百時間にわたる、高品質でドメインにマッチしたデータは、大きな変化をもたらす可能性があります。
- ゼロからモデルをトレーニングする
- 通常、数千から数万時間を要するため、多くのチームは事前にトレーニングされたシステムから開始し、データの微調整に予算を集中させます。
混合:
- 一部 クリーンなスクリプトデータ (コア音声、数字用)。
- リアル 会話データ (堅牢性のため)。
- ドメイン固有のエッジケース (まれなエンティティ、長い数値、専門用語)。
ステップ5 – ラベルとメタデータを確認する
従来の ASR の場合、少なくとも次のものが必要です。
- 正確なトランスクリプト
- 基本的なスピーカータグ
- 一貫した句読点と大文字小文字のルール
LLM + ASR パイプラインの場合、次のことも必要です。
- 話者ターンのセグメンテーション (誰がいつ何を言ったか)
- 通話/会話 成果 (解決済み、エスカレーション済み、苦情の種類)
- エンティティ注釈(名前、アカウント番号、製品名)
- 関連する場合の感情または感情のタグ。
これらのラベルを使用すると、ビジネス価値の多くが存在する文字起こしデータの上に、要約、品質保証、コーチング、ルーティング、およびRAGパイプラインを構築できます。
ステップ6 – ライセンス、同意、コンプライアンスの確認
トレーニングの前に:
- データセットのライセンスは 商業用 (研究だけではない)?
- 講演者にこの使用について通知され、同意を得ましたか?
- PII および機密属性は、GDPR / HIPAA / 現地の規制に従って処理されていますか?
多くのオープンデータセットは、CC-BYやCC0といったライセンスを使用しており、それぞれ異なる義務が課せられています。迷った場合は、法的審査を必ず行うようにしてください。
ステップ7 – 継続的なデータセットの改善を計画する
言語は進化し、製品は進化するので、データセットも進化する必要があります。
- 現実世界のエラーを監視し、誤認識をトレーニング セットにフィードバックします。
- ドメインの変更に応じて、新しいエンティティ (ブランド、SKU、規制用語) を追加します。
- 定期的にアクセントと人口統計のバランスを調整して、偏りを減らします。
このクローズドループこそが、「十分な性能」の音声製品と「市場をリードする」音声製品を分ける最大の要因となることが多い。
[関連記事:高品質なインド諸語音声データセットでAIモデルを強化しましょう。]
シャイプがどのように役立つか
「より良い音声データが必要なのは分かっているけれど、どこから始めたらいいのか分からない」という段階であれば、Shaipがお役に立ちます。
- 既存のデータセットを監査し、 カバレッジ ギャップ
- 提供する 既製の音声認識データセット 65 以上の言語と数十のドメイン (スクリプト、コール センター、ウェイク ワード、TTS など) に対応
- 設計と実行 カスタムデータ収集 プログラム(リモート、国内、マルチデバイス)
- Handle 注釈、転写、品質管理、匿名化 端から端まで
お客様のチームはモデルや製品開発に集中でき、私たちはAIが音声を聞き取り、理解するために必要な高品質で規格に準拠した音声データを確実に提供します。