データアノテーションとは?【2026年最新版】 - ベストプラクティス、ツール、メリット、課題、種類など

データ注釈の基本を知りたいですか? 始める前に、初心者向けの完全なデータ注釈ガイドをお読みください。

目次

電子ブックを ダウンロード

データ注釈

自動運転車、医療画像モデル、LLMコパイロット、音声アシスタントがなぜこれほど高性能なのか、不思議に思ったことはありませんか?その秘密は、高品質で人間による検証済みのデータアノテーションにあります。これは、テキスト、画像、音声、動画、または3D点群にラベルを付けることで、機械学習モデルがパターンを認識し、正確な予測を行えるようにするプロセスです。ほとんどのチームは、この機能を社内で構築するか、専用のデータアノテーションサービスを利用して拡張しています。

アナリストは現在、データ収集とラベリングを合わせた市場規模は2023~2024年に約3億~3.8億米ドルと推定しており、2030年までに約17億米ドル、あるいは2032年までに29億米ドル以上に達すると予測している。これは、年平均成長率(CAGR)が20%台後半であることを示唆している。Grand View Researchデータ注釈とラベリングのセグメントのみを対象としたより限定的な推定では、 2023年の市場規模は約1.6億米ドルで、2032年までに8.5億米ドルに増加すると予測されている(CAGR約20.5%)。Dataintelo

同時に、大規模言語モデル(LLM)、人間からのフィードバックに基づく強化学習(RLHF)、検索拡張型生成(RAG)、マルチモーダルAIは、「ラベル付きデータ」の意味を変えました。単に画像に猫をタグ付けするのではなく、現在ではチームは次のようなデータをキュレーションしています。

  • RLHFの嗜好データセット
  • 安全性とポリシー違反のラベル
  • RAG関連性と幻覚評価
  • 長期文脈推論と思考連鎖の監督

このような環境では、データ注釈はもはや後回しにされるものではなく、以下のような中核的な機能となります。

  • モデルの精度と信頼性
  • 市場投入までの時間と実験のスピード
  • 規制リスクと倫理的リスク
  • AIの総所有コスト

AI と ML にとってデータ注釈が重要な理由

ロボットに猫を認識させる訓練を想像してみてください。ラベルがなければ、ロボットはノイズの多いピクセルのグリッドしか認識できません。しかし、アノテーションがあれば、それらのピクセルは「猫」「耳」「尻尾」「背景」といった構造化された信号となり、AIシステムが学習できるようになります。

キーポイント:
  • AIモデルの精度: モデルの良し悪しは、トレーニングに使用したデータの品質に左右されます。高品質なアノテーションは、パターン認識、一般化、そして堅牢性を向上させます。
  • 多様な用途: 顔認識、ADAS、感情分析、会話型 AI、医用画像、文書理解などはすべて、正確にラベル付けされた AI トレーニング データに依存しています。
  • より高速なAI開発: AI 支援のデータ ラベリング ツールと人間参加型のワークフローにより、手作業を減らし、安全な場所に自動化を組み込むことで、コンセプトから実稼働への移行を迅速化できます。
2026年にも当てはまる統計:

MITによると、データサイエンティストの時間の最大80%は、実際のモデリングではなく、データの準備とラベル付けに費やされており、これはAIにおけるアノテーションの中心的な役割を浮き彫りにしている。

2026年のデータアノテーション:バイヤー向けスナップショット

市場規模と成長(すべての数字ではなく、知っておくべき情報)

競合する予測にこだわるよりも、方向性を把握することが重要です。

データ収集とラベル付け:
  • ~2023~2024年に3.0~3.8億ドル → 2030~2032年までに約17~29億ドル、CAGRは約 28%.

データの注釈とラベル付け(サービス + ツール):

  • ~2023年に1.6億ドル → 2032年までに8.5億ドル、CAGR 約20.5%。

簡単に言うと、データラベリングへの支出は、AIスタックの中で最も急速に成長している分野の一つである。

2026年のトレンド/ドライバー その意味 購入者にとってなぜ重要なのか
LLM、RLHF、RAG 需要 人間のフィードバックループ—LLM 出力のランク付け、評価、修正、ガードレール、安全ラベル、評価セットの構築。 注釈は単純なタグ付けから 判断に基づくタスク 熟練した注釈者を必要とする。必須 LLMの品質、安全性、整合性.
マルチモーダル AI モデルは統合され 画像 + ビデオ + テキスト + 音声 + センサーデータ AV、ロボット工学、ヘルスケア、スマートデバイスなどの業界全体にわたるより深い理解を実現します。 購入者はサポートするプラットフォームを必要としている マルチモーダル注釈ワークフロー および特殊なラベル付け(LiDAR、ビデオ追跡、オーディオタグ付け)。
規制対象かつ安全性が重要なAI 次のようなセクター ヘルスケア、金融、自動車、保険、公共部門 厳しい要求 トレーサビリティ、プライバシー、公平性. RFPには以下が必要です セキュリティ、コンプライアンス、データレジデンシー、監査可能性ガバナンスはベンダー選択の主要な要素になります。
AI支援による注釈 基礎モデルは注釈者を支援する 事前ラベル付け、修正を提案し、能動的な学習を可能にして、生産性の大幅な向上を実現します。 提供 最大70%高速なラベル付け (NAIST) と コストを35~40%削減スケーラブルな モデルインザループ ワークフロー。
倫理と労働力の透明性 注釈者に対する監視の強化 賃金、幸福、精神的健康特にデリケートなコンテンツの場合に有効です。 倫理的な調達は義務付けられています。ベンダーは以下を保証しなければなりません。 公正な賃金、安全な環境、責任あるコンテンツワークフロー.

2025年以降に何が変わったか

2025年のガイドと比較すると:

  • データ注釈がボード上でさらに見やすくなりました。 RLHF と LLM の需要が急増する中、大手 AI データ プロバイダーは評価額が数十億ドルに達し、多額の資金を集めています。
  • ベンダーリスクが注目されています。 大手テクノロジー企業が単一のデータラベリングプロバイダーへの依存から脱却したことで、次のような懸念が浮上した。 データガバナンス、戦略的依存、セキュリティ.
  • ハイブリッド ソーシングがデフォルトです。 ほとんどの企業は現在、 社内データアノテーション + アウトソーシング + クラウドソーシング 1つのモデルを選択するのではなく。

データ注釈とは何ですか?

データ注釈

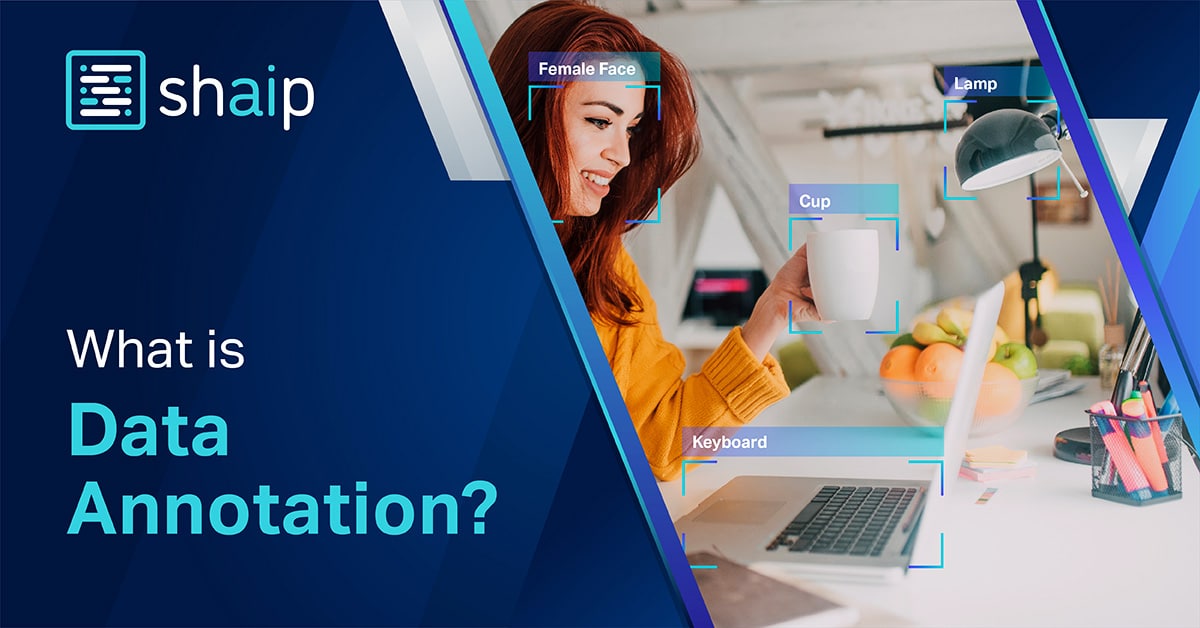
データアノテーションとは、機械学習アルゴリズムがデータを処理し理解できるように、データ(テキスト、画像、音声、動画、または3Dポイントクラウドデータ)にラベルを付けるプロセスを指します。AIシステムが自律的に動作するには、学習の基盤となる豊富なアノテーション付きデータが必要です。

現実世界のAIアプリケーションでどのように機能するか

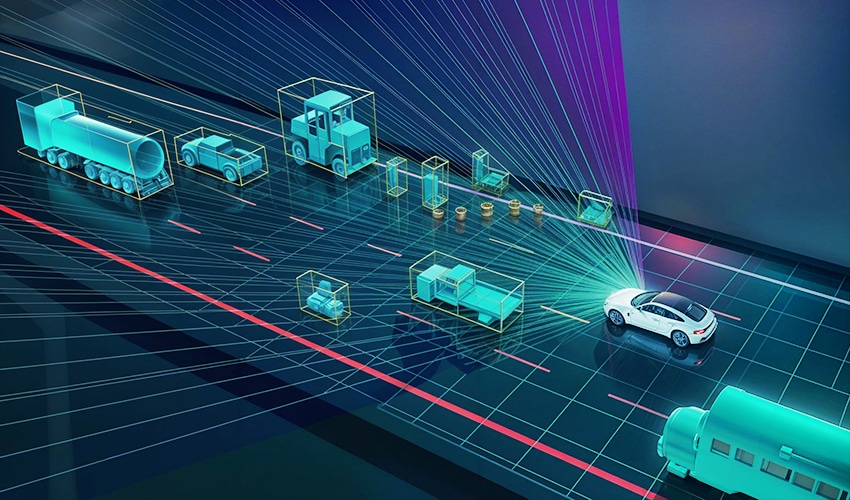
  • 自己駆動車: 注釈付き画像と LiDAR データは、歩行者、障害物、その他の車両を車が検出するのに役立ちます。
  • ヘルスケアAI: ラベル付けされた X 線と CT スキャンにより、モデルは異常を識別する方法を学びます。
  • 音声アシスタント: 注釈付きのオーディオ ファイルは、アクセント、言語、感情を理解できるように音声認識システムをトレーニングします。
  • 小売 AI製品と顧客の感情のタグ付けにより、パーソナライズされた推奨事項が可能になります。

データ注釈の種類

データアノテーションは、テキスト、画像、音声、動画、3D空間データなど、データの種類によって異なります。機械学習(ML)モデルを正確に学習させるには、それぞれ独自のアノテーション手法が必要です。以下に、最も重要なアノテーションの種類を分類します。
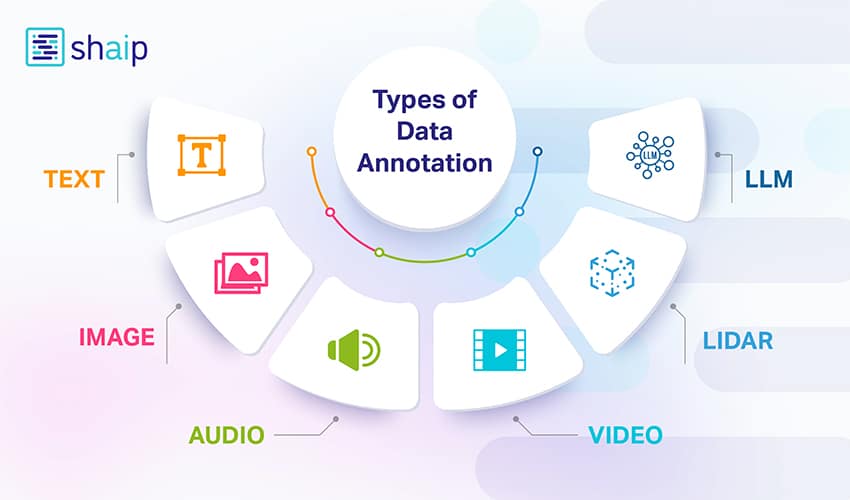
データ注釈の種類

テキスト注釈

テキスト注釈とテキストラベル付け

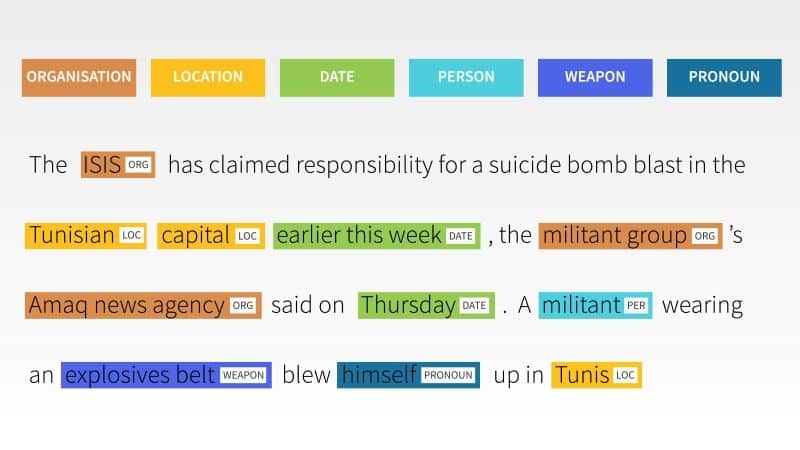
テキストアノテーションとは、AIや自然言語処理(NLP)モデルが人間の言語を理解、解釈、処理できるように、テキスト内の要素にラベルやタグを付けるプロセスです。テキストにメタデータ(データに関する情報)を追加することで、モデルがエンティティ、感情、意図、関係性などを認識できるようにします。

チャットボット、検索エンジン、感情分析、翻訳、音声アシスタント、コンテンツモデレーションといったアプリケーションにとって不可欠であり、大規模なデータセットや多言語データセット全体に正確にスケーリングできる点が、専用のテキスト注釈サービスが真価を発揮するところです。

テキスト注釈の種類 Use Case 例:
エンティティアノテーション(NER – 固有表現抽出) テキスト内の主要なエンティティ (人物、場所、組織、日付など) を識別してラベル付けします。 検索エンジン、チャットボット、情報抽出に使用されます。 「Apple がパリに新店舗をオープン」という場合、組織として「Apple」、場所として「パリ」というラベルを付けます。
品詞 (POS) タグ付け 文中の各単語に文法的な役割(名詞、動詞、形容詞など)をラベル付けします。 機械翻訳、文法修正、テキスト読み上げシステムを改善します。 「猫は速く走る」では、「猫」を名詞、「走る」を動詞、「速く」を副詞としてタグ付けします。
センチメントアノテーション テキストに表現されている感情的な調子や意見を識別します。 製品レビュー、ソーシャル メディアのモニタリング、ブランド分析に使用されます。 「映画は素晴らしかった」という場合は、感情を「ポジティブ」としてタグ付けします。
インテントアノテーション 文章またはクエリ内のユーザーの意図をラベル付けします。 仮想アシスタントや顧客サポート ボットで使用されます。 「ニューヨーク行きのフライトを予約して」という場合は、旅行予約という意図をタグ付けします。
セマンティックアノテーション 概念にメタデータを追加し、テキストを関連するエンティティまたはリソースにリンクします。 ナレッジグラフ、検索エンジン最適化、セマンティック検索で使用されます。 「Tesla」に「電気自動車」というコンセプトにリンクするメタデータをタグ付けします。
共参照解決注釈 異なる単語が同じエンティティを参照しているかどうかを識別します。 会話型 AI と要約のコンテキスト理解に役立ちます。 「ジョンは来ると言った」という場合、「彼」が「ジョン」を指しているとタグ付けします。
言語注釈 音声、形態、構文、または意味情報を使用してテキストに注釈を付けます。 言語学習、音声合成、NLP 研究に使用されます。 音声合成用にテキストにストレスとトーンのマーカーを追加します。
毒性とコンテンツモデレーションに関する注釈 有害、不快、またはポリシーに違反するコンテンツにラベルを付ける。 ソーシャル メディアのモデレーションとオンラインの安全性に使用されます。 「嫌いです」を攻撃的なコンテンツとしてタグ付けする。

一般的なタスク:

  • チャットボットのトレーニング: ユーザー入力に注釈を付けて、チャットボットがクエリを理解し、正確に応答できるようにします。
  • 文書分類: トピックまたはカテゴリに基づいてドキュメントにラベルを付けると、簡単に並べ替えたり自動化したりできます。
  • 顧客感情モニタリング: 顧客からのフィードバックにおける感情的なトーン (肯定的、否定的、中立的) を識別します。
  • スパムフィルタリング: 不要なメッセージや無関係なメッセージにタグを付けて、スパム検出アルゴリズムをトレーニングします。
  • エンティティのリンクと認識: テキスト内の名前、組織、または場所を検出してタグ付けし、それらを現実世界の参照にリンクします。

画像注釈

画像の注釈と画像のラベル付け

画像アノテーションとは、コンピュータビジョンモデルが認識・解釈できるように、画像内のオブジェクト、特徴、または領域にラベルを付けたりタグ付けしたりするプロセスです。

これは、AIや機械学習モデルのトレーニングにおいて重要なステップであり特に自動運転、顔認識、医用画像処理、物体検出といったアプリケーションにおいて重要です。

幼児に教えることを想像してみてください。犬の絵を指さして「犬」と言い続けることで、子どもが自分で犬を認識できるようになります。画像注釈は、AIにとって同じ役割を果たします。

画像注釈の種類 Use Case 例:
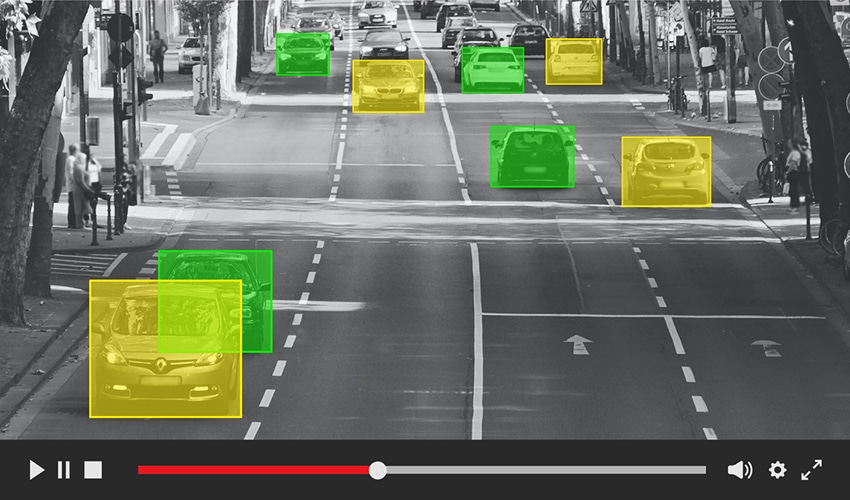
境界ボックス注釈 オブジェクトの周囲に長方形のボックスを描画して、その位置とサイズを定義します。 画像やビデオ内のオブジェクト検出。 交通監視映像内の車の周囲に四角形を描画します。
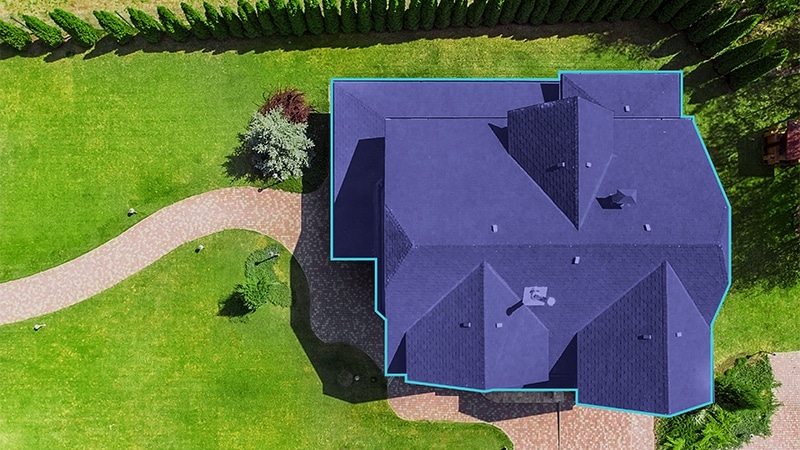
ポリゴンアノテーション 複数の接続されたポイントを使用してオブジェクトの正確な形状の輪郭を描き、精度を高めます。 衛星画像や農業画像内の不規則な形状の物体にラベルを付ける。 航空写真で建物の境界をトレースします。
セマンティックセグメンテーション 画像内のすべてのピクセルをクラスに応じてラベル付けします。 自動運転や医療用画像処理における正確な物体境界の識別。 街のシーンで、「道路」のピクセルを灰色、「木」のピクセルを緑色、「車」のピクセルを青色に色付けします。
インスタンスのセグメンテーション 同じクラスに属している場合でも、各オブジェクト インスタンスに個別にラベルを付けます。 同じタイプの複数のオブジェクトをカウントまたは追跡します。 群衆画像に人物 1、人物 2、人物 3 を割り当てます。
キーポイントとランドマークの注釈 物体上の特定の関心ポイント(顔の特徴、体の関節など)をマークします。 顔認識、ポーズ推定、ジェスチャー追跡。 人間の顔の目、鼻、口の角をマークします。
3D直方体アノテーション オブジェクトの周囲に立方体のようなボックスを描画して、3D 空間での位置、寸法、方向を取得します。 自律走行車、ロボット工学、AR/VR アプリケーション。 配送トラックの周囲に 3D 直方体を配置して、距離とサイズを検出します。
線とポリラインの注釈 線形構造に沿って直線または曲線を描きます。 車線検出、道路マッピング、電力線検査。 ダッシュカムの映像で道路の車線に沿って黄色の線を描きます。
スケルトンまたはポーズの注釈 キーポイントを接続して、動きを追跡するためのスケルトン構造を作成します。 スポーツ分析、ヘルスケア姿勢分析、アニメーション。 頭、肩、肘、膝を接続してランナーの動きを追跡します。

一般的なタスク:

  • オブジェクト検出: 境界ボックスを使用して画像内のオブジェクトを識別し、その場所を特定します。
  • シーン理解: コンテキスト画像解釈のためにシーンのさまざまなコンポーネントにラベルを付けます。
  • 顔検出と認識: 人間の顔を検出し、顔の特徴に基づいて個人を認識します。
  • 画像分類: 視覚的なコンテンツに基づいて画像全体を分類します。
  • 医療画像診断: X 線や MRI などのスキャンで異常にラベルを付けて、臨床診断を支援します。
  • 画像のキャプション画像を分析し、その内容を説明する文章を生成するプロセス。これには、物体検出と文脈理解の両方が含まれます。
  • 光学式文字認識(OCR): スキャンした画像、写真、または文書から印刷されたテキストまたは手書きのテキストを抽出し、機械で読み取り可能なテキストに変換します。

ビデオ注釈

ビデオの注釈

ビデオ アノテーションとは、ビデオ内のフレーム全体にわたってオブジェクト、イベント、またはアクションにラベルとタグを付け、AI とコンピューター ビジョン モデルが時間の経過とともにそれらを検出、追跡、理解できるようにするプロセスです。

静止画像を扱う画像アノテーションとは異なり、ビデオアノテーションでは動き、シーケンス、時間的な変化が考慮され、AI モデルが動く物体や活動を分析するのに役立ちます。

自律走行車、監視、スポーツ分析、小売、ロボット工学、医療画像処理などに使用されています。

ビデオ注釈の種類 Use Case 例:
フレームごとの注釈 ビデオ内の各フレームに手動でラベルを付けて、オブジェクトを追跡します。 移動する物体に高い精度が必要な場合に使用します。 野生動物のドキュメンタリーで、トラの動きを追跡するために各フレームにラベルを付けます。
境界ボックストラッキング 移動するオブジェクトの周囲に長方形のボックスを描画し、フレーム間で追跡します。 トラフィック監視、小売分析、セキュリティに使用されます。 交差点の CCTV 映像で車を追跡します。
ポリゴントラッキング ポリゴンを使用して、境界ボックスよりも高い精度で移動するオブジェクトの輪郭を描きます。 スポーツ分析、ドローン映像、不規則な形状の物体検出に使用されます。 ポリゴン形状を使用して、ゲーム内のサッカーボールを追跡します。
3D直方体トラッキング 立方体のようなボックスを描画して、時間の経過とともに 3D 空間におけるオブジェクトの位置、方向、寸法をキャプチャします。 自動運転やロボット工学に使用されます。 ダッシュカムの映像で移動中のトラックの位置とサイズを追跡します。
キーポイントと骨格のトラッキング 特定のポイント(関節、ランドマーク)にラベルを付けて接続し、体の動きを追跡します。 人間の姿勢推定、スポーツパフォーマンス分析、ヘルスケアに使用されます。 レース中の短距離走者の腕と脚の動きを追跡します。
ビデオにおけるセマンティックセグメンテーション 各フレームのすべてのピクセルにラベルを付けて、オブジェクトとその境界を分類します。 自動運転車、AR/VR、医療用画像に使用されます。 すべてのビデオ フレーム内の道路、歩行者、車両にラベルを付けます。
ビデオにおけるインスタンスセグメンテーション セマンティックセグメンテーションに似ていますが、各オブジェクトインスタンスも分離します。 群衆監視、行動追跡、物体カウントに使用されます。 混雑した駅で各人に個別にラベルを付ける。
イベントまたはアクションの注釈 ビデオ内の特定のアクティビティまたはイベントにタグを付けます。 スポーツのハイライト、監視、小売行動の分析に使用されます。 サッカーの試合で「ゴールが入った」瞬間にラベルを付ける。

一般的なタスク:

  • アクティビティの検出: ビデオ内の人間または物体のアクションを識別してタグ付けします。
  • 時間の経過に伴うオブジェクト追跡: ビデオ映像内を移動するオブジェクトをフレームごとに追跡してラベルを付けます。
  • 行動分析: ビデオ フィード内の被写体のパターンと動作を分析します。
  • 安全監視: ビデオ映像を監視して、セキュリティ侵害や危険な状態を検出します。
  • スポーツ/公共スペースでのイベント検出: ゴール、ファウル、観客の動きなどの特定のアクションやイベントにフラグを設定します。
  • ビデオ分類(タグ付け): ビデオ分類には、ビデオ コンテンツを特定のカテゴリに分類することが含まれます。これは、オンライン コンテンツを管理し、ユーザーに安全なエクスペリエンスを提供するために不可欠です。
  • ビデオキャプション画像にキャプションを付けるのと同じように、ビデオのキャプションではビデオのコンテンツを説明的なテキストに変換します。

オーディオ注釈

音声注釈と音声ラベル付け 音声注釈と音声ラベル付け

オーディオ注釈は、AI および音声認識モデルが話し言葉、環境音、感情、またはイベントを解釈できるように、サウンド録音にラベルとタグを付けるプロセスです。

これには、音声セグメントのマーク付け、話者の識別、テキストの転記、感情のタグ付け、背景ノイズの検出などが含まれます。

音声注釈は、仮想アシスタント、文字起こしサービス、コールセンター分析、言語学習、音声認識システムなど、幅広い用途で利用されています。これらの用途では、正確で多言語対応の音声注釈サービスが、現実世界の音声を理解できるモデルと、アクセントやノイズにつまずくモデルとの違いを生み出します。

音声注釈の種類 Use Case 例:
音声からテキストへの文字起こし 音声ファイル内の話し言葉をテキストに変換します。 字幕、文字起こしサービス、音声アシスタントで使用されます。 ポッドキャストのエピソードをテキスト形式に書き起こします。
スピーカーのダイアリゼーション オーディオ ファイル内のさまざまなスピーカーを識別してラベル付けします。 コール センター、インタビュー、会議の文字起こしに使用されます。 カスタマー サポートの通話で「スピーカー 1」と「スピーカー 2」にタグを付ける。
音声注釈 音声中の音素(音の最小単位)にラベルを付ける。 言語学習アプリや音声合成に使用されます。 「think」という単語の/th/の音をマークします。
感情注釈 スピーチで表現された感情(幸せ、悲しい、怒っている、中立など)にタグを付けます。 感情分析、通話品質監視、メンタルヘルス AI ツールで使用されます。 サポートコールで顧客の口調を「イライラしている」と表現する。
インテント注釈(音声) 口頭での要求や命令の目的を識別する。 仮想アシスタント、チャットボット、音声検索で使用されます。 「ジャズ音楽を再生」では、インテントを「音楽を再生」とタグ付けします。
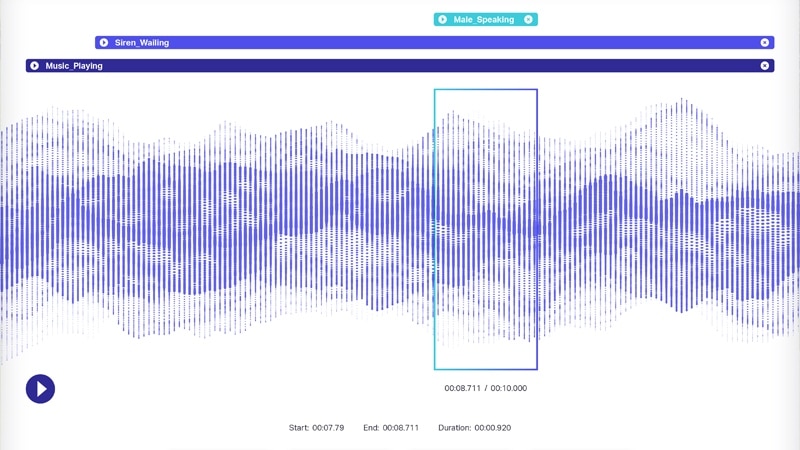
環境音注釈 音声録音内の背景音または非音声音にラベルを付けます。 音声分類システム、スマート シティ、セキュリティに使用されます。 路上で録音された音声に「犬の吠え声」や「車のクラクション」をタグ付けする。
タイムスタンプ注釈 オーディオ内の特定の単語、フレーズ、またはイベントにタイムマーカーを追加します。 ビデオ編集、文字起こしの調整、ASR モデルのトレーニング データに使用されます。 スピーチの中で特定の単語が話されたときに時間を「00:02:15」とマークします。
言語と方言の注釈 オーディオの言語、方言、またはアクセントをタグ付けします。 多言語の音声認識および翻訳に使用されます。 録音に「スペイン語 - メキシコ訛り」というラベルを付ける。

 一般的なタスク:

  • 音声認識: 個々の話者を識別し、既知の音声と一致させます。
  • 感情の検出: トーンやピッチを分析して、話し手の怒りや喜びなどの感情を検出します。
  • 音声分類: 拍手、アラーム、エンジン音などの音声以外の音を分類します。
  • 言語識別: オーディオ クリップで話されている言語を認識します。
  • 多言語音声文字起こし: 複数の言語の音声をテキストに変換します。

LIDAR アノテーション

LiDAR注釈

LiDAR (Light Detection and Ranging) アノテーションは、LiDAR センサーによって収集された 3D ポイント クラウド データにラベルを付けるプロセスであり、これにより AI モデルは XNUMX 次元環境内のオブジェクトを検出、分類、追跡できるようになります。

LiDAR センサーは、周囲の物体に反射するレーザーパルスを放射し、距離、形状、空間位置をキャプチャして、環境の 3D 表現 (ポイント クラウド) を作成します。

アノテーションは、自動運転、ロボット工学、ドローンナビゲーション、マッピング、産業オートメーションのためのAIのトレーニングに役立ちます。これは、ロボットや具現化されたシステムのための物理AIデータアノテーションの基盤となります。

3Dポイントクラウドラベリング

: 3D 環境内の空間ポイントのクラスターにラベルを付けます。
例:: 自動運転車の LiDAR データから自転車を識別します。

直方体

: ポイント クラウド内のオブジェクトの周囲に 3D ボックスを配置して、寸法と方向を推定します。
例:: 道路を横断する歩行者の周囲に 3D ボックスを作成します。

セマンティックセグメンテーションとインスタンスセグメンテーション

:\n- セマンティック: 各ポイントにクラスを割り当てます (例: 道路、木)。\n- インスタンス: 同じクラスのオブジェクトを区別します (例: Car 1 と Car 2)。
例:: 混雑した駐車場で個々の車両を分離します。

一般的なタスク:

  • 3D オブジェクト検出: ポイント クラウド データを使用して 3D 空間内のオブジェクトを識別および特定します。
  • 障害物の分類: 歩行者、車両、障壁などのさまざまな種類の障害物をタグ付けします。
  • ロボットの経路計画: 自律型ロボットがたどる安全で最適な経路を注釈付けします。
  • 環境マッピング: ナビゲーションと分析のために周囲の注釈付き 3D マップを作成します。
  • 動き予測: ラベル付けされた移動データを使用することで、物体または人間の軌道を予測します。

LLM(大規模言語モデル)アノテーション
Llm(大規模言語モデル)アノテーション

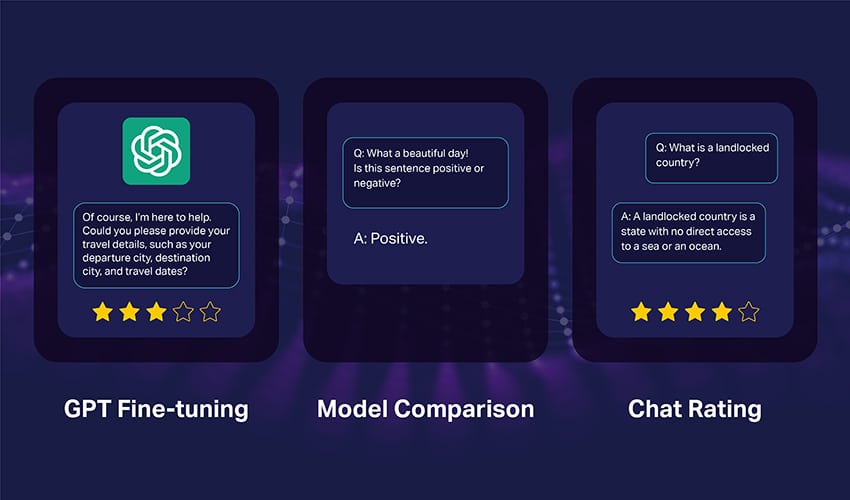
LLM (大規模言語モデル) アノテーションは、大規模な AI 言語モデル (GPT、Claude、Gemini など) を効果的にトレーニング、微調整、評価できるように、テキスト データをラベル付け、キュレーション、構造化するプロセスです。

これは、質問への回答、コンテンツの要約、コードの生成、人間の指示に従うなどのタスクを LLM が実行できるように、複雑な指示、コンテキストの理解、マルチターンのダイアログ構造、および推論パターンに焦点を当てることで、基本的なテキスト注釈を超えています。

LLM アノテーションでは、特に微妙な判断が必要なタスクの場合、高い精度と関連性を確保するために、人間が関与するワークフローが頻繁に使用されます。

注釈の種類 Use Case 例:
指示注釈 指示に従う方法をモデルに教えるために、対応する理想的な応答を含むプロンプトを作成してラベル付けします。 チャットボットタスク、顧客サポート、Q&A システムの LLM のトレーニングに使用されます。 プロンプト:「この記事を 50 語で要約してください。」→ 注釈付き応答: ガイドラインに沿った簡潔な要約。
分類注釈 意味、トーン、トピックに基づいてテキストにカテゴリまたはラベルを割り当てます。 コンテンツのモデレーション、感情分析、トピックの分類に使用されます。 ツイートに「ポジティブ」な感情と「スポーツ」のトピックのラベルを付ける。
エンティティとメタデータの注釈 トレーニング データ内の名前付きエンティティ、概念、またはメタデータにタグを付けます。 知識検索、事実抽出、セマンティック検索に使用されます。 「テスラは2024年に新モデルを発売した」では、組織として「Tesla」、日付として「2024」というラベルを付けます。
推論チェーン注釈 答えに到達する方法について段階的な説明を作成します。 論理的推論、問題解決、数学タスクの LLM トレーニングに使用されます。 質問:「15 × 12 はいくらですか?」→ 注釈付き推論:「15 × 10 = 150、15 × 2 = 30、合計 = 180。」
会話注釈 コンテキストの保持、意図の認識、正しい応答を備えたマルチターンの会話を構築します。 会話型 AI、仮想アシスタント、インタラクティブ ボットで使用されます。 顧客が配送について質問する → AI が関連するフォローアップの質問と回答を提供します。
エラー注釈 LLM 出力の間違いを識別し、再トレーニングのためにラベル付けします。 モデルの精度を向上し、幻覚を軽減するために使用されます。 「パリはイタリアの首都である」を事実上の誤りとしてマークする。
安全性とバイアスに関する注釈 有害、偏向、またはポリシー違反のコンテンツにタグを付けて、フィルタリングと調整を行います。 LLM をより安全かつ倫理的にするために使用されます。 「不快なジョーク」コンテンツを安全でないと分類する。
一般的なタスク:
  • 指示に従う評価: LLM がどの程度適切に実行されるか、またはユーザープロンプトに従うかを確認します。
  • 幻覚検出: LLM が不正確な情報や捏造された情報を生成した場合にそれを識別します。
  • 迅速な品質評価: ユーザープロンプトの明瞭さと有効性を評価します。
  • 事実の正確性の検証: AI の応答が事実に基づいて正確かつ検証可能であることを確認します。
  • 毒性フラグ: 有害、不快、または偏った AI 生成コンテンツを検出し、ラベルを付けます。

機械学習を成功させるためのステップバイステップのデータラベリング/データ注釈付けプロセス

データ注釈付けプロセスには、機械学習アプリケーションのための高品質で正確なデータラベル付けプロセスを確保するための、明確に定義された一連の手順が含まれます。これらの手順は、非構造化データの収集から注釈付きデータのエクスポートまで、プロセスのあらゆる側面をカバーしています。効果的な MLOps プラクティスにより、このプロセスを合理化し、全体的な効率を向上させることができます。
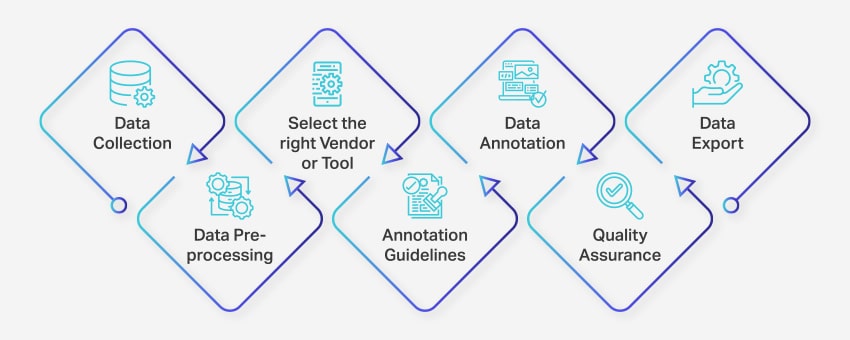
データ注釈およびデータラベル付けプロジェクトにおける 3 つの重要なステップ

データ注釈チームの作業方法は次のとおりです。

  1. データ収集: データ注釈プロセスの最初のステップは、画像、ビデオ、音声録音、テキスト データなどのすべての関連データを一元化された場所に収集することです。
  2. データの前処理: 画像の傾き補正、テキストの書式設定、ビデオ コンテンツの転記などにより、収集したデータを標準化および強化します。前処理により、データが注釈付けタスクの準備が整っていることが保証されます。
  3. 適切なベンダーまたはツールを選択してください: プロジェクトの要件に基づいて、適切なデータ注釈ツールまたはベンダーを選択します。
  4. 注釈のガイドライン: 注釈者または注釈ツールの明確なガイドラインを確立して、プロセス全体で一貫性と正確性を確保します。
  5. 注釈: 確立されたガイドラインに従って、人間の注釈者またはデータ注釈プラットフォームを使用してデータにラベルとタグを付けます。
  6. 品質保証 (QA): 注釈付きデータを確認して、正確性と一貫性を確保します。 結果の品質を検証するために、必要に応じて複数のブラインド アノテーションを使用します。
  7. データのエクスポート: データの注釈が完了したら、必要な形式でデータをエクスポートします。 Nanonets のようなプラットフォームは、さまざまなビジネス ソフトウェア アプリケーションへのシームレスなデータ エクスポートを可能にします。

プロジェクトのサイズ、複雑さ、および利用可能なリソースに応じて、データ注釈プロセス全体は数日から数週間の範囲になります。

エンタープライズ データ アノテーション プラットフォーム / データ ラベリング ツールに求められる高度な機能

適切なデータアノテーションツールの選択は、AIプロジェクトの成否を左右します。重要なのはデータセットの品質だけではありません。データラベリングプラットフォームは、精度、速度、コスト、そして拡張性に直接影響を及ぼします。ここでは、現代の企業が求めるべきコア機能を簡潔にまとめました。


データラベリングツール

データセット管理

優れたプラットフォームでは、大規模なデータセットのインポート、整理、バージョン管理、エクスポートが容易になります。

探す:

  • 一括アップロードのサポート(画像、ビデオ、オーディオ、テキスト、3D)
  • 並べ替え、フィルタリング、マージ、データセットの複製
  • 時間の経過に伴う変更を追跡するための強力なデータバージョン管理
  • 標準 ML 形式 (JSON、COCO、YOLO、CSV など) にエクスポートします。

複数の注釈技術

ツールは、コンピューター ビジョン、NLP、オーディオ、ビデオ、3D など、すべての主要なデータ タイプをサポートする必要があります。

必須の注釈メソッド:

  • 境界ボックス、ポリゴン、セグメンテーション、キーポイント、直方体
  • ビデオ補間とフレームトラッキング
  • テキストラベル付け(NER、感情、意図、分類)
  • 音声文字起こし、話者タグ、感情タグ
  • LLM/RLHF タスクのサポート (ランキング、スコアリング、安全性ラベル付け)

AI 支援によるラベル付けが標準となり、自動注釈付けによって作業がスピードアップし、手作業の労力が削減されます。

組み込みの品質管理

優れたプラットフォームには、ラベルの一貫性と正確性を維持するための QA 機能が含まれています。

主な機能:

  • レビュー担当者のワークフロー(注釈者 → レビュー担当者 → QA)
  • ラベルの合意と紛争解決
  • コメント、フィードバックスレッド、変更履歴
  • 以前のデータセットバージョンに戻す機能

セキュリティ&コンプライアンス

注釈には機密データが含まれることが多いため、セキュリティは厳重にする必要があります。

探す:

  • 役割ベースのアクセス制御 (RBAC)
  • SSO、監査ログ、安全なデータストレージ
  • 不正ダウンロードの防止
  • HIPAA、GDPR、SOC 2、または業界標準への準拠
  • プライベートクラウドまたはオンプレミス展開のサポート

人材とプロジェクト管理

最新のツールは、注釈チームとワークフローの管理に役立ちます。

本質的な特徴:

  • タスクの割り当てとキュー管理
  • 進捗状況の追跡と生産性指標
  • 分散チーム向けのコラボレーション機能
  • シンプルで直感的なUIで、学習曲線も緩やか

データ注釈の利点は何ですか?

データ注釈は、機械学習システムを最適化し、ユーザー エクスペリエンスを向上させるために不可欠です。 データ注釈の主な利点を次に示します。

  1. トレーニング効率の向上: データのラベル付けにより、機械学習モデルのトレーニングが改善され、全体的な効率が向上し、より正確な結果が得られます。
  2. 精度の向上: 正確に注釈が付けられたデータにより、アルゴリズムが効果的に適応して学習できるようになり、将来のタスクでより高いレベルの精度が得られます。
  3. 人間の介入の削減: 高度なデータ注釈ツールにより、手作業による介入の必要性が大幅に減少し、プロセスが合理化され、関連するコストが削減されます。

したがって、データ注釈は、AI モデルのトレーニングに従来必要とされていたコストと手作業を最小限に抑えながら、より効率的で正確な機械学習システムに貢献します。 データアノテーションの利点を分析する
データ注釈の品質管理

Shaip は、データ注釈プロジェクトの品質を確保するために、複数段階の品質管理を通じて最高レベルの品質を確保します。

  • 初期トレーニング: 注釈者はプロジェクト固有のガイドラインについて徹底的にトレーニングを受けます。
  • 継続的なモニタリング: 注釈付けプロセス中の定期的な品質チェック。
  • 最終レビュー: 上級注釈者による包括的なレビューと自動化ツールにより、正確性と一貫性が確保されます。

さらに、AI は人間による注釈の不一致を識別し、レビューのためにフラグを立てて、全体的なデータ品質を高めることもできます。(たとえば、AI は、異なる注釈者が画像内の同じオブジェクトにラベルを付ける方法の矛盾を検出できます)。したがって、人間と AI を使用すると、注釈の品質を大幅に向上させながら、プロジェクトを完了するのにかかる全体的な時間を短縮できます。

一般的なデータ注釈の課題を克服する 

データ注釈は、AI および機械学習モデルの開発と精度において重要な役割を果たします。 ただし、このプロセスには独自の一連の課題があります。

  1. データに注釈を付けるコスト: データ注釈は、手動または自動で実行できます。 手作業による注釈付けには、多大な労力、時間、およびリソースが必要であり、コストの増加につながる可能性があります。 プロセス全体でデータの品質を維持することも、これらの費用の一因となります。
  2. 注釈の精度: アノテーション プロセス中に人的エラーが発生すると、データ品質が低下し、AI/ML モデルのパフォーマンスと予測に直接影響を与える可能性があります。 Gartner による調査では、次のことが強調されています。 データ品質の低さは、企業に最大 15% のコストをもたらします 彼らの収入の。
  3. 拡張性データ量が増加すると、特にマルチモーダル データを扱う場合、データセットが大きいと注釈付けのプロセスがより複雑になり、時間がかかるようになります。品質と効率性を維持しながらデータ注釈付けを拡張することは、多くの組織にとって困難です。
  4. データのプライバシーとセキュリティ: 個人情報、医療記録、財務データなどの機密データに注釈を付けると、プライバシーとセキュリティに関する懸念が生じます。 注釈プロセスが関連するデータ保護規制と倫理ガイドラインに準拠していることを確認することは、法的および評判上のリスクを回避するために重要です。
  5. 多様なデータ タイプの管理: テキスト、画像、オーディオ、ビデオなどのさまざまなデータ タイプを処理することは、特にさまざまな注釈技術や専門知識が必要な場合に困難な場合があります。 これらのデータ型全体で注釈プロセスを調整および管理することは、複雑でリソースを大量に消費する可能性があります。

組織は、これらの課題を理解して対処することで、データ注釈に関連する障害を克服し、AI および機械学習プロジェクトの効率と有効性を向上させることができます。

データアノテーションの社内 vs. アウトソーシング

社内データアノテーション vs. アウトソーシング

大規模なデータアノテーションを実施する場合、組織は社内にアノテーションチームを構築するか、外部ベンダーにアウトソーシングするかを選択する必要があります。それぞれの方法には、コスト、品質管理、拡張性、専門知識といった点で、明確な長所と短所があります。

社内データアノテーション

メリット

  • より厳格な品質管理: 直接監督により、より高い精度と一貫した出力が保証されます。
  • ドメイン専門知識の調整: 社内注釈者は、業界やプロジェクトのコンテキスト (医療用画像や法律文書など) に合わせて特別にトレーニングを受けることができます。
  • データのプライバシー: 機密データや規制対象データ (HIPAA、GDPR など) に対する制御を強化。
  • カスタムワークフロー: 社内の開発パイプラインに合わせた、完全に適応可能なプロセスとツール。

デメリット

  • 運用コストの増加: 採用、研修、給与、インフラ、管理。
  • 限られたスケーラビリティ: 突然の大規模プロジェクトに対応しにくくなります。
  • セットアップ時間の延長有能な社内チームを構築し、トレーニングするには数か月かかります。

🛠️ 最適な用途:

  • ハイステークスAIモデル(例:医療診断、自動運転)
  • 継続的かつ一貫した注釈付けが必要なプロジェクト
  • 厳格なデータガバナンスポリシーを持つ組織

アウトソーシングされたデータアノテーション

メリット

  • 高い費用対効果: 特に大規模なデータセットの場合、規模の経済のメリットを享受できます。
  • より迅速なターンアラウンド: ドメイン経験を持つ事前トレーニング済みの労働力により、より迅速な提供が可能になります。
  • 拡張性: 大量プロジェクトや多言語プロジェクト向けにチームを簡単に増強できます。
  • グローバル人材へのアクセス: 多言語または専門的なスキル (アフリカの方言、地域のアクセント、希少言語など) を持つ注釈者を活用します。

デメリット

  • データセキュリティのリスク: ベンダーのプライバシーおよびセキュリティ プロトコルに依存します。
  • コミュニケーションギャップ: タイムゾーンや文化の違いがフィードバック ループに影響を及ぼす可能性があります。
  • 制御が少ない: 堅牢な SLA と QA システムが導入されていない限り、内部品質ベンチマークを実施する能力が低下します。

🛠️ 最適な用途:

  • 単発または短期のラベリングプロジェクト
  • 社内リソースが限られているプロジェクト
  • 急速なグローバルな労働力拡大を目指す企業

社内データアノテーションとアウトソーシングデータアノテーション

因子 社内で アウトソーシング
設定時間 高(採用、トレーニング、インフラストラクチャの設定が必要) 低(ベンダーには即戦力となるチームがある)
費用 高額(固定給、福利厚生、ソフトウェア/ツール) 低価格(変動、プロジェクトベースの価格設定)
拡張性 社内チームの能力によって制限される オンデマンドで高度に拡張可能
データ制御 最大(ローカルデータの処理と保存) ベンダーのポリシーとインフラストラクチャに依存する
コンプライアンスとセキュリティ HIPAA、GDPR、SOC 2 などへの直接的なコンプライアンスをより簡単に確保できます。 ベンダーのコンプライアンス認証とデータ処理プロセスを確認する必要がある
領域知識 高い(ニッチな業界特有の要件に合わせてスタッフをトレーニングできる) 様々 — ベンダーの専門分野によって異なります
品質管理 直接的なリアルタイム監視 堅牢なQAプロセス、サービスレベル契約(SLA)、監査が必要
経営努力 高(人事、プロセス設計、ワークフロー監視) 低(ベンダーが人材、ツール、ワークフローを管理)
テクノロジーとツール 社内予算と専門知識によって制限される 多くの場合、高度なAI支援ラベル作成ツールへのアクセスが含まれます
人材の可用性 地元の雇用プールに限定 グローバルな才能と多言語の注釈者へのアクセス
タイムゾーンカバレッジ 通常は営業時間内に限定されます グローバルベンダーチームによる24時間7日のサポートが可能
ターンアラウンドタイム 採用/トレーニングによる立ち上げの遅延 既存のチーム構成により、プロジェクトのキックオフと納品が迅速化されます
理想的な 厳格なデータ管理を伴う長期的、機密性が高い、複雑なプロジェクト 短期、多言語、大量、または急速な規模のプロジェクト

ハイブリッドアプローチ: 両方の長所を活かす?

今日、多くの成功しているAIチームはハイブリッドアプローチを採用している。

  • キープ 社内コアチーム 高品質な制御とエッジケースの決定のため。
  • 大量のタスクをアウトソーシングする (オブジェクトの境界設定や感情ラベル付けなど)を信頼できるベンダーに委託して、スピードとスケールを確保します。

適切なデータ注釈ツールの選び方

データ注釈ツール

最適なデータアノテーションツールの選択は、AIプロジェクトの成否を左右する重要な決断です。市場が急速に拡大し、要件もますます高度化する中で、選択肢を整理し、ニーズに最適なツールを見つけるための、実用的で最新のガイドをご紹介します。

データアノテーション/ラベリングツールは、機械学習モデルの高品質なトレーニングデータにアノテーションを付与するために使用されるクラウドベースまたはオンプレミスのプラットフォームです。複雑なタスクについては外部ベンダーに依頼するケースが多い一方で、カスタムビルドツールやオープンソースツールを使用するケースもあります。これらのツールは、画像、動画、テキスト、音声といった特定のデータタイプに対応し、境界ボックスやポリゴンといった機能によって効率的なラベリングを実現します。

1. ユースケースとデータ型を定義する

まず、プロジェクトの要件を明確に概説します。

  • 注釈を付けるデータの種類は、テキスト、画像、ビデオ、オーディオ、あるいはそれらの組み合わせでしょうか?
  • あなたのユースケースでは、画像の意味的セグメンテーション、テキストの感情分析、音声の文字起こしなどの特殊な注釈技術が必要ですか?

現在のデータ タイプをサポートするだけでなく、プロジェクトの進化に合わせて将来のニーズにも対応できる柔軟性を備えたツールを選択してください。

2. アノテーション機能と技術を評価する

タスクに関連する包括的な注釈方法を提供するプラットフォームを探してください。

  • コンピューター ビジョンの場合: 境界ボックス、ポリゴン、セマンティック セグメンテーション、直方体、キーポイント注釈。
  • NLP の場合: エンティティ認識、感情タグ付け、品詞タグ付け、共参照解決。
  • オーディオの場合: 文字起こし、話者のダイアライゼーション、イベントのタグ付け。

高度なツールには、AI 支援機能や自動ラベル付け機能が搭載されることが多くなり、注釈付けの速度が上がり、一貫性が向上します。

3. スケーラビリティと自動化を評価する

ツールは、プロジェクトの拡大に​​合わせて増加するデータ量を処理できる必要があります。

  • プラットフォームは、速度を向上させ、手作業の労力を削減するために、自動または半自動の注釈機能を提供していますか?
  • パフォーマンスのボトルネックなしでエンタープライズ規模のデータセットを管理できますか?
  • 大規模なチームのコラボレーションを効率化するためのワークフロー自動化機能とタスク割り当て機能が組み込まれていますか?

4. データ品質管理を優先する

堅牢な AI モデルには、高品質の注釈が不可欠です。

  • リアルタイムレビュー、コンセンサスワークフロー、監査証跡などの品質管理モジュールが組み込まれたツールを探してください。
  • エラー追跡、重複の削除、バージョン管理、簡単なフィードバック統合をサポートする機能を探してください。
  • プラットフォームによって最初から品質基準を設定および監視できることを確認し、誤差と偏りを最小限に抑えます。

5. データセキュリティとコンプライアンスを考慮する

プライバシーとデータ保護に関する懸念が高まる中、セキュリティは譲れないものとなっています。

  • ツールは、強力なデータ アクセス制御、暗号化、業界標準 (GDPR や HIPAA など) への準拠を提供する必要があります。
  • データがどこにどのように保存されるか(クラウド、ローカル、ハイブリッドのオプション)と、ツールが安全な共有とコラボレーションをサポートしているかどうかを評価します。

6. 人材管理を決定する

データに注釈を付けるユーザーを決定します。

  • このツールは社内の注釈チームと外部委託の注釈チームの両方をサポートしていますか?
  • タスクの割り当て、進捗状況の追跡、コラボレーションの機能はありますか?
  • 新しい注釈者のオンボーディングに提供されるトレーニング リソースとサポートを検討してください。

7. ベンダーではなく適切なパートナーを選ぶ

ツールプロバイダーとの関係は重要です。

  • 積極的なサポート、柔軟性、そしてニーズの変化に応じて適応する意欲を提供するパートナーを探してください。
  • 同様のプロジェクトでの経験、フィードバックへの対応、機密保持とコンプライアンスへの取り組みを評価します。

キーテイクアウェイ

プロジェクトに最適なデータアノテーションツールとは、特定のデータタイプに対応し、成長に合わせて拡張でき、データの品質とセキュリティを保証し、ワークフローにシームレスに統合できるツールです。これらの重要な要素に重点を置き、最新のAIトレンドに合わせて進化するプラットフォームを選択することで、AIイニシアチブを長期的な成功へと導くことができます。


業界固有のデータアノテーションのユースケース

データアノテーションは、あらゆる業界に当てはまる万能な方法ではありません。業界ごとにデータセット、目標、そしてアノテーション要件は異なります。以下は、実用性と実用性を兼ね備えた、業界固有の主要なユースケースです。

健康

ユースケース:医療画像と患者記録への注釈付け

概要:医療分野は、最も要求の厳しいラベル付け環境の一つです。すべてのタグは臨床的および規制上の重要性を持ち、そのため専門的な医療データ注釈は、認定注釈者とICD-10やSNOMEDなどのコーディング標準に依存しています。典型的な作業内容は以下のとおりです。

  • 注釈を付ける X線、CTスキャン、MRI、診断 AI モデルのトレーニング用の病理学スライドなど。
  • ラベルエンティティ 電子健康記録(EHR)症状、薬の名前、投与量など 固有表現抽出(NER).
  • 臨床会話の書き起こしと分類 音声ベースの医療アシスタント向け。

効果:早期診断の改善、治療計画の迅速化、放射線診断および文書作成における人的ミスの削減。

自動車および輸送

ユースケース:ADASおよび自動運転車システムへの電力供給

説明

  •   LiDARポイントクラウドラベリング 歩行者、道路標識、車両などの 3D オブジェクトを検出します。
  • 注釈を付ける 物体追跡用のビデオフィード、車線検出、運転行動分析などを行います。
  • モデルのトレーニング ドライバーモニタリングシステム(DMS) 顔と目の動きの認識を介して。

影響:より安全な自動運転システムを実現し、道路ナビゲーションを改善し、正確な注釈によって衝突事故を削減します。

小売&Eコマース

ユースケース:顧客体験とパーソナライゼーションの向上

説明

  •   テキスト注釈 ユーザーレビューに基づいて感情分析を行い、推奨エンジンを微調整します。
  • 注釈を付ける 製品イメージ カタログ分類、ビジュアル検索、在庫タグ付けなどに使用します。
  • トラック 店内の来店者数や顧客行動 スマート小売環境でのビデオ注釈の使用。

効果:商品の発見性を高め、ショッピング体験をパーソナライズし、コンバージョン率を向上させます。

ファイナンス&バンキング

ユースケース:不正行為の検出とリスク管理の最適化

説明

  • ラベル 取引パターン 教師あり学習を使用して不正検出システムをトレーニングします。
  • 注釈を付ける 財務書類請求書や銀行取引明細書などのデータを自動的に抽出します。
  • 感情ラベルを使用する ニュースや決算説明会の記録 アルゴリズム取引に対する市場感情を測定するため。

効果:不正行為の削減、請求処理の迅速化、よりスマートな財務予測の支援。

規約とポリシー

ユースケース:法律文書レビューの自動化

説明

  •   テキスト注釈 契約書、NDA、または合意書内の条項を識別して分類します (例: 責任、終了)。
  • データ プライバシー規制に従って PII (個人を特定できる情報) を編集します。
  • Apply 意図分類 リーガルテックプラットフォームで法的な問い合わせや顧客サポートチケットを整理します。

効果:弁護士のレビュー時間を短縮し、法的リスクを軽減し、法律事務所や法律関連BPOにおける文書処理時間を短縮します。

教育とeラーニング

ユースケース:インテリジェントな個別指導システムの構築

説明

  • 注釈を付ける 学生の質問と回答 適応学習モデルをトレーニングするため。
  • コンテンツタイプ(定義、例、演習など)にタグを付ける 自動化されたカリキュラム構成.
  •   音声テキスト注釈 講義やウェビナーの書き起こしと索引付けに使用します。

効果:学習のパーソナライズを向上させ、コンテンツへのアクセス性を高め、AIを活用した進捗状況の追跡を可能にします。

ライフサイエンスと製薬

ユースケース:研究および創薬の強化

説明

  • 注釈を付ける ゲノムデータ または、遺伝子、タンパク質、化合物などの名前付きエンティティの生物学テキスト。
  • ラベル 臨床試験文書 患者の洞察と試験結果を抽出します。
  • 処理と分類 化学図や実験ノート OCR と画像注釈を使用します。

効果:生物医学研究を加速させ、臨床データマイニングを支援し、研究開発における手作業を削減する。

コンタクトセンターとカスタマーサポート

ユースケース:自動化と顧客インサイトの向上

説明

  • 書き写して注釈を付ける カスタマーサポートへの電話 感情検出、意図分類、チャットボットのトレーニングに。
  • タグ よくある苦情のカテゴリー 問題解決を優先します。
  • 注釈を付ける ライブチャット 会話型 AI と自動応答システムをトレーニングします。

効果:サポート効率の向上、解決時間の短縮、AIを活用した24時間7日の顧客サポートを実現します。

データ注釈のベスト プラクティスは何ですか?

AI および機械学習プロジェクトを確実に成功させるには、データ注釈のベスト プラクティスに従うことが不可欠です。 これらのプラクティスは、注釈付きデータの精度と一貫性を高めるのに役立ちます。

  1. 適切なデータ構造を選択してください: 有用であるために十分に具体的でありながら、データ セットのすべての可能なバリエーションをキャプチャするために十分に一般的なデータ ラベルを作成します。
  2. 明確な指示を提供する: 詳細でわかりやすいデータ アノテーションのガイドラインとベスト プラクティスを作成して、さまざまなアノテーター間でデータの一貫性と正確性を確保します。
  3. アノテーションのワークロードを最適化する: 注釈はコストがかかる可能性があるため、事前にラベル付けされたデータセットを提供するデータ収集サービスを利用するなど、より手頃な代替手段を検討してください。
  4. 必要に応じてさらにデータを収集する: 機械学習モデルの品質が損なわれないように、データ収集会社と協力して、必要に応じてより多くのデータを収集します。
  5. アウトソーシングまたはクラウドソーシング: データ注釈の要件が大きくなりすぎて、内部リソースにとって時間がかかりすぎる場合は、アウトソーシングまたはクラウドソーシングを検討してください。
  6. 人間と機械の努力を組み合わせる: データ アノテーション ソフトウェアでヒューマン イン ザ ループ アプローチを使用して、ヒューマン アノテーターが最も困難なケースに集中し、トレーニング データ セットの多様性を高めることができるようにします。
  7. 品質を優先する: 品質保証のために、データ注釈を定期的にテストしてください。 データセットのラベル付けの正確さと一貫性について、複数のアノテーターが互いの作業をレビューするように奨励します。
  8. コンプライアンスを確保: 人や医療記録を含む画像などの機密データ セットに注釈を付ける場合は、プライバシーと倫理の問題を慎重に検討してください。 現地の規則を遵守しないと、会社の評判が損なわれる可能性があります。

これらのデータ アノテーションのベスト プラクティスに従うことで、データ セットが正確にラベル付けされ、データ サイエンティストがアクセスできるようになり、データ駆動型プロジェクトを推進する準備が整ったことを保証できます。

実世界のケーススタディ:Shaipのデータアノテーションへの影響

臨床データ注釈

ユースケース:医療提供者向け事前承認の自動化

プロジェクト範囲:6,000件の医療記録への注釈付け

期間:6ヶ月

注釈の焦点

  • 非構造化臨床テキストからの CPT コード、診断、および InterQual 基準の構造化された抽出とラベル付け
  • 患者記録内の医学的に必要な処置の特定
  • 医療文書におけるエンティティのタグ付けと分類(症状、手順、薬剤など)

プロセス

  • HIPAA準拠のアクセスを備えた臨床注釈ツールを使用
  • 認定医療注釈者(看護師、臨床コーダー)を雇用
  • 2週間ごとに注釈レビューを行うダブルパスQA
  • InterQual®およびCPT標準に準拠した注釈ガイドライン

結果

  • 98%以上の注釈精度を実現
  • 事前承認における処理遅延の削減
  • ドキュメント分類とトリアージのためのAIモデルの効果的なトレーニングを実現

自動運転車向けLiDARアノテーション

ユースケース:都市部での運転状況における3D物体認識

プロジェクト範囲:15,000フレームのLiDAR画像(複数視点カメラ入力と組み合わせ)に注釈を付ける

期間:4ヶ月

注釈の焦点

  • 車、歩行者、自転車、交通信号、道路標識の直方体を使用した 3D ポイント クラウドのラベル付け
  • 多クラス環境における複雑なオブジェクトのインスタンスセグメンテーション
  • マルチフレームオブジェクトIDの一貫性(シーケンス間の追跡用)
  • 注釈付きの遮蔽、深度、重なり合うオブジェクト

プロセス

  • 独自のLiDAR注釈ツールを使用
  • 訓練を受けたアノテーター50名とQAスペシャリスト10名からなるチーム
  • 初期の境界/直方体の提案のための AI モデルによる注釈支援
  • 手動修正と精密タグ付けによりエッジレベルの詳細が保証されました

結果

  • 99.7%の注釈精度を達成
  • 450,000個を超えるラベル付きオブジェクトを配信
  • トレーニングサイクルを短縮し、堅牢な認識モデルの開発を実現

コンテンツモデレーション注釈

ユースケース:有害コンテンツを検出するための多言語AIモデルのトレーニング

プロジェクト範囲:複数の言語で作成された30,000件以上のテキストおよび音声コンテンツサンプル

注釈の焦点

  • 有害、ヘイトスピーチ、冒涜、性的に露骨な表現、安全なコンテンツなどのカテゴリーに分類
  • コンテキスト認識分類のためのエンティティレベルのタグ付け
  • ユーザー生成コンテンツの感情と意図のラベル付け
  • 言語タグ付けと翻訳検証

プロセス

  • 文化的/文脈的なニュアンスについて訓練を受けた多言語アノテーター
  • 曖昧なケースに対するエスカレーションを備えた階層型レビューシステム
  • リアルタイムQAチェックを備えた内部注釈プラットフォームを使用

結果

  • コンテンツフィルタリングのための高品質なグラウンドトゥルースデータセットを構築
  • 地域全体で文化的配慮とラベルの一貫性を確保
  • 多様な地域に対応するスケーラブルなモデレーションシステムをサポート

データアノテーションに関する専門家の見解

業界リーダーが語る、アノテーションによる正確でスケーラブル、そして倫理的なAI構築

ヘルスケアAIでは、エラーの余地はほぼゼロです。アノテーションを効果的に行うには、医学的に訓練されたアノテーターを活用し、ICD-10やSNOMEDなどの臨床コーディング標準に準拠し、PHI(個人医療情報)が匿名化されていることが不可欠です。高品質なアノテーションは、単なるラベル付けではなく、患者の安全、規制遵守、そして真の臨床的洞察の実現に大きく貢献します。
データラベリングの一貫性を確保し、バイアスを低減するため、厳格なガイドラインを導入し、定期的なレビューを実施し、アノテーターの再トレーニングを行っています。また、データセットの匿名化、疲労防止のためのアノテーターの作業時間制限、そしてチームへのメンタルヘルスサポートも行っています。
無意識の偏見に関する包括的なトレーニング、多様性のあるアノテーターチームの確保、そして定期的な監査は、高品質なデータラベリングを維持するための重要な戦略です。このアプローチにより、顧客フィードバックモデルにおいて、よりバランスの取れた感情分析を実現できました。
不適切なデータラベル付けは、AIモデルの偏りや欠陥のある結果につながります。これに対処するため、私たちは多様なアノテーターグループを編成し、バイアスを軽減するための明確なガイドラインを提供しています。データ項目ごとに複数のアノテーターを配置することで、個々のバイアスを平均化し、反復的な改善によってバイアスをさらに低減することで、不適切なデータラベル付けのリスクを軽減します。

主要なポイント(要点)

  • データアノテーションは、機械学習モデルを効果的にトレーニングするためにデータにラベルを付けるプロセスです。
  • 高品質なデータアノテーションはAIモデルの精度とパフォーマンスに直接影響します
  • 世界のデータアノテーション市場は3.4年までに2028億ドルに達し、年平均成長率38.5%で成長すると予測されている。
  • 適切な注釈ツールと技術を選択すると、プロジェクトコストを最大40%削減できます。
  • AI支援アノテーションの実装により、ほとんどのプロジェクトで効率が60~70%向上します。

このガイドはあなたにとって有益であり、ほとんどの質問に答えてくれたと正直に信じています。 ただし、信頼できるベンダーについてまだ確信が持てない場合は、もう探す必要はありません。

Shaipは、最高のデータ注釈会社です。 データとその関連する懸念を他に類を見ないほど理解している分野の専門家がいます。 各プロジェクトまたはコラボレーションへのコミットメント、機密性、柔軟性、所有権などの能力を提供するため、私たちはあなたの理想的なパートナーになることができます。

したがって、正確な注釈を取得したいデータの種類に関係なく、お客様のニーズと目標を満たすベテランのチームが当社にいます。当社で AI モデルを学習用に最適化しましょう。

専門家によるデータ注釈サービスで AI プロジェクトを変革

高品質の注釈付きデータを使用して機械学習と AI イニシアチブを強化する準備はできていますか? Shaip は、特定の業界とユースケースに合わせてカスタマイズされたエンドツーエンドのデータ注釈ソリューションを提供します。

データ注釈のニーズを満たすために Shaip と提携する理由:

  • ドメインの専門知識: 業界特有の知識を持つ専門の注釈者
  • スケーラブルなワークフロー: あらゆる規模のプロジェクトを一貫した品質で処理します
  • カスタマイズされたソリューション: お客様の独自のニーズに合わせたアノテーションプロセス
  • セキュリティとコンプライアンス: HIPAA、GDPR、ISO 27001に準拠したプロセス
  • 柔軟なエンゲージメント: プロジェクトの要件に応じてスケールアップまたはスケールダウン

話しましょう

  • このフィールドは、検証目的のためであり、不変のままにする必要があります。
  • 登録することで、Shaipに同意します プライバシーポリシー (NAIST) と 利用規約 ShaipからB2Bマーケティングコミュニケーションを受け取ることに同意します。

よくある質問(FAQ)

データ注釈またはデータラベリングは、結果を予測するために、特定のオブジェクトを含むデータをマシンで認識できるようにするプロセスです。 テキスト、画像、スキャンなどのオブジェクトにタグを付けたり、文字起こししたり、処理したりすることで、アルゴリズムがラベル付けされたデータを解釈し、人間の介入なしに実際のビジネスケースを独自に解決するためのトレーニングを受けることができます。

機械学習(教師ありまたは教師なしの両方)では、ラベル付きまたは注釈付きのデータは、現実世界の課題を解決するために、機械学習モデルに理解および認識させたい機能にタグを付け、転記または処理します。

データアノテーターとは、データを機械で認識できるようにデータを充実させるためにたゆまぬ努力をする人のことです。 これには、次のステップのXNUMXつまたはすべてが含まれる場合があります(手元のユースケースと要件に応じて):データクリーニング、データ転写、データラベリングまたはデータ注釈、QAなど。

AIモデルは、パターンを認識し、分類、検出、予測などのタスクを実行するために、ラベル付けされたデータを必要とします。データアノテーションにより、モデルは高品質で構造化されたデータでトレーニングされ、精度、パフォーマンス、信頼性が向上します。

  • チームまたはベンダーに明確な注釈ガイドラインを提供します。
  • ブラインドレビューやコンセンサスモデルなどの品質保証 (QA) プロセスを使用します。
  • AI ツールを活用して不一致やエラーにフラグを立てます。
  • データの正確性を確保するために定期的な監査とサンプリングを実行します。

手動アノテーション:人間のアノテーターが行うため、高い精度が保証されるが、かなりの時間とコストがかかる。

自動注釈:AIモデルを使用してラベル付けを行うため、高速かつ拡張性に優れています。ただし、複雑なタスクでは人間のレビューが必要になる場合があります。

半自動アプローチ(人間が関与する)では、両方の方法を組み合わせて効率性と精度を実現します。

ラベル付け済みデータセットは、アノテーション付きの既成データセットであり、多くの場合、一般的なユースケースで利用できます。時間と労力を節約できますが、特定のプロジェクト要件に合わせてカスタマイズが必要になる場合があります。

教師あり学習では、ラベル付きデータがモデルの学習に不可欠です。教師なし学習では通常、アノテーションは必要ありませんが、半教師あり学習ではラベル付きデータとラベルなしデータを混在させて使用します。

生成 AI は、データの事前ラベル付けにますます使用されるようになり、一方で人間の専門家が注釈を改良および検証することで、プロセスがより高速化し、コスト効率が向上します。

機密データに注釈を付けるには、プライバシー規制の厳格な遵守、堅牢なデータ セキュリティ、ラベル付けされたデータセットの偏りを最小限に抑える対策が必要です。

予算は、ラベル付けが必要なデータの量、タスクの複雑さ、データの種類(テキスト、画像、動画)、社内チームか外部チームかによって異なります。AIツールを活用することでコストを削減できます。これらの要因によって価格は大きく変動することをご承知おきください。

コストには、データのセキュリティ、注釈エラーの修正、注釈者のトレーニング、大規模プロジェクトの管理などが含まれる場合があります。

プロジェクトの目標とモデルの複雑さによって異なります。まずは少数のラベル付きデータから始め、モデルをトレーニングし、必要に応じてデータを追加して精度を向上させます。より複雑なタスクでは、通常、より多くのデータが必要になります。