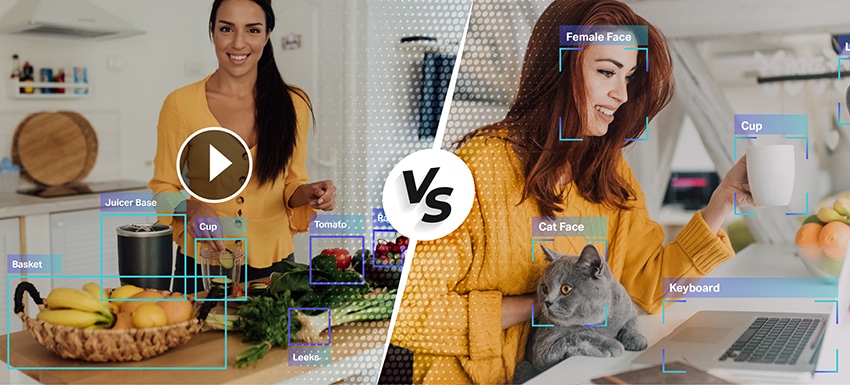
主要なポイント(要点)
- 動画注釈が機械学習モデルを学習させる どのような物体が (NAIST) と 時間の経過とともにどのように動き、変化するか (追跡、アクション、イベント)
- 画像注釈との最大の違いは 時間的一貫性: 同じオブジェクトは、フレーム間で同じ識別情報(ID)とラベルを保持する必要があります。
- 現代のチームは、 キーフレーム+補間/伝播+AI支援による事前ラベル付けそして、その節約分を品質保証に投資する。
- データセットの設計(サンプリングレート、クリップ戦略、オントロジー)は、選択するツールと同じくらい重要な場合が多い。

ビデオアノテーションとは何ですか?
動画注釈とは、コンピュータビジョンモデルが構造化された「正解データ」から学習できるように、動画フレーム内の物体、動作、またはイベントにラベルを付けるプロセスです。
静止画像とは異なり、動画の注釈では時間的な文脈、つまりフレーム間で何が起こるか(動き、遮蔽、姿勢の変化、相互作用)を保持する必要があります。
例えば、自動運転車の開発においては、ドライブレコーダーの映像に映る歩行者、信号機、他の車両、車線標識といった道路要素にラベルを付けるために、ビデオ注釈が使用されます。これにより、AIシステムは、動いている様々な物体や状況を認識して対応することで、現実世界の環境で安全に走行する方法を学習することができます。
ビデオ注釈と画像注釈

ML でのビデオのアノテーションとラベリングの目的
元の「目的」セクションは適切で、そのまま残しておくべきです。ここでは、エンジニアと購入者の両方にとってより役立つように、文脈を加えて拡張しました。
1. 物体を検出する(何が存在するか?)
目標:モデルを訓練して、 「このフレーム内にはどのようなオブジェクトが存在するか?」という問いに答える。
典型的な出力例:境界ボックス、ポリゴン、セグメンテーションマスク。
これが重要な場合:
- 人/車両/物品の数を数える
- 在庫/棚分析
- 基本的な法令遵守状況の監視(ヘルメット着用/非着用)
2. オブジェクトの位置を特定する(オブジェクトはどこにあるのか?)
ローカリゼーションは正確な位置に焦点を当てています。これは次のようになります。
- 粗い(2Dバウンディングボックス)
- 細かい(ポリゴン/セグメンテーション)
- 奥行き認識(3D直方体)
なぜ重要なのか:
- ナビゲーションとロボット工学には、信頼性の高い幾何学的情報が必要です。
- 医療画像/ビデオには境界精度が必要
- 製造には、欠陥の正確な位置特定が求められる。
3. オブジェクトを追跡する(時間の経過とともにオブジェクトはどこへ移動するのか?)
トラッキングは、時間の経過とともにモデルに同一性を学習させる。つまり、同じ物体は、移動したり、障害物の後ろに隠れたり、再び現れたりしても、同じ軌跡を維持するべきである。
これは、ベンチマークや、フレーム間でオブジェクトの識別情報を明示的にエンコードするフォーマット(例えば、MOTシーケンスフォーマットでは、時間経過に伴う識別情報が指定される)を追跡する上で非常に重要です。
4. 活動/出来事を記録する(何が起こったか?)
アクティビティトラッキングとは、次のような行動やイベントにラベルを付けることです。
- 「人が転倒する」(開始/終了)
- 「フォークリフトが立ち入り禁止区域に進入しました」
- 「お客様が商品を選び、→商品を返品する」
- 「車両が車線変更しました」
これは以下のように表すことができます。
- フレームレベルのタグ(「フレーム内にアクションが存在する」)
- 時間区分(開始時刻→終了時刻)
- オブジェクトにリンクされたイベント(「この人物は走っている」)

ビデオ注釈技術
動画注釈の種類とそれぞれの使用タイミング
このセクションのコンテンツと、その後のこの表を保持してください。
ビデオ注釈業界の使用例
動画アノテーションは多くの業界で活用されていますが、特に動き、行動、そして時間の経過に伴う出来事をモデルが理解する必要がある分野で広く利用されています。以下に、最も一般的な業界における活用事例を示します。
共通の目標:道路利用者を検知・追跡し、車線構造を理解し、安全上重要な状況(ニアミス、急ブレーキ、割り込み)を認識する。
ラベル付けする対象:車両、歩行者、自転車(フレーム間で一貫したIDを使用)、信号機/標識、車線/道路端、および「車線変更」や「横断歩道」などのイベント。
最適な注釈タイプ: 2Dバウンディングボックス+トラッキングID(コア)、車線/道路端用のポリライン、奥行き/サイズ把握のためのオプションの3D直方体。
QAの重点事項:混雑したシーンでのIDの入れ替わりを防ぎ、明確なオクルージョンルール(オブジェクトが部分的に隠れている場合)を定義し、フレーム変更後もレーンラインの一貫性を維持する。
共通の目標:臨床的に関連のある領域とランドマークを時系列的に特定し、検出、分類、および手順の理解を支援する。
ラベル付けする内容:関心領域(病変部/組織境界)、解剖学的ランドマーク、器具の位置、および時間的区分(例:「ポリープが見える」開始→終了)。
最適な注釈の種類:セグメンテーション(正確な境界を示すため)、キーポイント/ランドマーク(解剖学的構造を示すため)、ボックス(器具を示すため)、時間的イベントラベル(手順を示すため)。
品質保証の重点事項:境界の正確性とラベルの一貫性が重要です。ノイズの多い真の値を避けるために、厳密な定義、専門家によるレビュー、および明確な「不確実/曖昧」の処理方法を使用してください。
共通の目標: 顧客の動きを追跡し、滞在時間や待ち行列の状況を測定し、製品とのインタラクションを検出することで、業務運営やレイアウトに関する意思決定を改善します。
ラベルを貼る内容: 人物追跡(ID)、店舗ゾーン(棚エリア、レジエリア)、および「商品選択」、「商品返品」、「列への入場」、「列からの退出」などのイベント。
最適な注釈タイプ: 人物を表すボックスと追跡ID、ゾーンを表すポリゴン、インタラクションとキューイベントを表す時間的イベントラベル。
品質保証の重点事項:明確なイベント定義(「ピック」と「タッチ」の違いなど)、一貫性のあるゾーン境界、プライバシーに配慮したラベル付けルール(例えば、必要でない場合は顔レベルの詳細情報を避ける)。
共通の目標: 広範囲にわたり、さまざまな解像度でインフラを検出・監視し、境界線をマッピングし、移動物体(車両/船舶)を追跡します。
ラベルを貼る内容: 道路/小道、建物/関心のある地域、水域の境界、移動物体(軌道を含む)、および変化事象(建設の進捗状況、洪水の拡大)。
最適な注釈タイプ: ポリライン(道路/境界線)、ポリゴン(エリア/建物)、ボックス+トラッキング(移動オブジェクト)、土地/水域/植生クラスに対するオプションのセグメンテーション。
品質保証の重点事項:場所やズームレベルを問わず一貫性を保つこと、低解像度オブジェクトに関するルール、および「部分的にしか見えない」またはぼやけたターゲットに対する明確なガイドライン。
共通の目標: 作物の状態を監視し、雑草や病気を検出し、家畜の行動を追跡することで、生産性と安全性を確保する。
ラベルを貼る内容: 作物の列/畑の境界、雑草と作物の領域、病害の発生箇所、動物(足跡)、および「動物が制限区域に侵入した」などの事象。
最適な注釈タイプ: ポリライン/ポリゴン(列/圃場)、セグメンテーション(作物と雑草/病害)、ボックス+追跡(家畜)、イベントラベル(行動事象)。
品質保証の重点項目:季節変動や照明の変化への対応、一貫性のある分類体系(作物の種類/雑草の種類)、重なり合う植生や部分的な視界に関する明確なルール。
共通の目標: プレーヤーやオブジェクトを追跡し、ハイライトを検出し、分析、放送オーバーレイ、コンテンツインデックス作成のためにアクションを理解する。
ラベルを貼る内容: 選手とボール/物体の軌跡、重要な瞬間(ゴール、シュート、ファウル)、そしてオプションでポーズのランドマークを設定することで、詳細な動作理解を可能にします。
最適な注釈タイプ: ボックス表示+トラッキング(選手/ボール)、時間的イベントラベル(ハイライト)、ポーズベース分析用のオプションのキーポイント。
品質保証の重点事項:イベントの正確なタイミング(開始/終了)、高速動作/遮蔽時のIDの連続性、および主観的イベントの一貫した定義(例:「不正」基準)。
共通の目標: 安全基準違反を検知し、立ち入り禁止区域を監視し、機器や人の移動を追跡することで、事故を削減します。
ラベルを貼る内容: 人々の移動、個人用保護具(ヘルメット/ベスト)の特性、フォークリフト/ロボット、立ち入り禁止区域、および「区域への進入」、「ニアミス」、「危険な距離」などのイベント。
最適な注釈タイプ: ボックス+追跡(人/機器)、属性(個人用保護具)、ポリゴン(区域)、時間的イベントラベル(安全事故)。
品質保証の重点事項:非常に明確なコンプライアンス定義(「ヘルメット着用」とみなされる基準)、厳格なゾーン境界、および信頼性を損なう誤報を減らすためのバイアスチェック。
ステップバイステップのワークフロー:機械学習のための動画への注釈付け方法
ステップ1:タスクを定義する(そして「良い」状態とはどのようなものかを定義する)
書き留めます:
- 対象となるユースケース(例:複数物体の追跡 vs. 動作認識)
- 必要な出力(ボックス、マスク、トラック、イベント)
- 承認指標(例:一貫性、完全性、審査合格率)
上位にランクインする競合ガイドは、後々の手戻りを防ぐために、まずここから始める。
ステップ2:オントロジーとガイドライン(隠れたランキング要因)を構築する
強力なオントロジーは、時間の経過に伴う「ラベルのずれ」を軽減します。実践的なルール:
- 各クラスを次のように定義します 含める/除外する 例
- オクルージョンポリシーを定義する(ラベル付けを継続するか停止するか)。
- IDルールを定義する(新しいIDが開始される場合)
「現実に基づいて反復する」チームは、小規模なパイロットテストを実施し、アノテーターを比較検討し、ガイドラインを改良する。
ステップ3:ビデオデータ(クリップ、サンプリング、キーフレーム)を準備する
すべてのフレームにラベルを付ける代わりに:
- 長い動画を意味のあるセグメントに分割する クリップ (シーン別、カメラアングル別、シナリオ別)
- 選択する フレームサンプリングレート (料金が低いほど重複が少なくなり、料金が高いほど補償範囲が広がり、コストも増加します。)
- キーフレーム 変化の瞬間(動き/遮蔽/相互作用)には、まず変化を検知し、その後、その間の瞬間にも伝播させる。
ステップ4:時間的な一貫性を考慮して注釈を付ける
現代のワークフローは一般的に以下のようになります。
- キーフレームには丁寧にラベルを付けましょう。
- 補間/伝播またはAI支援ラベリングを使用して欠落部分を補完する
- ドリフト、オクルージョン、および見逃されたオブジェクトを手動で修正します
自動化は有益だが、それは厳格な品質保証体制を維持した場合に限る。多くのハウツーガイドでは、自動化を標準的な手法として扱っている。
ステップ5:実際に不具合を検出する品質保証(単なる「抜き打ちチェック」ではない)
実用的なQAスタック:
- キャリブレーションラウンド: 複数のアノテーターが同じクリップにラベルを付ける → 意見の相違を比較する → ルールを更新する
- 継続性チェック: IDはオブジェクト間を「飛び越えて」はならない。追跡データセットの整合性は極めて重要である。
- エッジケースレビューキュー: モーションブラー、オクルージョン、混雑したシーン
- 「旗の不確実性」に関する方針: 推測はせず、レビュー担当者向けに曖昧な点を明記してください(データセットの意図しない破損を防ぎます)。
ステップ6:機械学習スタックが想定する形式でアノテーションをエクスポートする
トラッキングモデルをトレーニングする場合、エクスポート時にはフレームの関連付けと識別情報(track_id)を保持する必要があります。MOTなどのフォーマットは、 frame_idとtrack_idを中心に設計されています。
ヒント:エクスポート形式は早めに決定しておきましょう。そうすれば、現在のスキーマでは表現できないトラック、属性、イベントが必要になることに後から気づくのを防ぐことができます。
コストとモデル性能を左右するデータセット設計の選択肢
フレームレート/サンプリング戦略
- 高サンプリング=ラベル付きフレーム数の増加、高コスト、冗長性の増加
- サンプリング数を減らすとラベル付けは速くなりますが、まれな遷移を見逃すリスクがあります。Roboflowスタイルのガイドでは、豊富さと作業負荷のバランスを取るために試行錯誤することを明示的に推奨しています。
キーフレームと高密度ラベル付けの比較
- 高速動作や安全性が重要な作業には、高密度なラベル表示が必要となる場合があります。
- キーフレームと伝播は、より滑らかなシーケンスを実現するのに効果的な場合が多い。そして、節約した費用を品質保証に充てる。
クリップ戦略(量より多様性が重要)
多くの場合、より良い一般化は次のような方法で得られます。
- 単に類似の映像を何時間も追加するよりも、より多くの環境、照明、カメラアングル、そして特殊なケースを網羅できる。
ビデオ注釈の一般的な課題
動画アノテーションは、信頼性の高いコンピュータビジョンシステムを構築する上で、依然として最も困難な作業の一つです。最新のツールによって処理速度は向上しましたが、課題はもはや単に多くのフレームにラベルを付けることではありません。現在、チームは正確で一貫性があり、追跡可能で、現実世界の状況を反映したアノテーション付き動画データを必要としています。業界の指針では、自動化、人間によるレビュー、そしてガバナンスの組み合わせが最も効果的な道筋であるとますます指摘されています。

1. 大量かつ時間のかかるワークフロー
動画は膨大な量のデータを生成します。1つのプロジェクトには数千ものクリップ、1フレームあたり複数のオブジェクト、そして一貫した追跡が必要な長い時間シーケンスが含まれる場合があります。自動追跡や補間機能を使用しても、チームは依然として、難しいシーンの検証、ドリフトの修正、および特殊なケースの確認のために、人間のレビューを必要とします。
2. フレーム間で注釈の精度を維持する
動画における精度は、画像における精度よりも難しい。なぜなら、ラベルは1フレームだけでなく、時間経過とともに正確さを維持する必要があるからだ。オブジェクトが高速で移動したり、形状が変化したり、消えたり現れたりすると、バウンディングボックス、ポリゴン、キーポイント、イベントタグなどが容易に不整合になる可能性がある。そのため、高いパフォーマンスを発揮するチームは、1回のラベリング作業に頼るのではなく、明確なガイドライン、定期的な監査、合意形成チェックといった手法を採用している。
3. オクルージョン、モーションブラー、シーンの複雑さ
実際の映像は複雑です。物体は部分的に隠れていたり、照明が不十分だったり、混雑していたり、高速で動いていたりすることがよくあります。このような状況ではラベル付けが難しくなり、データセット内で一貫して処理されないとモデルの品質が低下する可能性があります。近年の研究やツール開発の動向を見ると、遮蔽を考慮したアノテーションやエッジケース処理への注目が高まっています。これは、こうした状況こそが実運用モデルが失敗する主な原因だからです。
4. 品質を犠牲にすることなく拡張性を実現する
アノテーターを増やすことでラベル付けプロジェクトを拡張するのは比較的容易ですが、一貫性を維持しながら拡張するのははるかに困難です。プロジェクトが拡大するにつれて、チームはラベルのずれ、レビュー担当者の不一致、バッチ間の品質のばらつきといった問題に直面することがよくあります。最も効果的なワークフローは、スピードのための自動化と、人間による検証、ゴールドスタンダードとなるレビューセット、そしてアノテーター間の測定可能な一致を組み合わせたものです。
5. データセットの偏りと不完全なエッジケースの網羅
クリーンで反復的な映像で学習させたモデルは、テストでは良好な結果を示すかもしれませんが、本番環境では失敗する可能性があります。ビデオデータセットには、実際の展開状況を反映するために、照明、天候、カメラアングル、地理的条件、人口統計、まれな事象など、十分なバリエーションが含まれている必要があります。NISTのAIリスクガイダンスも、コンテキストのマッピング、リスクの測定、下流への影響の管理の必要性を強調しており、データセットの設計はラベルの実行と同じくらい重要です。
6. データセキュリティ、プライバシー、およびコンプライアンス
動画には、顔、ナンバープレート、医療画像、職場の映像、顧客環境など、機密性の高いコンテンツが含まれていることがよくあります。そのため、アノテーションはデータガバナンス上の課題にもなります。プロジェクトによっては、GDPR、HIPAA、またはISO/IEC 27001などのより広範なセキュリティ管理規格に準拠したベンダーやプロセスが必要となる場合があります。
7. 文書化の不備と監査可能性の低さ
ラベル付きデータセットの有用性は、その指示と決定履歴によって決まります。アノテーションルールが不明確な場合、チームは大規模な環境で品質を再現するのに苦労します。最新のアノテーションプログラムでは、バージョン管理されたガイドライン、例外処理ルール、品質保証ログ、および文書化された受け入れ基準が必要です。これにより、一貫性のない正解データに基づいてモデルを再学習させるのではなく、反復的に改善していくことができます。
適切なビデオラベル作成ベンダーの選び方
 動画ラベリングベンダーの選定は、もはや価格だけの問題ではありません。適切なパートナーは、データセットの品質向上、イテレーションサイクルの短縮、モデルリスクの低減に貢献してくれるはずです。実際には、最適なベンダーとは、専門知識、安全な運用、拡張性の高い配信、そして測定可能な品質管理を、お客様の具体的なユースケースに合わせて組み合わせることができるベンダーです。
注釈能力だけでなく、ドメイン知識も重視すべきだ。
ベンダーは一般的なバウンディングボックスの抽出には優れていても、医療画像処理、自動運転、小売行動分析、産業検査といった分野では弱点を持つ場合があります。貴社のオントロジー、モデルの目的、そして導入環境において重要なエッジケースを理解しているパートナーを選びましょう。ドメインへの精通は、通常、より良いガイドライン、手戻りの削減、そしてラベルの一貫性の向上につながります。
彼らの品質保証システムを評価する
ベンダーが注釈の品質をどのように測定しているかを尋ねてください。優れたベンダーは通常、多段階の品質保証、レビュー担当者によるエスカレーション、ゴールドスタンダードとなるベンチマーク、そして必要に応じて注釈者間の合意確認などを実施します。品質が一般的な用語でしか説明されておらず、測定可能なワークフローと結びついていない場合は、注意が必要です。
ヒューマン・イン・ザ・ループ・ワークフローをサポートしていることを確認してください。
現代のビデオラベリングは、完全に手動で行うべきではなく、完全に自動化するべきでもありません。優れたプロバイダーは、モデル支援による事前ラベリング、オブジェクトトラッキング、補間、そして専門家によるレビューを組み合わせています。このハイブリッドアプローチにより、通常は処理速度が向上し、難しいフレームや曖昧なイベントにおいても精度が維持されます。
セキュリティとコンプライアンスへの準備状況を確認する
データに個人情報、医療情報、財務情報、または規制対象コンテンツが含まれる場合、セキュリティ対策は後回しにできません。アクセス制御、監査証跡、データ分離、データ保持ポリシーについて確認し、ベンダーがGDPR、HIPAA、ISO/IEC 27001準拠などの貴社ビジネスに関連する要件に対応できるかどうかを確認してください。
拡張性と事業再生の現実性を評価する
ベンダーは、品質を低下させることなく、パイロット段階から本番環境への移行をスムーズに行える能力を備えている必要があります。急激な生産量増加、多言語・多地域対応プログラム、レビュー担当者のトレーニング、特殊なケースへの対応方法などを尋ねてください。低価格の見積もりは、後工程での遅延、ラベルの貼り替え、モデルの再トレーニング費用が発生するようでは役に立ちません。
ツール、統合、監査可能性について質問してください
優れたベンダーは、最新のアノテーションプラットフォームと円滑に連携し、クリーンなエクスポート、タクソノミーのバージョン管理、および品質保証レポートをサポートする必要があります。ラベル付けされた内容、ラベル付けを行った担当者、ガイドラインのバージョン、および紛争解決方法を追跡できる必要があります。このような可視性は、モデルのデバッグと継続的なMLOpsの改善に不可欠です。
Shaipが動画注釈プロジェクトをどのようにサポートするか
Shaipは、データ収集、フレームおよびイベントのラベリング、オブジェクトトラッキング、セグメンテーション、時間的タグ付け、品質レビューなど、ビデオ注釈プロジェクトをサポートします。また、必要に応じて個人情報をマスキングまたはぼかすなど、匿名化機能を備えた機密性の高いビデオワークフローもサポートします。Shaipは、コンピュータビジョン、ヘルスケアAI、マルチモーダルAI、空間AIプロジェクトなど、幅広いユースケースに対応し、ライセンスデータセット、トランスクリプトのアライメント、メタデータのエンリッチメントといった関連サービスもサポートします。

結論
動画アノテーションは、技術面だけでなく、プロジェクトに携わるチームにも大きく左右されます。動画アノテーションは、様々な業界に数多くのメリットをもたらします。しかし、経験豊富で有能なアノテーターの協力がなければ、世界レベルのモデルを構築することは難しいでしょう。
高度なコンピュータビジョンベースのAIモデルを導入する際は、Shaipをサービスプロバイダーとして選ぶべきです。動画アノテーションの品質と精度に関しては、経験と信頼性が非常に重要です。それはプロジェクトの成功に大きく影響します。
Shaipでは、複雑さや要件の異なる様々なビデオ注釈プロジェクトに対応できる豊富な経験を有しています。経験豊富な注釈担当者チームがお客様のプロジェクトに合わせたサポートを提供し、専門家による監督体制により、短期および長期的なニーズにお応えします。当社は、納期、精度、一貫性を損なうことなく、厳格なデータセキュリティ基準に準拠した最高品質の注釈のみを提供します。