機械学習モデルのトレーニングのためのAIデータ収集サービス

150以上の言語にわたる500万人の厳選された貢献者から提供された、カスタムテキスト、画像、音声、ビデオのデータセット。
データ収集サービス
グーグル Microsoft アマゾンウェブサービス

フルマネージドデータ収集サービス

データはあらゆる組織の成功にとって最も重要であるため、AI チームは平均して時間の 80% を AI モデル用のデータの準備に費やしていると推定されています。

Shaipチームは、独自のデータ収集ツール(AndroidおよびiOS対応のモバイルアプリ)を活用し、世界中のデータ収集担当者を擁する組織を管理することで、お客様のAIおよび機械学習プロジェクトに必要なトレーニングデータを収集します。当社のAIツールは、データ収集と整理のプロセスを効率化し、プラットフォーム間でのシームレスな統合とコラボレーションを実現します。幅広い年齢層、人口統計、教育背景を持つ人々からデータを収集することで、最も要求の厳しいAIプロジェクトにも対応できる、大量の機械学習データセットの収集を支援します。Shaipは、データ収集の全過程においてお客様をサポ​​ートし、AIプロジェクトの開発、展開、管理における効率的なプロセスの重要性を強調することで、お客様が成果に集中し、AIプロジェクトを前進させることを可能にします。

デルタのコミュニティ

当社では、アクティブで精査された熟練の AI データ スペシャリスト コミュニティによって収集、注釈付け、検証され、お客様の特定の機械学習プロジェクト要件に合わせて調整された AI トレーニング データを提供します。

クラウド規模の貢献者
0 +
社内グローバル人材
0 +
言語と方言
0 +
事業国
0 +

AIデータ収集とは何ですか?

AIデータ収集とは、機械学習モデルのトレーニングに使用される大量のテキスト、画像、音声、動画データを収集・準備するプロセスです。Shaipは、150以上の言語に対応する500万人の貢献者からなる厳選されたグローバルコミュニティを通じてカスタムデータセットを調達し、アノテーション、検証、規制遵守を組み込んだ、完全管理型のAIデータ収集サービスを提供しています。

プロフェッショナルなデータ収集ソリューション

任意の主題。 任意のシナリオ。

人間のインタラクションの追跡から顔画像の収集、感情の測定まで、当社のソリューションは、機械学習モデルのトレーニングを目指す企業にとって重要な機械学習データセットを提供します。様々なソースからデータポイントを収集することで、モデルの精度と様々なアプリケーション間での再利用性を向上させます。データ収集サービスのリーダーとして、当社はお客様が複数のデータタイプにわたる大量の高品質トレーニングデータを取得し、独自のシナリオ設定や複雑なアノテーションを含む複雑なAIプロジェクトを管理できるよう支援します。これらのデータは、包括的なAIモデルトレーニングに不可欠です。

一度限りのプロジェクトであっても、継続的にデータが必要な場合でも、当社の経験豊富なプロジェクト マネージャー チームがプロセス全体がスムーズに実行されるようにします。

配信されるAIデータの種類

テキストデータ
音声データ
画像データ
ビデオデータ
プロフェッショナルなデータ収集ソリューション

自然言語処理用のテキストデータセット

Shaipのコグニティブテキストデータ収集サービスの真の価値は、非構造化テキストデータの奥深くに隠された重要な情報を解き明かす鍵を組織に提供することにあります。非構造化テキストの形でデータが到着すると、分析によってパターンが特定され、NLPアプリケーションに役立つ貴重な洞察が抽出されます。この非構造化データには、医師のメモ、個人財産の保険金請求、銀行の記録などが含まれます。人間の言語を理解する技術の開発には、大量のテキストデータ収集が不可欠です。当社のサービスは、高品質なNLPデータセットを構築するための幅広いテキストデータ収集サービスを提供しています。

テキストデータ収集

テキストデータ収集サービス

ドメイン固有の多言語テキストデータ(名刺データセット、ドキュメントデータセット、メニューデータセット、受信データセット、チケットデータセット、テキストメッセージ)のコレクションを使用して自然言語処理を開発し、非構造化データの奥深くにある重要な情報のロックを解除して、さまざまな問題を解決します。ユースケース。 テキストデータ収集会社であるShaipは、さまざまなタイプのデータ収集および注釈サービスを提供しています。 といった:

詳細はこちら➔

受信データセットの収集

領収書データ収集

インターネットの請求書、ショッピングの請求書、タクシーの領収書、ホテルの請求書など、さまざまな種類の請求書を世界中から必要に応じて言語で収集するお手伝いをします。
チケットデータセットの収集

チケットデータセットコレクション

カスタム仕様に基づいて、世界中からさまざまな種類のチケット、つまり航空券、鉄道チケット、バスチケット、クルーズチケットなどを調達するお手伝いをします。

Ehrデータ収集

EHRデータと医師の口述筆記録

放射線学、腫瘍学、病理学など、さまざまな専門分野の既製のEHRデータと医師の口述筆記録を提供できます。
ドキュメントデータセットコレクション

ドキュメントデータセットコレクション

ML モデルのトレーニングに必要な、さまざまな地域や言語からの運転免許証やクレジットカードなどのあらゆる種類の重要な文書の収集をお手伝いします。

自然言語処理のための音声データセット

Shaipは、150以上の言語に対応したエンドツーエンドの音声データ収集サービスを提供しており、音声対応テクノロジーが世界中の多様なユーザー層に対応できるよう支援しています。進化するNLPアプリケーションにおいて、音声データセットの関連性と正確性を維持するには、最新のデータを継続的に収集することが不可欠です。Shaipは、既存の音声データセットのライセンス供与から、カスタム音声データ収集の管理、音声の書き起こしやアノテーションまで、あらゆる範囲と規模のプロジェクトに対応可能です。新しく多様な音声データを取り込むことで、既存のモデルを改善し、パフォーマンスと適応性を向上させることができます。音声データ収集プロジェクトの規模に関わらず、お客様のニーズに合わせて音声収集サービスをカスタマイズし、高品質のNLPデータセットを構築いたします。

音声データ収集サービス

私たちは、会話型AIとチャットボットのトレーニングと改善のための音声/音声データ収集のリーダーです。 150を超える言語と方言、アクセント、地域、音声タイプからデータを収集し、(発話を使用して)転記し、タイムスタンプを付けて分類することができます。 当社が提供するさまざまなタイプの音声データ収集および注釈サービス:

詳細はこちら➔

独白スピーチ

モノローグスピーチコレクション

個々の話者から、台本付き、ガイド付き、または自発的な音声データセットを収集します。話者は、年齢、性別、民族、方言、言語など、お客様のカスタム要件に基づいて選択されます。

対話スピーチ

対話スピーチコレクション

カスタム要件に基づいて、またはプロジェクトで指定されているように、ガイド付きまたは自発的な音声データセット/コールセンターエージェントと発信者または発信者とボット間の相互作用を収集します。

音響音声

音響データ収集

私たちは、レストラン、オフィス、家庭、またはさまざまな環境や言語からのスタジオ品質のオーディオデータを、協力者のグローバルネットワークを通じて専門的に録音できます。
自然言語の発話

自然言語発話コレクション

Shaipは、さまざまな自然言語の発話を収集して、ローカルおよびリモートスピーカーからの100以上の言語と方言の音声サンプルを使用してオーディオベースのMLシステムをトレーニングする豊富な経験を持っています。

コンピュータビジョンの画像データセット

機械学習(ML)モデルの良し悪しは、学習データの品質に左右されます。そのため、私たちはお客様のMLモデルに最適な画像データセットを提供することに注力しています。これらの画像データセットは、コンピュータービジョンアプリケーション向けのAIモデルや機械学習アルゴリズムの学習に不可欠であり、正確なデータ駆動型予測と実世界への展開を可能にします。当社の画像データセット収集ツールは、お客様のコンピュータービジョンプロジェクトを実世界で機能させるお手伝いをします。当社のエキスパートは、お客様のあらゆる仕様や状況に合わせて画像コンテンツを収集いたします。

画像データ収集サービス

画像分類、画像セグメンテーション、顔認識などのさまざまなユースケースの画像データセット(医療画像データセット、請求書画像データセット、顔データセットコレクション、または任意のカスタムデータセット)を大量に収集することで、機械学習機能にコンピュータービジョンを追加します、など。当社が提供するさまざまなタイプの画像データ収集および注釈サービス:

詳細はこちら➔

財務文書の注釈

ドキュメントデータセットコレクション

運転免許証、身分証明書、クレジットカード、請求書、領収書、メニュー、パスポートなど、さまざまなドキュメントの画像データセットを提供します。

顔認識

顔のデータセットコレクション

当社は、さまざまな民族、年齢、性別などから収集した顔の特徴や表情で構成されるさまざまな顔画像データセットを提供しています。
医療データのライセンス

ヘルスケアデータ収集

当社は、放射線学、腫瘍学、病理学などのさまざまな医療専門分野からの CT スキャン、MRI、超音波、X 線などの医療画像を提供しています。
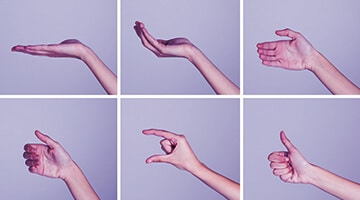
手のジェスチャー

ハンドジェスチャデータ収集

私たちは、世界中の人々、複数の民族、年齢層、性別などからのさまざまな手のジェスチャーの画像データセットを提供しています。

コンピュータビジョン用のビデオデータセット

動画内の各オブジェクトをフレームごとにキャプチャし、動いているオブジェクトを撮影してラベル付けし、機械が認識できるようにします。機械学習モデルのトレーニングに必要な高品質な動画データセットの収集は、常に厳格で時間のかかるプロセスであり、その多様性と膨大なデータ量によって複雑さはさらに増します。Shaipは、動画データ収集サービスに必要な専門知識、知識、リソース、そしてスケールを提供します。Shaipの動画は最高品質で、お客様固有のユースケースに合わせてカスタマイズされており、コンピュータービジョンの特定のタスク向けにモデルをトレーニングするために設計された動画データセットを備えています。

ビデオデータ収集サービス

機械学習モデルの学習に活用できる、CCTV映像、交通ビデオ、監視ビデオなどの実用的なトレーニングビデオデータセットを収集します。各データセットは、お客様の要件に合わせてカスタマイズされます。当社のビデオデータ収集ツールを活用することで、様々な種類のデータの収集とアノテーションサービスをご提供します。

詳細はこちら➔

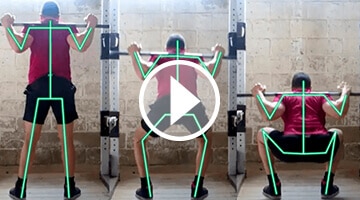
人間の姿勢ビデオ

人間の姿勢のビデオデータセットコレクション

さまざまな照明条件とさまざまな年齢層での歩行、座位、睡眠など、さまざまな人間の姿勢のビデオデータセットを提供しています。

ドローンと空撮ビデオ

ドローンと空中ビデオデータセットコレクション

交通、スタジアム、群衆などのさまざまなインスタンスにドローンを使用した航空写真付きのビデオデータを提供します。
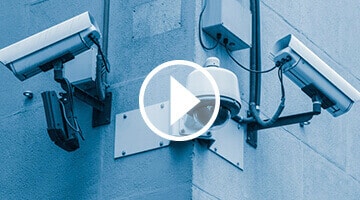
防犯カメラ監視

CCTV /監視ビデオデータセット

法執行機関が犯罪歴のある人物を訓練および特定するために、セキュリティカメラから監視ビデオを収集できます。

交通ビデオ データセット

交通ビデオデータセットコレクション

さまざまな照明条件と強度の下で複数の場所から交通データを収集して、MLモデルをトレーニングできます。
カスタマイズされたデータ収集サービス

オンサイトデータ収集サービス

オンサイトデータ収集サービス

ご希望の場所でデータを収集する必要がありますか? 当社では、お客様の特定の要件に合わせてカスタマイズされたクラウドソーシング ソリューションを備えた、カスタマイズされたオンサイト データ収集サービスを提供しています。

  • 現場での生体認証データ収集
  • フィールドベースの音声データ収集
  • オンサイト注釈およびラベル付けプロジェクト

クラウドソースによるデータ収集

クラウドソースによるデータ収集

多様で大規模なデータセットをお探しですか? 当社のグローバル クラウドソーシング ネットワークは、高速でスケーラブル、かつ多様なデータ収集ソリューションを提供しており、幅広い入力を必要とするプロジェクトに最適です。

  • 音声コマンドとウェイクワードの録音
  • オブジェクトと製品の画像キャプチャ
  • 人間の活動のビデオ録画

デバイス固有のデータ収集

デバイス固有のデータ収集

独自のテクノロジーに合わせたデータが必要ですか? 当社は、AI と機械学習のニーズに合わせて正確で適切な入力を確保するために、特定のデバイスからデータを収集することに特化しています。

  • 特定のモバイルデバイスからの画像キャプチャ
  • カスタムカメラを使用したビデオデータ収集

環境固有のデータ収集

環境固有のデータ収集

制御された環境または独自の環境からのデータが必要ですか? お客様の特殊な要件を満たすために、特定の設定からコンテキストが豊富なデータセットを収集します。

  • スタジオベースの音声録音
  • 騒音環境での音声データ収集
  • 車載ビデオデータ収集

私たちの業界の専門知識

AIデータ収集サービスは、リアルタイムデータ処理やAIを活用した自動化といった、パーソナライズされた効率的なソリューションを実現することで、これらの業界の顧客体験向上を支援します。高度なAIデータ収集を活用することで、企業はイノベーションと意思決定の改善を通じて、それぞれの業界で優位性を維持できます。当社のヒューマン・イン・ザ・ループ型データ収集サービスは、以下のような業界向けに高品質なトレーニングデータを提供します。

テクノロジー

テクノロジー

健康

健康

ファッションと e コマース - 画像ラベル付け

小売商

自動運転車

自動車

金融

金融

政府・公共機関向け

政府・公共機関向け

他のデータ収集会社よりもShaipを選ぶ理由

AIイニシアチブを効果的に展開するには、大量の専門的なトレーニングデータセットが必要です。Shaipは、AIおよびMLプロジェクトにおいて、データが効率的に整理、保存、取得されるよう、堅牢な管理手法を採用しています。Shaipは、規制およびGDPRの要件に準拠しながら、世界クラスの信頼性の高い大規模なAIトレーニングデータを提供する、市場でも数少ない企業の一つです。

データ収集機能

カスタム ガイドラインに基づいて、世界中からカスタム構築されたデータセット (テキスト、音声、画像、ビデオ) を作成、キュレート、収集します。

柔軟なグローバル人材

10,000万人を超える社内グローバル人材と、500万人を超えるクラウドソーシングによる資格保有者を活用します。リアルタイムでの人材キャパシティと効率性を実現します。

品質

当社独自のプラットフォームと熟練した労働力は、複数の品質管理方法を使用して、品質基準を満たすか、それを上回ります。

多様で、正確で、速い

当社のプロセスは、タスクの配布を容易にし、アプリや Web から直接データを取得することで、収集プロセスを合理化します。

データセキュリティ

プライバシーを優先することにより、完全なデータの機密性を維持します。 データ形式がポリシーで管理され、保持されていることを確認します。

エンドツーエンド注釈

収集されたすべてのデータセットは、同一のワークフロー内で注釈付け、ラベル付け、文字起こし、検証を行うことができ、モデル構築にすぐに使用できるトレーニングデータが得られます。

データ収集プロセス

データ収集プロセスは、人工知能(AI)および機械学習(ML)ソリューションの開発における基礎的な要素です。このプロセスは、カスタムデータ収集と既存データソースという2つの主要なアプローチを通じて、関連データの特定と収集から始まります。カスタムデータ収集では、フリーランサー、クラウドソーシング、社内チーム、フィールドコレクターなどを活用し、特定のプロジェクト要件に合わせたデータを収集します。一方、既存データは、社内データベース、外部データリポジトリ、ソーシャルメディアプラットフォーム、公開コンテンツのウェブスクレイピングなどから取得できます。場合によっては、組織はAIが生成した合成データを利用して、実世界のデータセットを補完・多様化することもあります。

このプロセスにおいて極めて重要な点は、最初からデータの正確性を確保することです。収集されたデータの品質は、AIモデルの有効性に直接影響するからです。データが収集されると、データ前処理、つまり生データのクリーニング、変換、整理といった一連の手順が実行されます。この段階は、ノイズの除去、欠損値の修正、データ形式の標準化に不可欠であり、AIアルゴリズムによる分析に適した情報へと仕上げます。
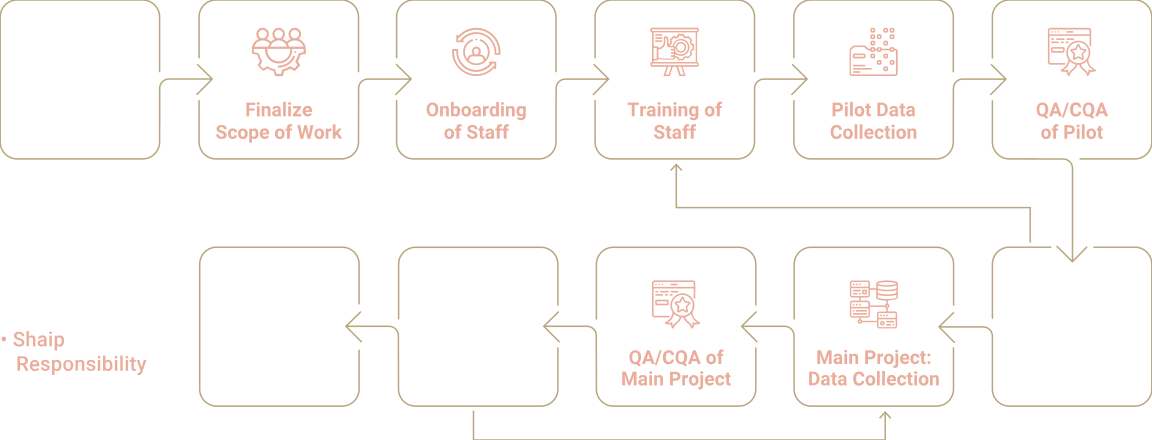
データ収集プロセス

データ収集ツール

ShaipCloud独自のデータ収集ツールは、世界中のデータ収集チームへの様々なタスク配分を効率化するように設計されています。アプリのインターフェースにより、データ収集・アノテーションサービスプロバイダーは、割り当てられた収集タスクを容易に確認し、詳細なプロジェクトガイドライン(サンプルを含む)を確認し、プロジェクト監査人の承認を得るためにデータを迅速に提出・アップロードできます。アプリはWeb、Android、iOSでご利用いただけます。

専門: データカタログとライセンス

ヘルスケア/医療データセット

当社の匿名化された臨床データセットには、心臓病学、放射線学、神経学など、31 の異なる専門分野のデータが含まれています。

データセットを表示

音声/音声データセット

60以上の言語で高品質の厳選された音声データを入手する

データセットを表示

コンピュータビジョンデータセット

ML開発を加速するための画像とビデオのデータセット。

データセットを表示

セキュリティ&コンプライアンス

GDPR
HIPAA
ISO 9001:2015
SOC2タイプII
ISO 27001
シャイプにお問い合わせください

独自のデータセットを作成したいですか?

独自のAIソリューションのカスタムデータセットを収集する方法については、今すぐお問い合わせください。

  • このフィールドは、検証目的のためであり、不変のままにする必要があります。
  • 登録することで、Shaipに同意します プライバシーポリシー (NAIST) と 利用規約 ShaipからB2Bマーケティングコミュニケーションを受け取ることに同意します。

AIデータ収集とは、機械学習モデルのトレーニングに使用される大量のテキスト、画像、音声、動画データを収集・準備するプロセスです。モデルの精度、公平性、信頼性は、モデルがパターンを認識し、正確な予測を行うための学習に役立つ、多様で高品質かつ適切にラベル付けされたデータセットに依存するため、データ収集は不可欠です。

Shaipは、厳選された熟練の貢献者、独自のShaipCloudプラットフォーム、そして訓練を受けた監査担当者による複数段階の品質管理を通じて、品質を保証します。すべてのデータセットは、納品前に検証、クリーニング、注釈付けが行われ、正確性、多様性、コンプライアンスが確認されます。

はい。Shaipは、GDPR、HIPAA、および該当する地域のプライバシー規制に準拠してデータを収集および処理します。すべてのプロジェクトには、同意管理、個人情報の匿名化、およびワークフローに組み込まれた厳格な機密保持管理が含まれています。

Shaipは、人口統計、地域、言語、方言など、多様なデータセットを収集することで、データバイアスを低減します。バランスの取れたサンプリングと品質レビューにより、トレーニングデータが現実世界の多様性を反映していることが保証され、より公平で正確なモデルの構築が可能になります。

はい。Shaipは、対象となる人口統計、言語、環境、特殊なケースなど、お客様の厳密な仕様に基づいて、テキスト、画像、音声、動画など、あらゆる形式のカスタムデータセットを作成します。既製のデータではモデルの要件を満たせない場合は、データセットをゼロから収集します。

はい。Shaipは、生体認証データ、音声録音、スタジオ、車両、騒音の多い場所など、実際の環境で取得される環境固有のデータセットなど、現場およびフィールドベースのデータ収集を提供します。

費用はデータの種類、量、複雑さ、カスタマイズ内容によって異なります。Shaipは固定料金を公表しておりません。お客様のAIプロジェクトに合わせたお見積もりについては、お問い合わせください。

企業は、クラウドソーシング、フィールドコレクター、社内チームなどによる独自の収集方法、または既存のソースのライセンス取得によって、AIデータセットを収集します。収集されたデータは、モデルトレーニングのために前処理、検証、注釈付けが行われます。Shaipは、ShaipCloudプラットフォームを通じて、このパイプライン全体をエンドツーエンドで管理します。

Shaipへのアウトソーシングは、エンジニアリング時間の節約、専門家による品質保証、そして10,000万人を超える社内グローバル人材と500万人を超えるクラウドソーシングによる貢献者へのアクセスを可能にし、社内にデータ収集能力を構築することなく、多様でモデル化可能なデータを安全に提供します。

はい。Shaipは、10,000万人を超える社内グローバル従業員と500万人を超えるクラウドソーシングによる貢献者を活用し、人口統計、言語、地域を問わず、大規模で多様なデータセットを迅速に収集します。

はい。Shaipは、AIが生成した合成データで実世界のデータセットを拡張し、大規模な言語モデルや生成モデルの微調整に役立つプロンプト・レスポンスペアやRLHFデータを提供することができます。これは、実データが不足している場合やプライバシーに配慮が必要な場合に役立ちます。

Shaipは独自のShaipCloudプラットフォームを使用して、タスクの割り当て、注釈付け、品質管理を行っています。Web、Android、iOSからアクセス可能で、作業員の能力とプロジェクトの進捗状況をリアルタイムで把握できます。

はい。Shaipは、注釈付け、ラベル付け、文字起こし、検証など、エンドツーエンドのサービスを提供するため、収集されたデータは別のベンダーに渡すことなく、モデルにすぐに使用できる状態で出荷されます。

Shaipは、ヒンディー語、アラビア語、スペイン語、中国語、英語、フランス語など、150以上の言語と方言でのデータ収集をサポートしています。