AIによるデータ収集:その概要と仕組み

プロセス、方法、ベスト プラクティス、利点、課題、コスト、実際の例、適切なデータ収集パートナーの選択方法について学習します。

目次

電子ブックを ダウンロード

データ収集 bg_tablet

イントロダクション

Aiトレーニングデータ

人工知能(AI)は今や日常業務の一部となっており、チャットボット、コパイロット、テキスト、画像、音声を扱うマルチモーダルツールなどに活用されています。導入は加速しており、マッキンゼーの報告によると、組織の88%が少なくとも1つの業務機能でAIを使用しています。市場の成長も加速しており、ある試算では、AI市場は2025年には約390.9億ドル、 2033年には3兆5000億ドルに達すると予測されています。

優れたAIシステムの根底には、必ず共通する基盤があります。それは、高品質なデータです。このガイドでは、適切なデータを収集し、品質とコンプライアンスを維持し、AIプロジェクトに最適なアプローチ(社内開発、外部委託、ハイブリッド)を選択する方法について解説します。

AIデータ収集とは何ですか?

AIデータ収集とは、適切なシグナルを収集し、それらをクリーニングおよび構造化し、メタデータを追加し、必要に応じてラベル付けすることで、モデルのトレーニングと評価に適したデータセットを構築するプロセスです。単に「データを取得する」だけではありません。データの関連性、信頼性、実社会での使用に十分な多様性、そして後々の監査に十分な文書化を保証することも重要です。

AIプロジェクトで最も一般的なデータ形式

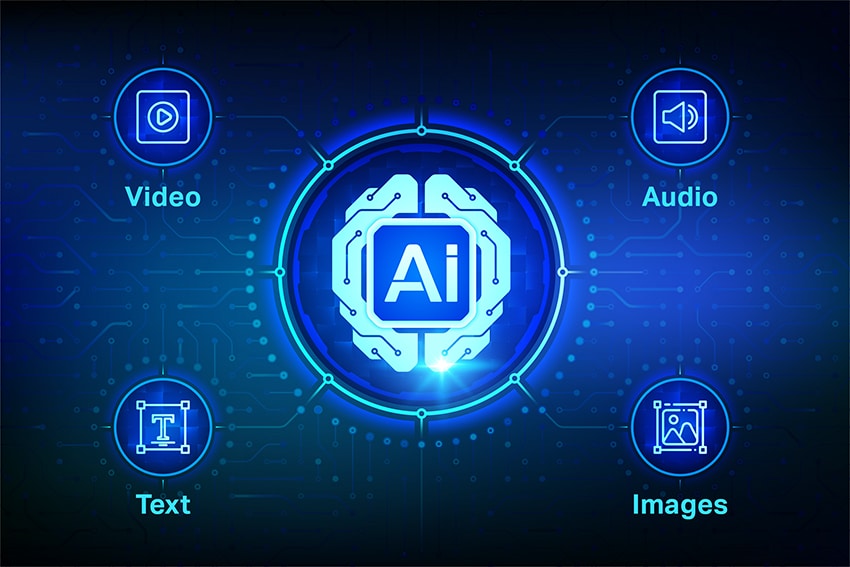
AI データセットは通常、構築するシステムに応じて 4 つの主要なカテゴリに分類されます。

  • テキストデータ: テキストは、トレーニングデータとして最も広く使われている形式の一つです。 構造化された (テーブル、データベース、CRMレコード、フォーム)または 非構造化 (メール、チャットログ、アンケート、ドキュメント、ソーシャルメディアのコメントなど)。LLMやチャットボットの場合、テキストデータにはナレッジベースの記事、サポートチケット、質問と回答のペアが含まれることがよくあります。
  • 音声データ: 音声データは、音声アシスタント、通話分析、音声チャットボットなどの音声システムの学習と改善に役立ちます。これらのデータセットは、アクセント、発音、背景雑音、同じ質問をする人の様々な言い方など、現実世界の様々な変化を捉えます。一般的な例としては、コールセンターの録音、音声コマンド、多言語音声サンプルなどが挙げられます。
  • 画像データ: 画像データセットは、物体検出、医用画像解析、小売製品認識、ID認証といったコンピュータービジョンのユースケースを支える基盤となります。画像には、モデルが画像から何を捉えているかを学習するために、タグ、境界ボックス、セグメンテーションマスクなどのラベルが必要になることがよくあります。
  • ビデオデータ: 動画は基本的に時間の経過に伴う一連の画像であり、動きや状況をより深く理解するのに役立ちます。動画データセットは、自動運転、監視分析、スポーツ分析、産業安全監視などのアプリケーションをサポートしており、フレームごとのラベル付けやイベントのタグ付けが必要となることがよくあります。

2026年には、AIのデータ収集は大きく変化します。なぜなら、多くのシステムがLLMチャットボット、RAG(検索拡張生成)、マルチモーダルモデルによって支えられているからです。つまり、チームは3種類のデータを並行して収集することになります。学習データ(行動を教えるため)、グラウンディングデータ(正確な回答のためのRAG対応ドキュメント)、そして評価データ(検索精度、誤検出、ポリシーとの整合性を測定するため)です。
Aiデータ収集

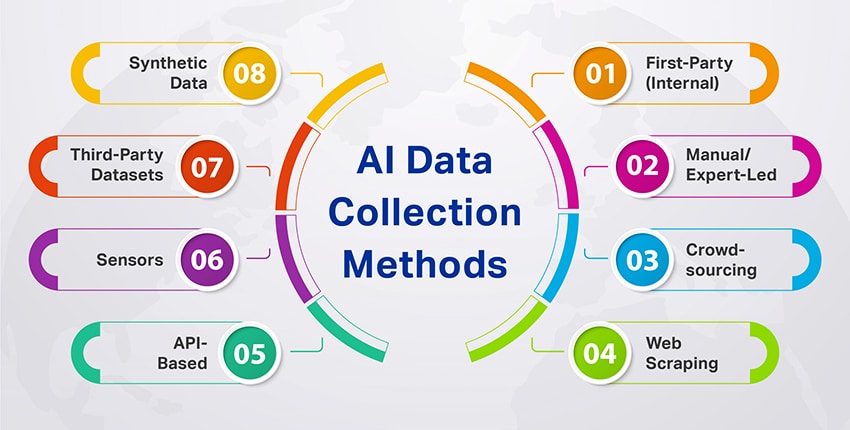
AIデータ収集方法の種類

AIデータ収集方法

1. ファーストパーティ(内部)データ収集

独自の製品、ユーザー、運用から収集されたデータは、実際の行動を反映しているため、通常は最も価値があります。

例:サポートチケット、検索ログ、チャットボットの会話を(同意を得た上で)エクスポートし、問題の種類ごとに整理して、LLMサポートアシスタントの性能向上に役立てる。

2. 手動/専門家主導の収集

人間は、深いコンテキスト、ドメイン知識、または高い精度が必要な場合に、意図的にデータを収集または作成します。

例:医療従事者が医療報告書を精査し、重要な所見にラベルを付けて、医療NLPモデルを訓練する。

3. クラウドソーシング(分散型人材)

大規模な作業員プールを活用して、迅速かつ大規模なデータを収集またはラベル付けします。明確なガイドライン、複数のレビュー担当者、テスト問題を用いて品質を維持します。

例:クラウドワーカーが何千もの短い音声クリップを音声認識用に文字起こしし、精度を確認するための「ゴールド」テストクリップを使用します。

4. Webデータ収集(スクレイピング)

公開ウェブサイトから大規模な情報を自動抽出します(利用規約および法律で許可されている場合のみ)。このデータは多くの場合、徹底的なクリーニングが必要です。

例:メーカーのウェブページから公開されている製品仕様を収集し、整理されていないウェブコンテンツを製品マッチングモデル用の構造化されたフィールドに変換する。

5. APIベースのデータ収集

公式 API 経由でデータを取得すると、通常はスクレイピングよりも一貫性、信頼性、構造化が強化されたデータが提供されます。

例:金融市場のAPIを使用して、価格/時系列データを収集し、予測や異常検知に利用する。

6. センサーとIoTデータ収集

多くの場合、リアルタイムの意思決定のために、デバイスやセンサー (温度、振動、GPS、カメラなど) からの継続的なストリームをキャプチャします。

例:工場機械から振動信号と温度信号を収集し、保守ログを予知保全のためのラベルとして使用する。

7. サードパーティ/ライセンスデータセット

開発をスピードアップしたり、カバレッジのギャップを埋めたりするために、ベンダーやマーケットプレイスから既成のデータセットを購入したり、ライセンスを取得したりします。

例:多言語音声データセットのライセンスを取得して音声製品を発売し、その後、自社開発の録音を追加してユーザーのパフォーマンスを向上させる。

8. 合成データ生成

プライバシー制約、稀なイベント、またはクラスの不均衡に対処するために人工データを作成します。合成データは現実世界のパターンに照らして検証する必要があります。

例:実際の不正取引事例が限られている場合に、稀な不正取引パターンを生成することで検出精度を向上させる。

データ品質がAIの成功を左右する理由

AI 業界は転換点に達しています。基礎モデル アーキテクチャは収束しつつあります。しかし、データ品質は依然として、ユーザーを満足させる製品と不満を抱かせる製品を分ける主な要因となっています。

不適切なトレーニングデータのコスト

データ品質の低さは、モデルのパフォーマンスをはるかに超えた形で現れます。

モデルの不具合:幻覚、事実誤認、口調の不一致などは、トレーニングデータの不足に直接起因します。不完全な製品ドキュメントでトレーニングされたカスタマーサポートチャットボットは、誤った回答を自信を持って提供してしまうでしょう。

コンプライアンス上のリスク:許可なく収集されたデータセットや、ライセンスのない著作権で保護された素材を含むデータセットは、法的責任を生じさせます。2024年から2025年にかけて発生した複数の注目度の高い訴訟により、「知らなかった」という弁明は通用しないことが確立されました。

再トレーニングコスト:導入後にデータ品質の問題が発覚すると、高額な再トレーニングサイクルとロードマップの遅延が発生します。企業チームは、機械学習プロジェクト時間の40~60%をデータ準備と修正に費やしていると報告しています。

注目すべき品質シグナル

ベンダーから取得したデータでも社内ソースから取得したデータでも、トレーニング データを評価する際には次の指標が重要になります。

  • 人口統計学的および言語的多様性: グローバル展開の場合、データは実際のユーザー ベースを表していますか?
  • 注釈の深さ: 注釈はバイナリ ラベルですか、それともニュアンスを捉える豊富な複数属性の注釈ですか?
  • ラベルの一貫性: 同じアイテムを 2 回レビューした場合、ラベルの一貫性は維持されますか?
  • エッジケースカバレッジデータには、まれではあるものの重要なシナリオが含まれていますか、それとも「ハッピーパス」のみですか?
  • 時間的関連性: データはあなたのドメインに十分最新ですか? 金融やニュース指向のモデルには最新のデータが必要です。

データ収集プロセス: 要件からモデル対応データセットまで

スケーラブルなAIデータ収集プロセスは、繰り返し可能で、測定可能であり、コンプライアンスに準拠しています。これは、生のファイルを一度だけダンプすることではありません。ほとんどのAI/MLイニシアチブにおいて、最終目標は明確です。それは、チームが確実に再利用、監査、そして時間をかけて改善できる、機械学習に対応したデータセットです。
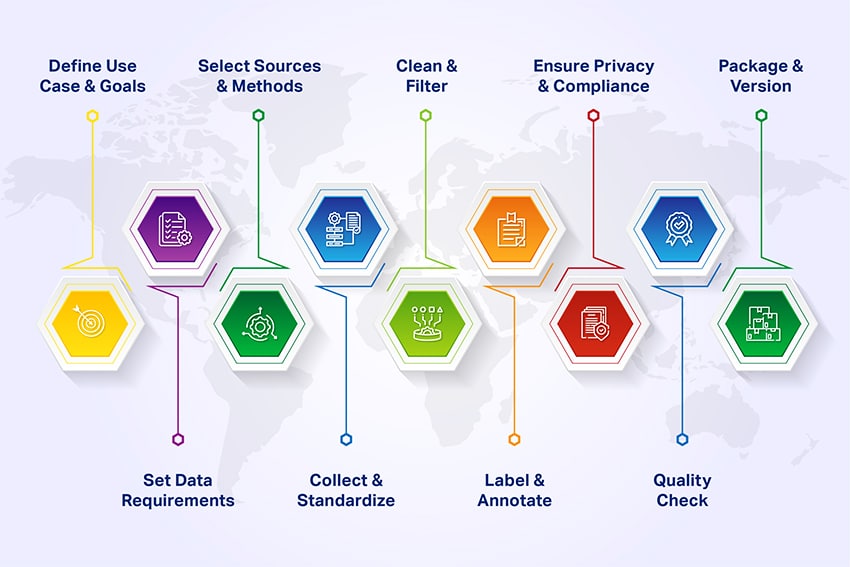
データ収集プロセス

1. ユースケースと成功指標を定義する

データではなくビジネスの問題から始めましょう。

  • このモデルはどのような問題を解決しますか?
  • 生産における成功はどのように測定されるのでしょうか?

例:

  • 「6 か月間でサポートのエスカレーションを 15% 削減します。」
  • 「上位 50 件のセルフサービス クエリの検索精度を向上します。」
  • 「製造における欠陥検出リコール率を 10% 向上させます。」

これらのターゲットは、後でデータの量、範囲、および品質のしきい値を決定します。

2. データ要件を指定する

ユースケースを具体的なデータ仕様に変換します。

  • データ型: テキスト、音声、画像、ビデオ、表形式、またはその組み合わせ
  • 音量範囲: 初期パイロットと完全展開(例:10K → 100K以上のサンプル)
  • 言語とロケール: 多言語、アクセント、方言、地域形式
  • 環境: 静か vs. 騒がしい、医療現場 vs. 消費者、工場 vs. オフィス
  • エッジケース: 見逃せない、稀だが影響力の大きいシナリオ

この「データ要件仕様」は、社内チームと外部データベンダーの両方にとって唯一の真実のソースになります。

3. 収集方法とソースを選択する

この段階では、データの取得元を決定します。通常、チームは主に以下の3つのソースを組み合わせます。

  • 無料/公開データセット: 実験やベンチマークには役立ちますが、ドメイン、ライセンスのニーズ、タイムラインと一致しないことがよくあります。
  • 内部データ: CRM、サポート チケット、ログ、医療記録、製品使用データなど、関連性は高いものの、生データであったり、情報がまばらであったり、機密情報であったりする場合があります。
  • 有料/ライセンスデータベンダー: ドメイン固有で、高品質で、注釈が付けられ、準拠した大規模なデータセットが必要な場合に最適です。

最も成功しているプロジェクトでは、次のものが組み合わされています。

  • プロトタイピングには公開データを使用します。
  • ドメインの関連性については内部データを使用します。
  • 社内チームに過負荷をかけずに、規模、多様性、コンプライアンス、専門家による注釈が必要な場合は、Shaip などのベンダーをご利用ください。

合成データは、いくつかのシナリオ(まれなイベント、制御された変動など)では現実世界のデータを補完することもできますが、現実のデータを完全に置き換えるものではありません。

4. データの収集と標準化

データが流れ始めると、標準化によって後で混乱を防ぐことができます。

  • 一貫したファイル形式を適用します (例: オーディオの場合は WAV、メタデータの場合は JSON、イメージングの場合は DICOM)。
  • 日付/時刻、ロケール、デバイス、チャネル、環境、同意ステータス、ソースなどの豊富なメタデータを取得します。
  • スキーマとオントロジーを整合します。ラベル、クラス、インテント、エンティティの名前と構造をどのように決定するかです。

優れたベンダーは、生の異種ファイルをチームにプッシュするのではなく、好みのスキーマでデータを配信します。

5. 洗浄とフィルター

生データは乱雑です。クリーニングすることで、有用で使用可能、かつ合法的なデータのみが処理されます。

一般的なアクションは次のとおりです:

  • 重複とほぼ重複の削除
  • 破損した、低品質の、または不完全なサンプルを除外する
  • 範囲外のコンテンツをフィルタリングする(言語、ドメイン、意図が間違っている)
  • フォーマットの正規化(テキストエンコーディング、サンプリングレート、解像度)

クリーニングは、社内チームが労力を過小評価しがちな部分です。このステップを専門業者にアウトソーシングすることで、市場投入までの時間を大幅に短縮できます。

6. ラベルと注釈を付ける(必要な場合)

教師ありシステムや人間が関与するシステムでは、一貫性のある高品質のラベルが必要です。

ユースケースに応じて、これには次のものが含まれます。

  • チャットボットとバーチャルアシスタントのインテントとエンティティ
  • 音声と通話の分析のためのトランスクリプトと話者ラベル
  • コンピュータビジョン用の境界ボックス、ポリゴン、またはセグメンテーションマスク
  • 検索およびRAGシステムの関連性判断とランキングラベル
  • ヘルスケアNLPのためのICDコード、薬剤、臨床概念

主な成功要因:

  • 明確で詳細な注釈ガイドライン
  • 注釈者向けのトレーニングと主題専門家へのアクセス
  • 曖昧なケースに対するコンセンサスルール
  • 一貫性を追跡するための注釈者間の合意の測定

ヘルスケアや金融といった専門分野では、一般的なクラウドアノテーションだけでは不十分です。中小企業の知見と監査済みのワークフローが不可欠です。まさにここで、Shaipのようなパートナーが価値をもたらします。

7. プライバシー、セキュリティ、コンプライアンス管理を適用する

データ収集は、初日から規制と倫理の境界を尊重する必要があります。

一般的なコントロールは次のとおりです:

  • 個人情報および機密データの非識別化/匿名化
  • 同意の追跡とデータ使用の制限
  • 保持および削除ポリシー
  • ロールベースのアクセス制御とデータ暗号化
  • GDPR、HIPAA、CCPA、業界固有の規制などの標準の遵守

経験豊富なデータ パートナーは、これらの要件を後付けとして扱うのではなく、収集、注釈、配信、およびストレージに組み込みます。

8. 品質保証と受け入れテスト

データセットが「モデル対応」と宣言される前に、構造化された QA を通過する必要があります。

一般的なプラクティス:

  • サンプリングと監査: 各バッチからのランダムサンプルを人間がレビュー
  • ゴールドセット: 注釈者のパフォーマンスを評価するために使用される、専門家によってラベル付けされた小規模な参照セット
  • 欠陥追跡: 問題の分類 (間違ったラベル、ラベルの欠落、フォーマットエラー、偏りなど)
  • 受け入れ基準: 精度、範囲、一貫性に関する事前定義されたしきい値

データセットがこれらの基準を満たしている場合にのみ、トレーニング、検証、または評価に進める必要があります。

9. 再利用のためのパッケージ、ドキュメント、バージョン

最後に、データは今日使用可能であり、明日も再現可能である必要があります。

ベストプラクティス:

  • 明確なスキーマ、ラベル分類、メタデータ定義を使用してデータをパッケージ化する
  • ドキュメントを含めます: データ ソース、収集方法、既知の制限、および使用目的。
  • バージョン データセット。これによりチームは、どのモデル、実験、またはリリースにどのバージョンが使用されたかを追跡できます。
  • シャドウ データセットや重複作業を回避するために、データセットを内部で (安全に) 検出できるようにします。

社内 vs. アウトソース vs. ハイブリッド: どのモデルを選択すべきでしょうか?

ほとんどのチームは、一つのアプローチを永久に採用するわけではありません。最適なモデルは、データの機密性、速度、規模、そしてデータセットの更新頻度(特にRAGや本番環境のチャットボットの場合)によって異なります。

モデル その意味 最適な時期 トレードオフ 典型的な2026年の現実
社内で あなたのチームは調達、収集、品質保証、そして多くの場合ラベル付けを担当します。 データは機密性が高く、ワークフローは独特で、強力な内部運用が存在します。 採用とツールの準備には時間がかかり、スケーリングは難しく、QA がボトルネックになる可能性があります。 安定したボリュームと厳格なガバナンス ニーズを持つ成熟したチームに適しています。
外注する ベンダーは、収集、ラベル付け、QA をエンドツーエンドで管理します。 スピード、グローバル規模、多言語対応、または専門的なデータ収集が必要です。 強力な仕様とベンダー管理が必要であり、ガバナンスは明確でなければなりません。 大規模な社内チームを構築せずにパイロットや急速な拡張を行うのに最適です。
ハイブリッド 繊細な戦略とガバナンスは社内で管理され、実行と拡張は外部委託されます。 制御とスピードが求められ、頻繁な更新が必要であり、コンプライアンスの制約もあります。 仕様、受け入れ基準、バージョン管理にわたって明確な引き継ぎが必要です。 LLM および RAG プログラムで最も一般的なエンタープライズ セットアップ。

データ収集の課題

失敗の多くは予測可能な課題から生じます。これらの課題には早めに対処しましょう。

  • 関連性のギャップ: データは存在しますが、実際のユースケースと一致しません (ドメインが間違っている、ユーザーの意図が間違っている、コンテンツが古い)。
  • カバレッジギャップ: 言語、アクセント、人口統計、デバイス、環境、または「まれだが重要な」シナリオが欠落しています。
  • バイアス: データセットは特定のグループまたは条件を過剰に代表しているため、代表されていないユーザーに対して不公平または不正確な出力が発生する可能性があります。
  • プライバシーと同意のリスク特に、チャット、音声、ヘルスケア、財務データなど、機密情報が表示される可能性がある場所では注意が必要です。
  • 出所とライセンスの不確実性: チームは、法的に再利用、共有、大規模展開できないデータを収集します。
  • 規模とタイムラインのプレッシャー: パイロットは成功しますが、量が増えて QA が追いつかなくなると、品質が低下します。
  • フィードバックループが欠落している: 運用監視を行わないと、データセットは現実(新しい意図、新しいポリシー、新しいエッジ ケース)と一致しなくなります。

データ収集の利点

この問題には信頼できる解決策があり、AIモデルのトレーニングデータを取得するためのより優れた安価な方法があります。 私たちはそれらをトレーニングデータサービスプロバイダーまたはデータベンダーと呼んでいます。

Shaipのような企業は、お客様固有のニーズと要件に基づいた高品質なデータセットの提供を専門としています。関連するデータセットの調達、クリーニング、コンパイル、アノテーションなど、データ収集に伴う煩雑な作業をすべてShaipに任せ、お客様はAIモデルとアルゴリズムの最適化に集中できます。データベンダーと連携することで、お客様は重要な点、そして自らがコントロールできる点に集中できます。

さらに、無料リソースや社内リソースからデータセットを取得する際の煩わしさも解消されます。エンドツーエンドのデータプロバイダーのメリットをより深く理解していただくために、以下に簡単なリストをご紹介します。

データ収集が適切に行われると、モデル メトリックを超えた成果が現れます。

  • モデルの信頼性の向上: 生産時の驚きが少なくなり、一般化が向上します。
  • 反復サイクルの高速化: クリーニングやラベル貼り直しの作業が少なくなります。
  • より信頼できるLLMアプリ: より良い根拠、より少ない幻覚、より安全な反応。
  • 長期的なコストの低減: 早期に品質を確保することで、下流での高額な修正を回避できます。
  • コンプライアンス姿勢の向上: より明確なドキュメント、監査証跡、および制御されたアクセス。


AIデータ収集の実際の例

AIによるデータ収集の実際の事例

例1:カスタマーサポートLLMチャットボット(RAG +評価)

  • DevOps Tools Engineer試験のObjective : チケットの量を減らし、セルフサービスによる解決を改善します。
  • Rescale データ: 厳選されたヘルプセンターの記事、製品ドキュメント、匿名化された解決済みチケット。
  • 余分: RAG 品質を測定するための構造化された検索評価セット (ユーザーの質問 → 正しいソース ドキュメント)。
  • アプローチ: 内部ドキュメントとベンダーがサポートする注釈を組み合わせて、意図にラベルを付け、質問を回答にマッピングし、検索の関連性を評価します。
  • 結果: より根拠のある回答、エスカレーションの削減、そして顧客満足度の目に見える形での向上を実現します。

例2: 音声アシスタント向け音声AI

  • DevOps Tools Engineer試験のObjective : さまざまな市場、アクセント、環境における音声認識を向上します。
  • Rescale データ: 多様な話者、環境 (静かな家、混雑した通り、車)、デバイスからの数千時間分の音声。
  • 余分: アクセントと言語のカバレッジ計画、標準化された転写ルール、および話者/ロケールのメタデータ。
  • アプローチ: 音声データプロバイダーと提携して、世界中から参加者を募集し、スクリプト付きおよびスクリプトなしのコマンドを記録し、完全に書き起こされ、注釈が付けられ、品質チェックされたコーパスを提供します。
  • 結果: 現実世界の状況での認識精度が向上し、非標準のアクセントを持つユーザーのパフォーマンスが向上します。

例3: ヘルスケアNLP(プライバシー優先)

  • DevOps Tools Engineer試験のObjective : 構造化されていないメモから臨床概念を抽出し、臨床上の意思決定をサポートします。
  • Rescale データ: 個人を特定できないようにされた臨床ノートとレポート。病状、薬剤、手順、検査値に関する SME による確認済みのラベルが追加されています。
  • 余分: HIPAA および病院のポリシーに準拠した厳格なアクセス制御、暗号化、監査ログ。
  • アプローチ: 専門の医療データベンダーを利用して匿名化、用語マッピング、ドメイン専門家の注釈付けを処理し、病院の IT スタッフと臨床スタッフの負担を軽減しました。
  • 結果: PHI を公開したりコンプライアンスを損なったりすることなく導入できる、高品質の臨床信号を備えたより安全なモデル。

例4:製造業におけるコンピュータビジョン

  • DevOps Tools Engineer試験のObjective : 生産ラインの欠陥を自動検出します。
  • Rescale データ: さまざまなシフト、照明条件、カメラアングル、製品バリエーションにわたる工場からの画像とビデオ。
  • 余分: 欠陥の種類に関する明確なオントロジーと、QA およびモデル評価のためのゴールド セット。
  • アプローチ: まれではあるものの重大な欠陥タイプを含む、「正常」製品と「不良」製品の両方に焦点を当てた、多様な視覚データを収集して注釈を付けました。
  • 結果: 欠陥検出における誤検知と誤検出が減り、自動化の信頼性が向上し、手動による検査の労力が削減されます。

AIデータ収集ベンダーを評価する方法
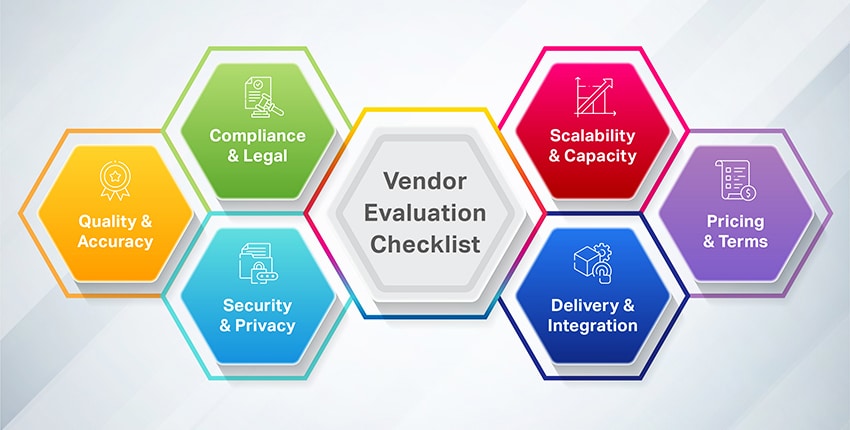
ベンダー評価チェックリスト

ベンダー評価チェックリスト

ベンダー評価中にこのチェックリストを使用します。

品質と精度

  • 文書化された品質保証プロセス(多層レビュー、自動チェック)
  • 注釈者間の合意指標が利用可能
  • エラー訂正とフィードバックループプロセス
  • コミットメント前のサンプルデータレビュー

コンプライアンスと法務

  • 明確なデータ来歴文書
  • データ主体に対する同意メカニズム
  • GDPR、CCPA、および関連する地域のコンプライアンス
  • 意図された使用をカバーするデータライセンス条件
  • データIP問題に関する補償条項

セキュリティ&プライバシー

  • SOC 2 タイプ II 認証(または同等)
  • 保管中および転送中のデータ暗号化
  • アクセス制御と監査ログ
  • 匿名化およびPII処理手順
  • データ保持および削除ポリシー

スケーラビリティと容量

  • 必要な規模での実績
  • 時間的制約のあるプロジェクトのための急増容量
  • 多言語・多地域対応
  • 対象分野における人材の深さ

配信と統合

  • APIアクセスまたは自動配信オプション
  • ML パイプラインとの互換性(フォーマット、スキーマ)
  • 修復手順を含む明確なSLA
  • 透明性の高いプロジェクト管理とコミュニケーション

価格と条件

  • 透明な価格モデル(ユニット単位、時間単位、プロジェクトベース)
  • 修正、フォーマット変更、急ぎの納品に隠れた料金はかかりません
  • 柔軟な契約条件(パイロット オプション、スケーラブルなコミットメント)
  • 成果物の明確な所有権

ベンダースコアリング基準

このテンプレートを使用して、ベンダーを体系的に比較します。

基準 重量 ベンダーA(1~5) ベンダーB(1~5) ベンダーC(1~5)
品質保証プロセス 20%
コンプライアンスと出所 20%
セキュリティ認証 15%
スケーラビリティと容量 15%
ドメインの専門知識 10%
価格の透明性 10%
配信と統合 10%
加重合計 100%

採点ガイド:

5 = 要件を超え、業界のリーダーシップを明確に示す。

4 = 強力な証拠により要件を完全に満たしています。

3 = 要件を適切に満たしている。

2 = 要件を部分的に満たしているが、ギャップが特定されている。

1 = 要件を満たしていません。

購入者からのよくある質問(Reddit、Quora、エンタープライズRFPコールより)

これらの質問は、業界フォーラムや企業の調達に関する議論で共通するテーマを反映しています。

「AIトレーニングデータのコストはいくらですか?」

料金はデータの種類、品質レベル、規模によって大きく異なります。シンプルなラベリング作業は1単位あたり0.02~0.10ドル程度ですが、複雑なアノテーション(医療、法務関連)は1単位あたり1~5ドルを超える場合があります。音声データと書き起こしは、1時間あたり5~30ドル程度かかる場合が多いです。品質保証、修正、納品費用を含むオールインワンの価格設定を必ずご確認ください。

「ベンダーのデータが本当に「クリーン」で合法的に取得されたものかどうか、どうすればわかるのでしょうか?」

出所に関する文書、ライセンス条件、同意記録の提出を求めましょう。具体的に「このデータセットのソース資料はどこから来たのか、そしてモデルのトレーニングに使用するにはどのような権利があるか」を尋ねましょう。信頼できるベンダーであれば、この質問に明確に答えることができます。

「合成データで十分でしょうか、それとも実際のデータが必要ですか?」

合成データは、拡張、エッジケース、プライバシーに配慮したシナリオにおいて有用です。ただし、文化的なニュアンス、言語的多様性、あるいは現実世界のエッジケースのカバレッジを必要とするタスクにおいては、主要なトレーニングソースとしては一般的に不十分です。これらのデータを組み合わせて使用​​し、適切な比率を把握することが重要です。

「10,000 ユニットの注釈プロジェクトの妥当な処理時間はどれくらいですか?」

標準的なアノテーション作業(キャリブレーションを含む)の場合、2~4週間かかります。複雑な分野や特殊な作業の場合は、4~8週間かかる場合があります。お急ぎの納品も可能ですが、通常、費用が25~50%増加します。

「契約前に品質を評価するにはどうすればよいですか?」

有償パイロットを強く推奨します。ベンダーがパイロット(たとえ小規模なものであっても)の実施を望まない場合は、警戒すべきです。パイロット期間中は、ベンダーが報告する指標だけに頼らず、独自の品質レビューを実施してください。

「最も重要なコンプライアンス認証は何ですか?」

SOC 2 Type IIは、企業のデータ処理における基本規格です。医療分野の場合は、HIPAA BAAについてご確認ください。EU域内での事業展開の場合は、文書化されたDPAプロセスに基づき、GDPRへの準拠を確認してください。ISO 27001は好ましい兆候ですが、必ずしも必須ではありません。

「クラウドソーシングされたデータをエンタープライズ LLM トレーニングに使用できますか?」

クラウドソーシングされたデータは汎用的なタスクには有効ですが、エンタープライズアプリケーションに必要な一貫性と専門知識が不足していることがよくあります。専門分野(法律、医療、金融など)では、専任の専門家によるアノテーションが、クラウドソーシングによるアプローチよりも優れた成果を上げる傾向があります。

「プロジェクトの途中でデータのニーズが変わったらどうしますか?」

スコープ変更の手順については事前に交渉し、変更が価格、スケジュール、品質基準にどのような影響を与えるかを理解しましょう。MLプロジェクトの経験が豊富なベンダーは、反復的なプロセスを想定しています。厳格な変更指示プロセスは、柔軟性の欠如を示す可能性があります。

「トレーニングデータ内の個人情報(PII)をどのように処理すればよいですか?」

匿名化プロセスを確立し、そのアプローチに関するドキュメントを提供できるベンダーと連携してください。機密データについては、データ転送を最小限に抑えるため、オンプレミスまたはVPCの導入オプションについてご相談ください。

「データ収集とデータ注釈の違いは何ですか?」

データ収集とは、生データの収集または作成(音声録音、テキストサンプルの収集、画像のキャプチャなど)を指します。データアノテーションとは、既存データへのラベル付け(音声の書き起こし、感情タグの付与、境界ボックスの描画など)を指します。多くのプロジェクトでは、両方のツールが必要であり、場合によっては異なるベンダーからのツールも必要です。

ShaipがAIデータの専門知識を提供する方法

Shaipはデータ収集の複雑さを解消し、モデルの革新に集中できるようにします。当社の実績ある専門知識をご紹介します。

グローバルスケール + スピード

  • 70か国以上50,000万人以上の貢献者が、多様で大規模なデータセットを提供しています。
  • 150以上の言語でテキスト、音声、画像、ビデオを迅速に収集します
  • リアルタイムのタスク配分と品質管理のための独自のShaipCloudアプリ

エンドツーエンドのワークフロー

要件 → 収集 → クリーニング → 注釈 → QA → 納品

業界別ドメインエキスパート

業種 シャイプの専門知識
健康 匿名化された臨床データ(31の専門分野)、HIPAA準拠、SMEによるレビュー済み
会話型AI 多アクセント音声、自然な発話、感情タグ付け
Computer Vision 物体検出、セグメンテーション、エッジケースシナリオ
GenAI / LLM RLHFデータセット、推論チェーン、安全性ベンチマーク

チームがShaipを選ぶ理由

✅ パイロットファーストのアプローチ – スケールする前に結果を証明する

✅ サンプルデータセットは7日以内に納品されます – リスクなしでテストできます

✅ 95%以上のアノテーター間の合意 – 測定によるもので、約束ではありません

✅ グローバルな多様性 – 設計によるバランスの取れた表現

✅ コンプライアンスが組み込まれています – 収集から配送まで、GDPR、HIPAA、CCPAに準拠

✅ スケーラブルな価格設定 – 再交渉なしでパイロットから本番環境に移行

真の結果

  • 音声AI:アクセントや方言の認識率が25%向上
  • ヘルスケアNLP:PHIへの露出をゼロにしながら、臨床モデルのトレーニング速度を3倍に向上
  • RAG Systems: キュレーションされた接地データにより検索精度が40%向上

結論

最適なAIトレーニングデータプロバイダーを見つけるための近道をお探しですか?ぜひ当社にご連絡ください。面倒な手続きはすべて省き、当社と提携することで、AIモデルに最適な高品質かつ高精度なデータセットをご提供いたします。

これまでに説明したすべてのチェックボックスをオンにします。 この分野のパイオニアである私たちは、AIモデルの構築とスケーリングに何が必要か、そしてデータがすべての中心にあることを知っています。

また、バイヤーズガイドはさまざまな方法で広範かつ機知に富んでいたと考えています。 AIトレーニングはそのままでは複雑ですが、これらの提案や推奨事項を使用すると、面倒な作業を減らすことができます。 結局、あなたの製品は、これらすべてから最終的に利益を得る唯一の要素です。

話しましょう

  • このフィールドは、検証目的のためであり、不変のままにする必要があります。
  • 登録することで、Shaipに同意します プライバシーポリシー (NAIST) と 利用規約 ShaipからB2Bマーケティングコミュニケーションを受け取ることに同意します。

よくある質問(FAQ)

AIデータ収集とは、機械学習モデルの学習に使用するデータセットの収集、作成、キュレーションを行うプロセスです。LLMやチャットボットの場合、これには会話ログ、指示と応答のペア、嗜好データ、ドメイン固有のテキストコーパスが含まれます。

現代のLLMはトレーニングデータからパターンを学習します。低品質のデータ(エラー、バイアス、矛盾など)は、モデルのパフォーマンスを直接的に低下させます。小規模で高品質なデータセットは、大規模でノイズの多いデータセットよりも優れたパフォーマンスを発揮することがよくあります。

RLHF(人間からのフィードバックによる強化学習)データは、モデルの出力を望ましい行動に整合させるのに役立つ、人間の好みに関するアノテーションで構成されています。アノテーターはモデルの応答を比較し、どちらが優れているかを示し、整合のためのトレーニング信号を作成します。

合成データは、実データの拡張、エッジケースの生成、プライバシー保護を考慮した代替データの作成に適しています。ただし、文化的なニュアンスや現実世界の多様性が求められるタスクでは、合成データを主要なトレーニングソースとして使用することは避けてください。

データの来歴とは、データセットの保管記録、つまりデータの出所、収集方法、どのような同意が得られたか、そしてその使用に適用されるライセンスなど、データセットの保管記録を文書化したものです。来歴は、規制遵守においてますます重要になっています。

タイムラインは範囲によって異なります。パイロットプロジェクト(500~2,000ユニット)は通常2~4週間です。本番環境プロジェクト(10,000~100,000ユニット以上)は1~3か月かかる場合があります。複雑なドメインや多言語プロジェクトの場合は、さらに時間がかかります。

SOC 2 Type IIは企業のデータ処理における標準です。HIPAAコンプライアンスは医療アプリケーションにとって重要です。GDPRコンプライアンスはEU関連データに必須です。ISO 27001は、その追加的なプラスシグナルです。

許可データは、明示的な同意または適切なライセンスに基づいて収集されます。一方、スクレイピングデータは、多くの場合、許可なくウェブサイトから抽出されます。法的リスクや風評リスクを軽減するために、許可データの需要はますます高まっています。

明確な受け入れ基準を設けた有料パイロットを実施してください。ベンダーの指標だけに頼るのではなく、独自の品質レビュープロセスを適用してください。エッジケースや曖昧な例を具体的にテストしてください。

RAG(検索拡張生成)評価データは、クエリ、ドキュメント、回答の3つ組で構成され、システムが関連するコンテキストを取得し、正確な応答を生成できるかどうかをテストします。これは、RAGの精度を測定および向上させるために不可欠です。

料金モデルには、ユニット単位(アノテーション1件あたり、画像1枚あたり)、時間単位(音声/動画)、プロジェクトベースがあります。品質保証、修正、納品を含むオールインワン価格をご希望の場合は、お問い合わせください。費用は、複雑さや必要な専門知識によって大きく異なります。

含まれるもの: プロジェクトの範囲とデータの種類、品質要件と受け入れ基準、コンプライアンス要件、タイムラインの制約、ボリュームの見積もり、形式の仕様、ベンダー選択の評価基準。

はい。ベンダーはデータの拡充、再アノテーション、品質改善サービスを提供しています。また、エッジケースの追加、人口統計学的表現のバランス調整、最新の用語や情報を反映するためのデータ更新も可能です。