

物理AIのための姿勢推定:キーポイントとモーションデータを使ってロボットに動きを教える方法
姿勢推定とは、体のキーポイント(関節や顔のランドマーク)を特定し、それらを接続して、体の姿勢がどのように変化するかを記述する骨格を作成するコンピュータビジョンタスクです。
対話型AIとは何か?その仕組みと、データ層が全てを決定する理由とは?
会話型 AI がパーソナライズされたインタラクションで業界をどのように変えているのかをご覧ください。インフォグラフィックをご覧ください。
コンピュータビジョンにおいて合成データが有効な場合(そして裏目に出る場合)
インフォグラフィックをダウンロード すべてのコンピュータビジョンチームは最終的に同じ壁にぶつかります。最も必要なデータは、入手できないデータなのです。

多言語音声データがグローバルAIにとって重要な理由
インフォグラフィックをダウンロード デモでは音声モデルが完璧に機能します。次に、実際のユーザー、つまりスコットランド訛りでヒングリッシュで注文する人と出会います。

データ注釈の未来:2026年以降
自動化はアノテーターに取って代わるものではなく、彼らの能力を強化するものです。データアノテーションは「ラベル付け作業」からAIデータ運用へと進化し、より高度な判断、より強固なガバナンス、より厳密な評価へとつながっています。
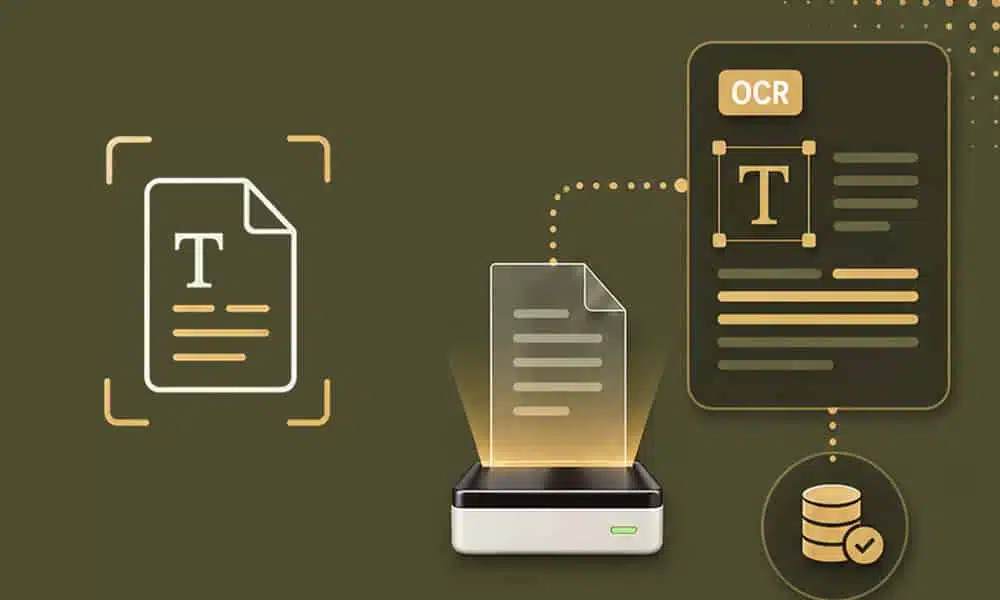
2026年のOCR:AIがあらゆる文書をデータに変換し、それに基づいて行動する方法
OCR は、機械が印刷されたテキストと画像を読み取れるようにする技術です。 これは、保存や処理のためにドキュメントをデジタル化するなどのビジネス アプリケーションや、経費精算のために領収書をスキャンするなどの消費者向けアプリケーションでよく使用されます。
ロボット工学における合成データと実世界データ:物理AIプロジェクトにはどちらを購入すべきか
物理AIでは、モデルがボトルネックになることはほとんどなく、データがボトルネックになります。デモでは完璧に動作するロボットポリシーが、その後停止してしまうことがあります。
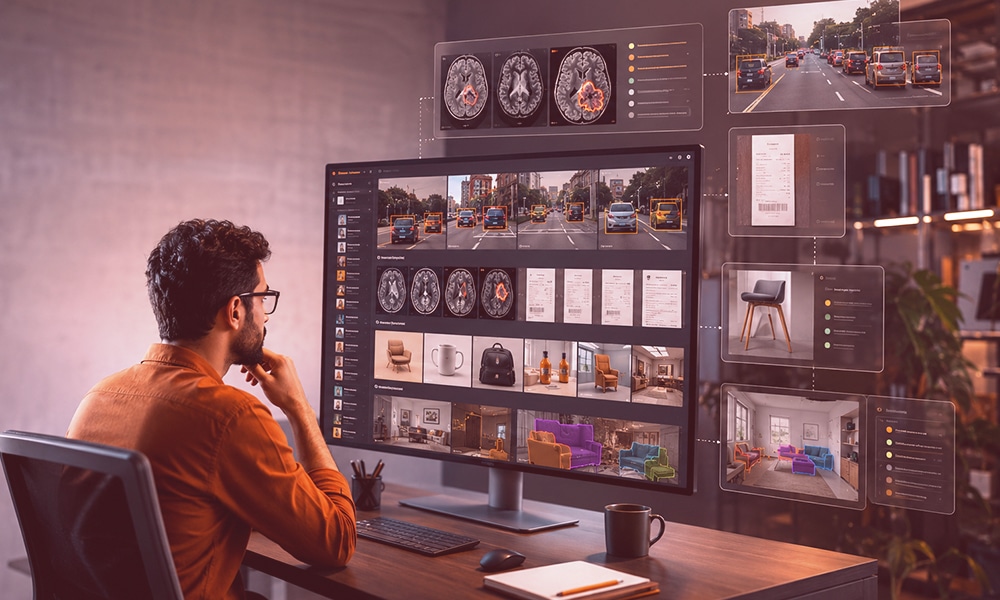
プロジェクトを加速させるコンピュータービジョン用無料画像データセット22選【2026年更新】
コンピュータビジョンモデルの精度は、学習に使用する画像の精度に左右されます。クリーンでラベル付けされたデータセットを入力すると、
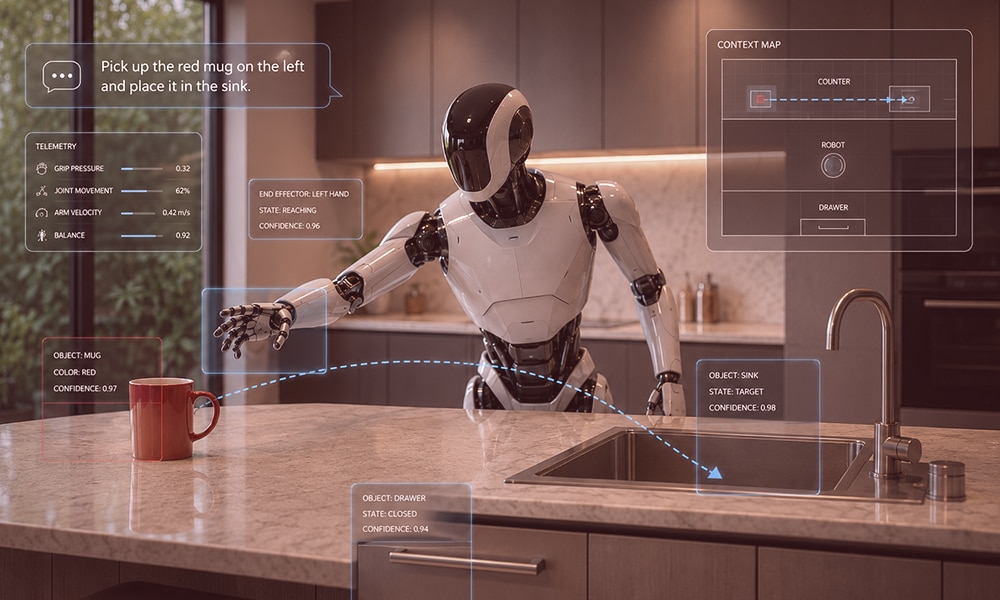
ヒューマノイドロボットのためのマルチモーダルデータ:視覚、言語、動作、テレメトリ、およびコンテキスト
人型ロボットに「左側の赤いマグカップを取ってシンクに置いてください」と頼むと、驚くべき量の

ドメインエキスパートによるLLM評価:企業チームのための完全ガイド
もしあなたの会社がテキストを生成するAIツール(チャットボット、文書要約ツール、ポリシーアシスタント、カスタマーサービスボットなど)を使い始めたなら、おそらく


EU人工知能法2026の期限:何が変わったのかを分かりやすく解説
EU AI法は、欧州における人工知能に関する包括的な規則集です。ほとんどの包括的な規則集と同様に、すべてが一度に適用されるわけではなく、異なる規則が適用されます。

ロボット訓練データと操作データセットが2026年の実世界ロボット工学をどのように支えるか
ほとんどのロボットモデルはデモでは完璧に動作するが、展開段階では破綻する。その理由は、ほとんどの場合、アーキテクチャではなくデータにある。

ロボットトレーニングデータ戦略:遠隔操作 vs シミュレーション vs 人間によるビデオを用いた身体化AI
現実世界で機能するロボット政策を構築することは、もはやコンピュータの問題ではなく、データの問題です。身体化されたAIチームは3つの

物理AIデータセットスタック:人間のデモンストレーション、ロボットの動作、VLAデータ、および長期タスク
ほとんどの物理AIチームはデータが必要であることを認識しているが、大量のデータが必要であることを認識しているチームは少ない。展開されたヒューマノイド、自動運転ロボット、または倉庫ロボットの能力は、
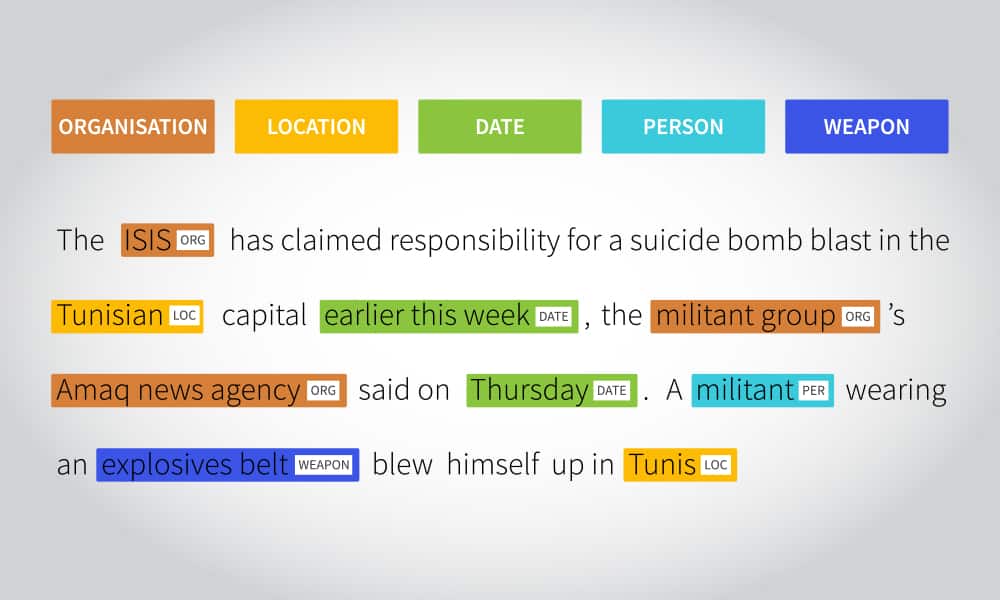

2026年に機械学習モデルをトレーニングするための、最高のオープンソースOCRデータセット22選
光学文字認識(OCR)は現在、レシートのスキャン、ID認証、請求書の自動化、歴史的アーカイブのデジタル化、スタイラスペンを使ったメモアプリなどに活用されている。OCR市場は今後さらに拡大すると予測されている。


VLM対VLA:ロボット工学においてビジョン言語モデルだけでは不十分な理由
ロボット工学の議論では、2 つのモデル クラスが混同されることがあります。それは、ビジョン言語モデルとビジョン言語アクション モデルです。これらは似たような名前で、どちらも画像とテキストを取り込み、どちらも

VLAモデル:視覚・言語・行動モデルがトレーニングデータから必要とするもの
チャットボットから自然言語コマンドに従うロボットへの移行は、単一のモデルクラスを通して行われます。VLAモデル(視覚・言語・行動モデル)は、視覚情報と自然言語情報を組み合わせています。

触覚センシングデータ:実際に感覚を持つロボットの背後にあるトレーニング信号
ロボットは物を見ることができる。インターネット規模の画像データセットと10年にわたる改良されたモデルがそれを可能にした。しかし、ロボットに実際に半分潰れた物を拾わせようとしても
