
-
会社
データ生成の速度を見ると、その80%が非構造化データであることが分かります。現場では、次世代テクノロジーを用いてデータを効果的に分析し、より適切な意思決定を行うための有意義な洞察を得る必要があります。NLPにおける固有表現認識(NER)は、主に非構造化データの処理と、これらの固有表現を定義済みのカテゴリに分類することに重点を置いています。これにより、非構造化データを下流の分析に使用できる構造化データに変換します。
世界のストレージ容量の設置ベースは、 2023年には11.7ゼタバイトに達する見込みです。
世界中のデータの80%は非構造化データであり、そのため時代遅れで利用できない。
Named Entity Recognition (NER) は、非構造化テキスト内の人、組織、場所などのエンティティを識別して分類します。 NER は、データ抽出を強化し、情報検索を簡素化し、高度な AI アプリケーションを強化するため、企業が活用するための重要なツールとなっています。 NER を使用すると、組織は貴重な洞察を得て、カスタマー エクスペリエンスを改善し、プロセスを合理化できます。
Shaip NERは、組織が非構造化データから重要な情報を引き出し、財務諸表、保険書類、レビュー、医師の診断書などからエンティティ間の関係性を発見できるように設計されています。NERはまた、文書内に複数の組織や個人が記載されているなど、同じ種類のエンティティ間の関係性を識別するのにも役立ちます。これは、エンティティのタグ付けの一貫性とモデルの精度向上に重要です。NLPと言語学の豊富な経験を持つ当社は、あらゆる規模のアノテーションプロジェクトに対応し、ドメイン固有の洞察を提供する体制を整えています。
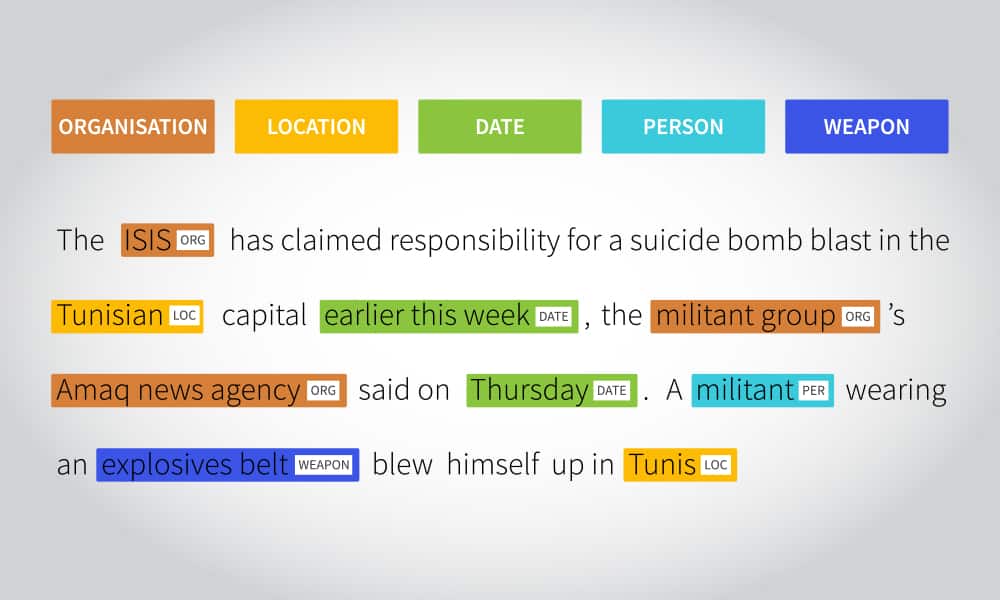
NERモデルの主な目的は、テキスト文書内のエンティティにラベルまたはタグを付け、深層学習用に分類することです。深層学習モデルやその他の機械学習モデルは、テキストから特徴を自動的に学習し、精度を向上できるため、NERタスクでよく使用されます。ニュースやウェブテキストなどの広範なコーパスでトレーニングされた汎用モデルは、ドメイン固有のNERタスクで正確に動作させるには適応が必要になる場合があります。この目的では、通常、以下の3つのアプローチが使用されます。ただし、1つまたは複数の手法を組み合わせることもできます。NERシステムを作成するための様々なアプローチは次のとおりです。

これはおそらく最も単純で基本的なNERアプローチです。 多くの単語、類義語、語彙コレクションを含む辞書を使用します。 システムは、テキストに存在する特定のエンティティが語彙でも利用可能かどうかをチェックします。 文字列照合アルゴリズムを使用することにより、エンティティのクロスチェックが実行されます。 TNERモデルが効果的に機能するためには、語彙データセットを絶えずアップグレードする必要があります。

ルールベースの手法は、テキスト内のエンティティを識別するために事前定義されたルールに依存します。これらのシステムは、事前に設定された一連のルールを使用します。
パターンベースのルール– その名の通り、パターンベースのルールは、ドキュメントで使用されている形態パターンまたは単語の文字列に従います。
文脈に基づくルール– 文脈に基づくルールは、文書内の単語の意味や文脈に依存します。

機械学習ベースのシステムでは、統計モデリングを用いてエンティティを検出します。このアプローチでは、テキスト文書の特徴に基づく表現が使用されます。ディープラーニングでは、スペルのわずかな違いがあってもモデルがエンティティの種類を認識できるため、最初の2つのアプローチのいくつかの欠点を克服できます。さらに、ドメイン固有のNER(自然言語処理)用にカスタムモデルをトレーニングすることもできますが、精度を向上させ、新しいデータに適応するためには、モデルを微調整することが重要です。
感情分析
NER注釈プロセスは通常、クライアントの要件とは異なりますが、主に次のものが含まれます。

フェーズ1:技術分野の専門知識(プロジェクトの範囲と注釈ガイドラインの理解)

フェーズ2:プロジェクトに適した人材の育成

フェーズ3:注釈付き文書のフィードバックサイクルと品質保証
機械学習における固有表現抽出(NER)は、自然言語処理の一部です。NERの主な目的は、構造化データと非構造化データを処理し、これらの固有表現を定義済みのカテゴリに分類することです。一般的なカテゴリには、名前、人、場所、会社、時間、金銭、イベントなどがあります。
1.1一般ドメイン
一般ドメイン内の人、場所、組織などの識別


1.2保険ドメイン
これには、次のような保険文書内のエンティティの抽出が含まれます。
1.3臨床領域/医療NER
EHRなどの医療記録からの問題、解剖学的構造、医学、手順の特定。 通常、構造化されていないため、構造化情報を抽出するには追加の処理が必要です。 これは多くの場合複雑であり、関連するエンティティを抽出するには、ヘルスケアのドメインエキスパートが必要です。


テキスト内の個別の名詞句を識別します。 名詞句は、単純なもの(たとえば、名詞、適切な名詞、代名詞などの単一の頭の単語)または複雑なもの(たとえば、頭の単語とそれに関連する修飾子を持つ名詞句)のいずれかです。

PIIとは、個人を特定できる情報を指します。 このタスクには、個人のIDに関連付けることができるキー識別子の注釈が含まれます。

PHIは、保護された健康情報を指します。 このタスクには、患者の記録/ IDを匿名化するために、HIPAAで識別される18の主要な患者IDの注釈が含まれます。
攻撃、誘拐、投資などのイベントについて、誰が、何を、いつ、どこで行うかなどの情報の識別。この注釈プロセスには、次の手順があります。
5.1. エンティティ識別(例:人、場所、組織など)

5.2. 主要な出来事を示す単語(すなわち、トリガーワード)の特定

5.3。 トリガーとエンティティタイプ間の関係の識別
データサイエンティストは、時間の80%以上をデータ準備に費やしていると推定されています。複数のアノテーターを連携させ、アノテーションプロジェクトの一貫性と品質を確保することで、アウトソーシングは、お客様のチームが堅牢なアルゴリズムの開発に集中できるようにし、面倒な固有表現抽出データセットの収集作業を当社にお任せいただくことを可能にします。
一般的な機械学習モデルでは、大量の名前付きデータセットを収集してタグ付けする必要があり、企業は他のチームからリソースを引き出す必要があります。テキスト、画像、音声など、複数のデータタイプにまたがるアノテーション作業をスケールアップすることは、困難な場合があります。当社のようなパートナーと協力することで、お客様のビジネスの成長に合わせて容易にスケールアップできる、ドメインエキスパートを提供できます。
日々アノテーション作業に携わる専任のドメインエキスパートは、多忙なスケジュールの中でアノテーション作業をこなさなければならないチームと比べて、常に優れた成果を上げます。言うまでもなく、これはより良い成果をもたらし、NERモデルからの予測精度の向上につながります。
当社の実績あるデータ品質保証プロセス、テクノロジー検証、および複数段階の QA により、下流処理を容易にする構造化された形式で注釈付きデータを提供して期待を上回るクラス最高の品質を実現しています。
私たちは、クライアントと協力して機密性を確保しながら、プライバシーを備えた最高水準のデータセキュリティを維持することで認定されています
熟練労働者のチームのキュレーション、トレーニング、および管理の専門家として、プロジェクトが予算内で確実に実施されるようにすることができます。
データ、サービス、ソリューションの高いネットワーク稼働時間とオンタイム配信。
オンショアおよびオフショアのリソースのプールを使用して、さまざまなユースケースの必要に応じてチームを構築および拡張できます。
Shaipは、グローバルな労働力、堅牢なプラットフォーム、およびシックスシグマの黒帯によって設計された運用プロセスの組み合わせにより、最も困難なAIイニシアチブの立ち上げを支援します。

Named Entity Recognition (NER) は、一流の機械学習と NLP モデルを開発するのに役立ちます。 この非常に有益な投稿で、NER の使用例、例などを学びましょう。

ヘルスケア領域のデータの 80% は構造化されていないため、アクセスできません。 データにアクセスするには大幅な手動介入が必要となるため、使用できるデータの量が制限されます。

機械学習におけるテキスト アノテーションとは、生のテキスト データにメタデータまたはラベルを追加して、機械学習モデルのトレーニング、評価、改善のための構造化データセットを作成することを指します。
チームが世界をリードするAI製品を構築できるようにします。


独自のAI / MLソリューション用のカスタムNERデータセットを収集する方法については、今すぐお問い合わせください
医療データアノテーションとは、AIモデルの学習のために、医療テキスト、画像、音声、動画にラベルを付けるプロセスです。これは、診断、治療計画、患者ケアを改善する高精度なAIシステムの開発に不可欠です。
ラベル付きデータセットを提供することで、AIモデルは複雑な医療データ内のパターン認識を学習し、例えばX線画像から疾患を特定したり、臨床記録から重要な情報を抽出したりできるようになります。これにより、医療分野におけるAIアプリケーションの精度と信頼性が向上します。
医療データの注釈には、臨床メモ、電子健康記録 (EHR)、X 線、MRI、CT スキャン、病理レポート、医師の口述などの音声データへのラベル付けが含まれます。
注釈付きの医療テキストにより、自然言語処理 (NLP) モデルは医師のメモや退院サマリーなどの非構造化データから症状、病気、投薬などの臨床情報を抽出して解釈できるようになります。
医療データにアノテーションを付与するには、構造化されていない複雑な情報の処理、臨床的正確性の確保、HIPAAなどのプライバシー規制への準拠が求められます。また、医療用語の専門知識と分野知識も求められます。
注釈プロバイダーは、HIPAA コンプライアンスなどの厳格なデータ セキュリティ プロトコルに従い、機密性の高い医療情報に注釈を付ける際に患者のプライバシーを維持するために匿名化されたデータを使用します。
注釈付きデータセットは、AIモデルを訓練し、医療画像やテキスト内の疾患マーカーを認識できるようにします。例えば、AIは腫瘍学においてがんのステージを特定したり、心臓病学において心臓の状態を検出したりすることで、早期診断と治療成果を向上させます。
高度な注釈ツールと、医用画像処理用の DICOM ビューアなどのドメイン固有のソフトウェアが、人間の専門知識と併用され、医療データのラベル付けの精度が高まります。
Shaipは、各分野のエキスパート、高度なアノテーションツール、そして堅牢な品質保証プロセスを組み合わせることで、顧客のニーズに合わせた正確かつスケーラブルな医療データアノテーションを提供します。同社は、放射線学、腫瘍学、心臓病学、その他の医療分野を専門としています。
費用は、データの種類、量、複雑さ、そして必要な専門知識のレベルによって異なります。Shaipは、特定のプロジェクト要件に基づいてカスタマイズされた価格設定を提供します。

当サイトでは、お客様の利便性向上のためクッキーを使用しています。当サイトを利用することで、お客様はクッキーの使用に同意したことになります。
以下の Cookie 設定を管理します。
エッセンシャルCookieは、基本的な機能を有効にし、Webサイトが適切に機能するために必要です。
Google タグ マネージャーを使用すると、コードを変更することなく、ウェブサイト上のマーケティング タグの管理が簡単になります。
統計 Cookie は匿名で情報を収集します。この情報は、訪問者が当社の Web サイトをどのように使用しているかを理解するのに役立ちます。
Google アナリティクスは、ウェブサイトのトラフィックを追跡、分析し、情報に基づいたマーケティングの意思決定を行う強力なツールです。
サービスURL:policies.google.com (新しいウィンドウで開きます)
マーケティング クッキーは、ウェブサイトへの訪問者を追跡するために使用されます。その目的は、個々のユーザーにとって関連性が高く、魅力的な広告を表示することです。
Google広告は、企業がGoogle検索結果や提携サイトに表示されるターゲット広告を作成できるオンライン広告プラットフォームです。
サービスURL:policies.google.com (新しいウィンドウで開きます)
HubSpotは、ビジネスの成長を効率化するオールインワンのマーケティング、セールス、カスタマーサービスプラットフォームです。
サービスURL:legal.hubspot.com (新しいウィンドウで開きます)
詳細については、当社のクッキーポリシーおよびプライバシーポリシーをご覧ください。