
企業向けAIの中核には、静かな皮肉が潜んでいる。世界最高レベルのAIモデルであっても、データがスキャンされた請求書、ファックスで送られてきた検査報告書、手書きの納品書といった非構造化文書の中に閉じ込められていたら、何の役にも立たないのだ。そして、ビジネスデータの約80%は、まさにこうした非構造化文書の中に存在していると推定されている。
光学文字認識(OCR)は、そうしたデータを解放する技術です。そして2026年、OCRはまさに飛躍的な成長を遂げています。世界のOCR市場は、2023年の13.1億ドルから2033年には55.3億ドルに達すると予測されており、年間15.5%の成長率で拡大しています。最新のOCRエンジンは、ページレベルで98~99%の精度を日常的に達成しています。かつては扱いにくいスキャンツールだったOCRは、今や企業自動化への入り口となっています。
今日のOCRの現状、その仕組み、存在する種類、AIがもたらした変化、そして今後の展望について解説します。
OCRとは何ですか?
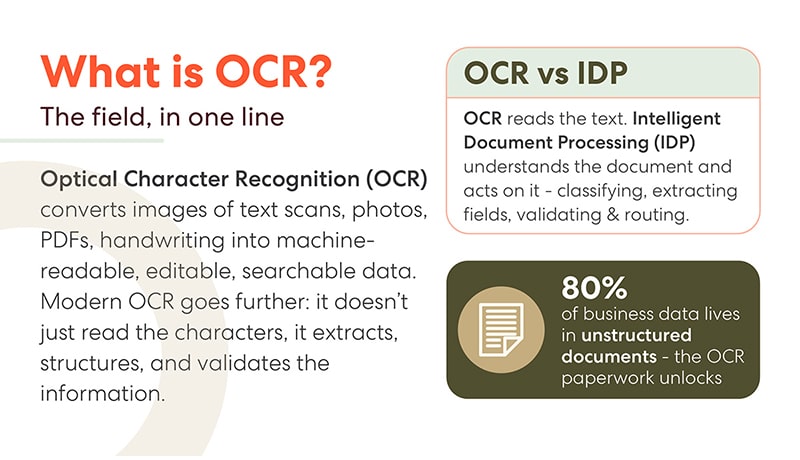
光学文字認識(OCR)は、スキャン画像、写真、PDF、手書き文字など、テキストの画像を機械が読み取り、編集、検索可能なデータに変換する技術です。これは教科書的な定義ですが、2026年に実際に起こる変化を過小評価していると言えるでしょう。
最新のOCRは単に文字を読み取るだけではありません。フィールド、テーブル、明細項目といった構造を抽出し、抽出した情報を検証します。スマートフォンで撮影したしわくちゃの請求書を入力すると、単なるテキストの塊ではなく、ベンダー、日付、明細項目、合計金額、そしてそれぞれに信頼度スコアが付いた構造化されたレコードが返されます。
OCRとIDP:重要な違い
ベンダーとの会話ではどちらの用語も耳にするでしょうから、ここでその違いを説明します。OCRはテキストを読み取ります。インテリジェント文書処理(IDP)は文書を理解し、それに基づいて処理を行います。具体的には、文書の種類を分類し、重要なフィールドを抽出し、ビジネスルールに照らし合わせて検証し、結果を適切なシステムにルーティングします。
OCRを目、IDPを脳と考えてみてください。どちらか一方だけでは不十分です。完璧に文字起こしされたテキストでも、解釈には人間の手が必要だったり、スマートなワークフローでも読みやすい入力データが不足していたりします。市場は間違いなく、この2つの組み合わせへと向かっています。
OCRの仕組み:最新の6ステップパイプライン
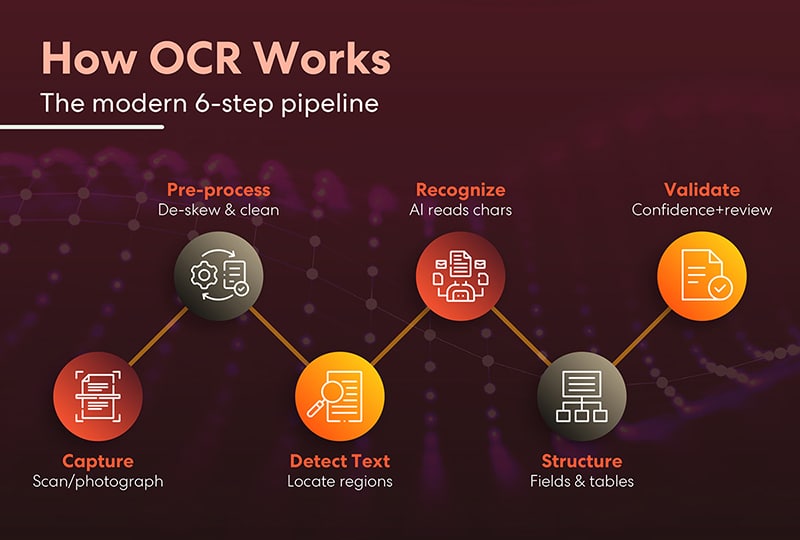
今日のOCRシステムは6段階の処理工程を経ており、それを理解することで、精度が飛躍的に向上した理由と、依然としてエラーが発生する箇所を解明するのに役立つ。
まず、文書のスキャンまたは写真撮影から始めます。次に、前処理で画像をクリーンアップします。傾いたページの歪みを補正し、ノイズを除去し、コントラストを調整します。これは、認識精度が元の画像の品質に左右されるためです。次に、テキスト検出で、実際にテキストが含まれているページ領域を特定し、単語をロゴ、スタンプ、背景から分離します。そして、認識の段階に入ります。AIが文字を読み取ります。これは、多くの人が「OCR」と考えるステップです。しかし、最新のパイプラインはそこで終わりません。構造化では、生のテキストをフィールドとテーブルにマッピングし、「ページ上の単語」を「スキーマ内のデータ」に変換します。最後に、検証で信頼度スコアリングとレビューを適用し、システムに取り込まれる前に人間にとって不確かなものを特定します。
キャプチャ → 前処理 → 検出 → 認識 → 構造化 → 検証。最後の2つのステップこそが、2026年時代のOCRと10年前のスキャンソフトウェアを区別する決定的な要素です。
OCRの種類:すべての認識が同じというわけではない
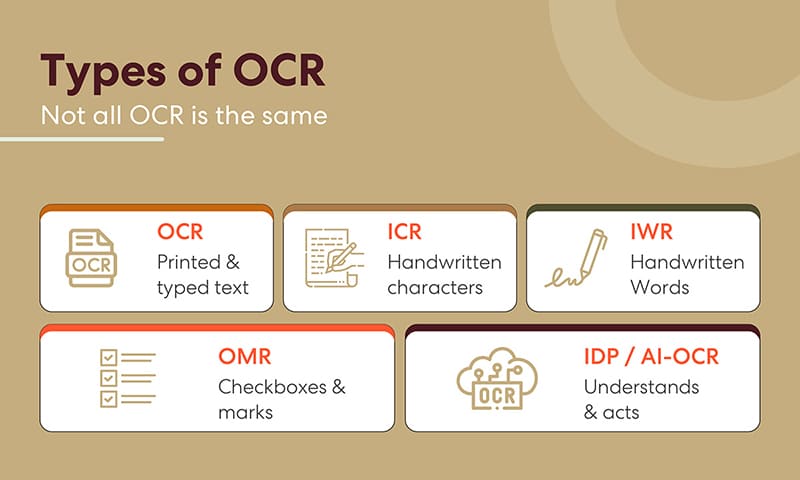
「OCR」は包括的な用語として使われることが多いが、この分野では複数の技術が区別されており、それぞれ異なるコンテンツに適している。
OCRは、印刷されたテキストやタイプされたテキストを扱います。これは最も簡単で成熟した技術です。ICR (インテリジェント文字認識)は手書き文字を読み取ります。これはこの分野で最も難しい課題の1つです。IWR (インテリジェント単語認識)はさらに一歩進んで、個々の文字ではなく手書きの単語全体を認識します。これは文字がぼやけて見える筆記体に適しています。OMR (光学式マーク認識)はチェックボックスやマークを読み取ります。これはフォームや解答用紙の背後にある技術です。そして、IDP/AI-OCRは最上位に位置します。これは単に読み取るだけでなく、理解して行動するシステムです。
OCRプロジェクトにおいて最初に問われるのは、文書の種類を把握することです。印刷された請求書と医師の手書きの処方箋では、全く異なる問題が生じます。
AI時代のOCR:生OCRはもはや第一歩に過ぎない
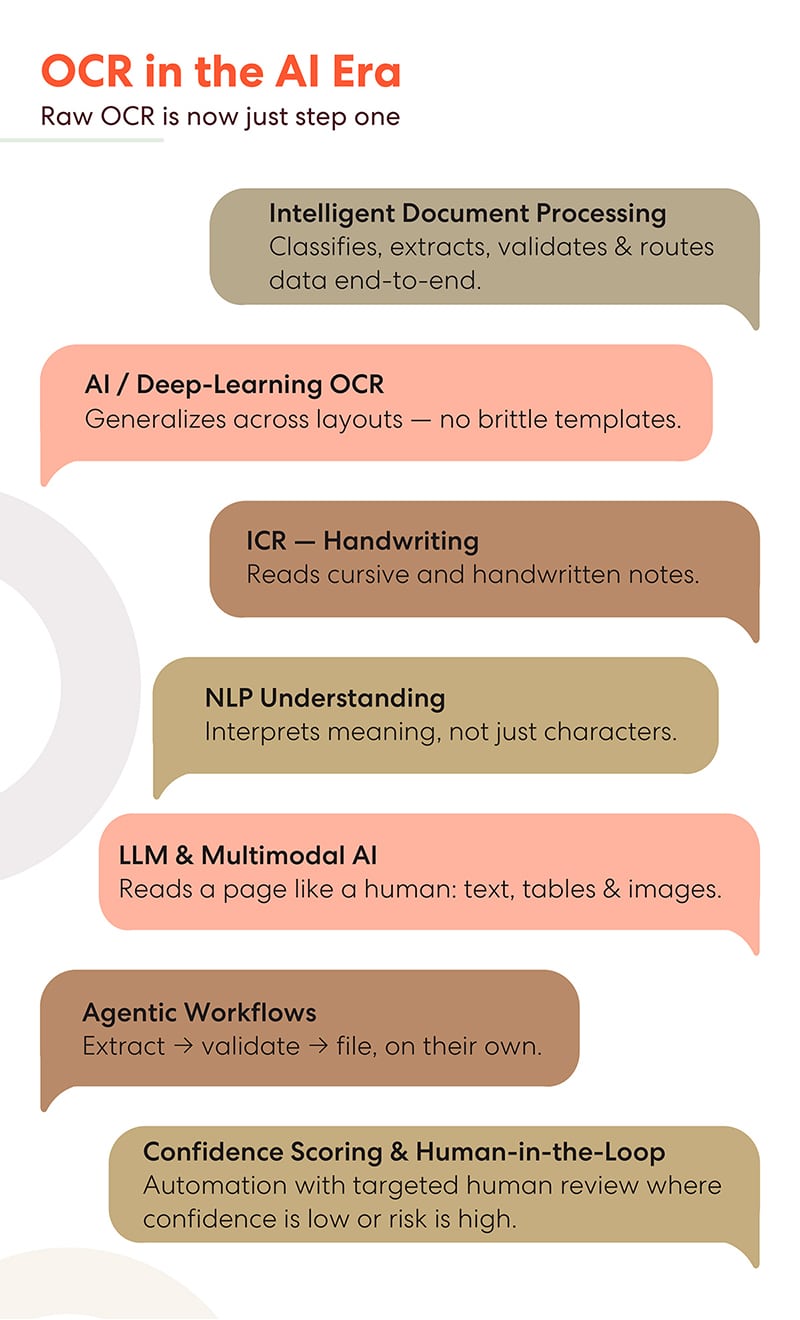
この分野における最も大きな変化は、かつては製品のすべてであった文字認識が、今や単なる入り口に過ぎなくなったことである。現代の文書AIは、7つの機能によって特徴づけられる。
インテリジェント文書処理は、文書の分類、フィールドの抽出、データの検証、結果のルーティングといった一連のプロセスを、手動による引き継ぎなしにエンドツーエンドで実行します。
AIとディープラーニングを用いたOCRは、レイアウトの多様性に対応できる。従来のシステムでは、文書形式ごとに脆弱なテンプレートが必要だったが、最新のモデルは、請求書が一般的にどのようなものか学習しているため、これまで見たことのない請求書でも処理できる。
ICRの手書き文字認識技術は、筆記体や手書きのメモを読み取れるほどに成熟し、これまでアクセスできなかった医療記録、配送伝票、アーカイブ文書の解読を可能にした。
自然言語処理(NLP)は、文字だけでなく意味も解釈します。システムは単に「Net 30」と書き写すのではなく、それが支払い条件であることを認識します。
LLM(言語レベルモデル)とマルチモーダルAIは、人間と同じようにページを読み取ります。つまり、テキスト、表、画像を文脈の中でまとめて認識するのです。これは、スタックの中で最も新しく、最も急速に発展しているレイヤーです。
エージェント型ワークフローは、抽出→検証→ファイル保存という一連のプロセスを自律的に完結させます。文書は単に読み込まれるだけでなく、適切に処理されます。
人間が関与する信頼度スコアリングにより、これらすべてを安全に展開できます。信頼度が高い場合は自動化を進め、信頼度が低い場合やリスクが高い場合にのみ人間がレビューを行います。このターゲットを絞ったレビューモデルにより、企業はスピードと監査可能性の両方を実現できます。
OCRの活用事例:価値を発揮する場面
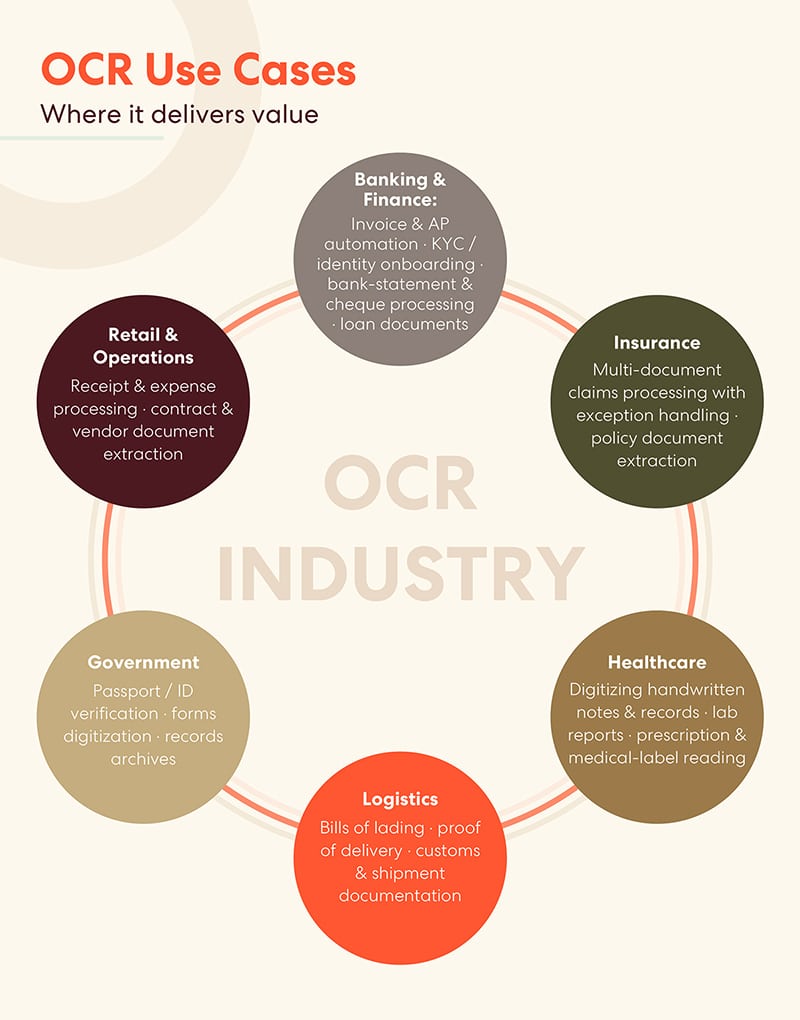
OCRを最も早く導入している業界は、紙の山に埋もれている業界だ。
銀行・金融業界が市場を牽引しています。請求書や買掛金の自動化、KYC(顧客確認)や本人確認のオンボーディング、銀行取引明細書や小切手の処理などに利用されています。BFSI(銀行・金融サービス・保険)がOCR分野で最大の市場規模(約21%)を占めているのは偶然ではありません。保険業界では、例外処理や保険証券の抽出を含む複数文書の請求処理にOCRが利用されています。1件の請求には、さまざまな形式の文書が数十件含まれる場合があります。医療業界では、OCRは手書きのメモや記録をデジタル化し、検査報告書を読み取り、処方箋や医療ラベルを処理します。医療業界では、正確さが文字通り安全に関わる問題です。物流は、船荷証券、配達証明、通関書類、出荷書類などの文書に基づいて運営されており、OCRは書類がボトルネックにならないようにすることで、商品の流れを円滑にします。政府機関は、パスポートやIDの確認、フォームの処理、記録アーカイブのデジタル化にOCRを適用しています。小売業や業務では、領収書や経費の処理、契約書やベンダー文書の抽出にOCRが活用されています。
これら6つのパターンすべてに共通しているのは、かつて人間が紙からシステムに情報を入力し直していた作業が、今ではOCRによってより速く、より安価に、そして監査証跡付きで行われるようになったということだ。
メリットと課題:正直な現状
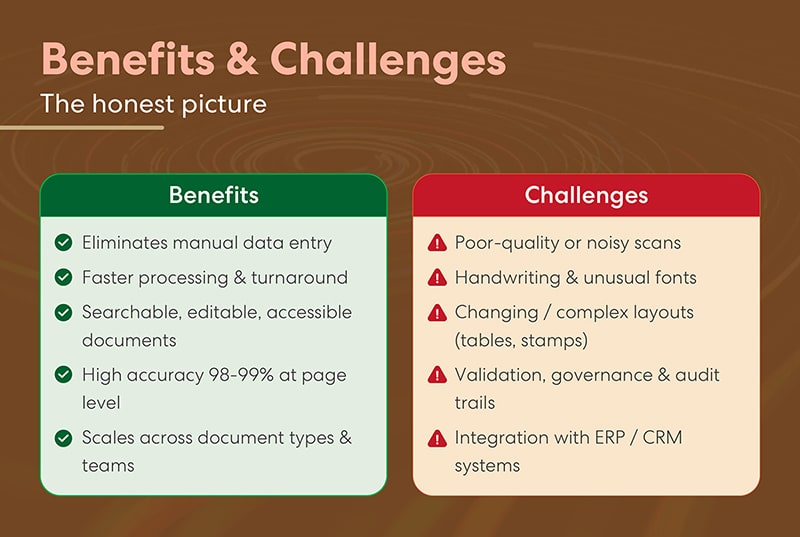
そのメリットは明白です。OCRは、バックオフィス業務の中で最もエラーが発生しやすく、最も嫌われる作業である手作業によるデータ入力を不要にします。処理速度と納期は劇的に向上します。文書は、単なるスキャン画像ではなく、検索、編集、アクセス可能なものになります。ページレベルでの精度は98~99%に達します。また、最新のシステムは、馴染みのない文書の種類やフォーマットにも対応し、処理が滞ることはありません。
しかし、実際の導入では依然として様々な問題に直面します。スキャン品質の低さやノイズの多さは、依然として精度を著しく低下させる最大の要因です。判読できないものは、どのモデルでも読み取ることができません。手書き文字や特殊なフォントは、印刷されたテキストに比べて依然として問題があります。入れ子になった表、スタンプ、複数列のフォームなど、複雑で変化に富んだレイアウトは、データ抽出を困難にします。検証、ガバナンス、監査証跡には、特に規制の厳しい業界では、相当なエンジニアリングの労力が必要です。また、ERPやCRMシステムとの統合は、多くのプロジェクトが停滞するポイントです。データ抽出は、実際に業務が行われる場所にデータが届いて初めて意味を持つからです。
これらはどれも決定的な欠点ではありません。信頼度スコアリングや人間によるレビューが存在する理由であり、ドキュメントの品質や適切に注釈付けされたトレーニングデータがモデルの選択と同じくらい重要である理由でもあります。
OCR市場:情報源と現状
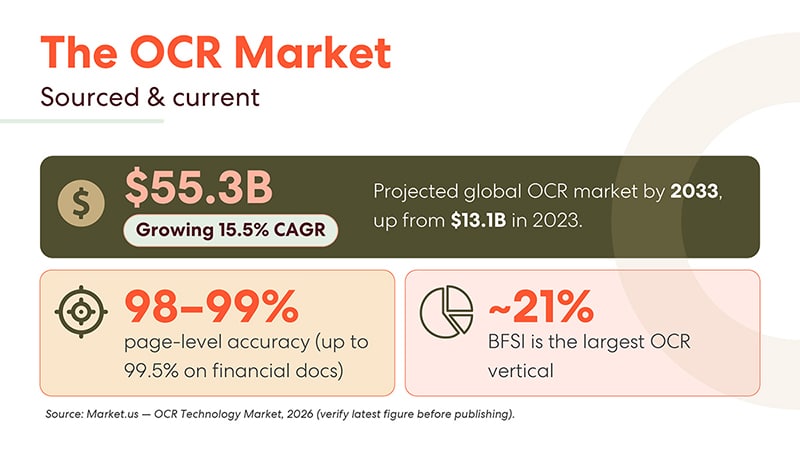
数字は、この市場機会の大きさを物語っています。世界のOCR市場は、2023年の13.1億ドルから2033年には55.3億ドルに達すると予測されており、年平均成長率は15.5%です。ページレベルの精度は98~99%に達しており、金融文書ではさらに向上しています。そして、BFSI(銀行・金融サービス・保険)分野は市場全体の約21%を占める最大の業種であり、投資対効果(ROI)が最初に実証される分野であることを示しています。
今後の展望:2026年のOCRトレンド
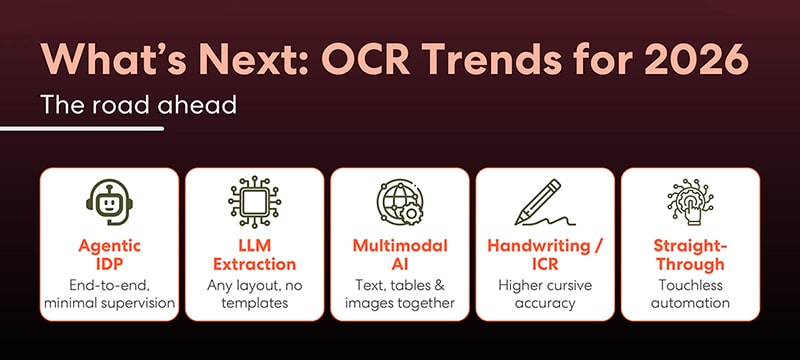
今後の方向性を決定づける5つのトレンド。エージェントIDP ― エンドツーエンドで人間の手が一切入らずに実行されるドキュメントワークフロー。LLMを活用した抽出― 大規模言語モデルを使用して、テンプレート設定をほとんど、あるいは全く行わずにドキュメントから構造化データを抽出する。マルチモーダルAI ― テキスト、表、画像を一度に処理し、ドキュメントを断片ではなく全体として理解するモデル。手書き文字認識とICRの進歩― 筆記体や乱雑な手書き文字の精度が着実に向上し、これまで手作業のみだったドキュメントクラスに対応可能になる。そして、最終目標であるストレートスルー処理― 到着したドキュメントが人間の手が一切入らずに読み込まれ、検証され、ファイリングされる。
その方向性は明白だ。文書を読むことから、文書を扱うことへと移行するのだ。
ボトムライン
2026年のOCRは、もはや画像をテキストに変換する技術ではなく、書類を完成された作業へと変換する技術へと進化するでしょう。ビジネスデータの80%が非構造化文書に閉じ込められ、市場規模が55億ドルに迫る中、多くの組織にとっての問題は、OCRを導入するかどうかではなく、どのレベルまで導入するか、つまり、プレーンテキスト抽出、構造化IDP、あるいは完全なエージェント型ドキュメントワークフローのどれを採用するか、という点です。
文書はすでに山積みになっている。それらを読み込み、それに基づいて行動するための技術は既に整っている。