午後9時に銀行に電話して請求内容に異議を申し立てると、音声応答システムが応答し、一度で問題を理解し、取引内容を表示し、本人確認を行い、問題を解決してくれる。保留音も、送金も、「メインメニューに戻るには4を押してください」といったメッセージも一切ない。このやり取りは、まさにAIの勝利と言えるだろう。

確かにそうです。ただし、多くの人が想像するような方法ではありません。このモデルは現在、ほぼ汎用品となっています。この通話が機能したのは、あなたのような話し方をする人々の何千時間にも及ぶ録音音声データのおかげです。これらの音声データは、「料金に異議を申し立てる」という意味について合意したアノテーターによってラベル付けされ、システムが実際に聞き取るアクセントや言い回しが選別され、同意なしに誰の声もトレーニングセットに含まれないように管理されていました。
これが2026年の対話型AIの真の姿です。市場は年平均成長率約21%で824億6000万ドル規模に成長し、現在では78%の組織が少なくとも1つの業務機能でAIを活用しており、75%が顧客サポート向けに大規模な言語モデルを導入する予定です。技術は確立されています。差別化要因はスタックの下位、つまりデータへと移行しました。全体像は以下のとおりです。
会話型AIとは一体何なのか
対話型AIとは、音声認識、自然言語理解、音声生成を組み合わせて自然な双方向の会話を行うシステム群(チャットボット、バーチャルエージェント、音声アシスタントなど)であり、使用するたびに精度が向上する。
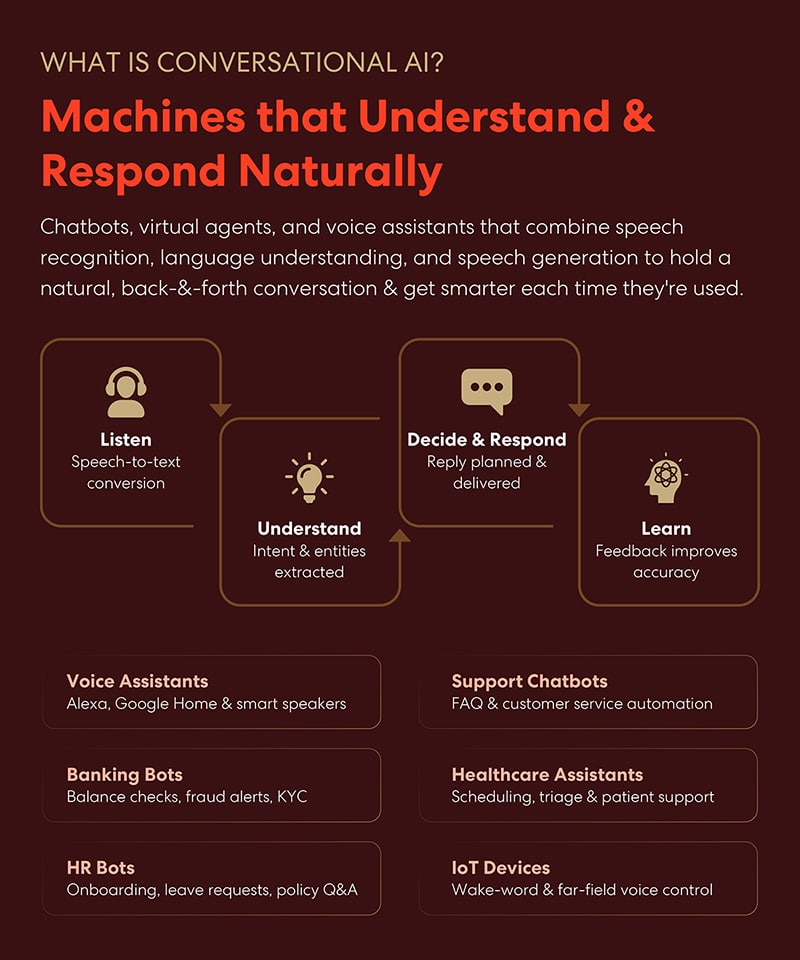
見た目の多様性の根底には、すべて同じ4段階のループが存在している。
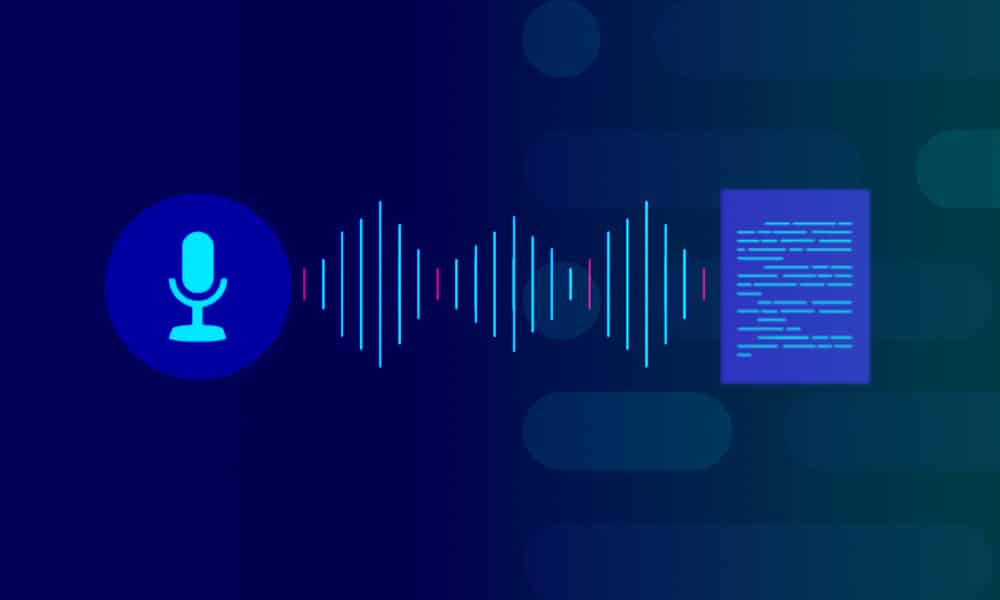
- システム 聞く音声をテキストに変換する。
- It 理解する意図とエンティティ、つまりユーザーが何を求めているのか、そしてその要望に付随する具体的な詳細を抽出する。
- It 決定し、対応する返信を計画し、送信する。
- それを 学ぶフィードバック信号を利用して、次のターンと次のユーザーの精度を向上させる。
聞く→理解する→決める→学ぶ。以下の製品はすべて、この同じループを繰り返すことで、異なる領域を表現しています。
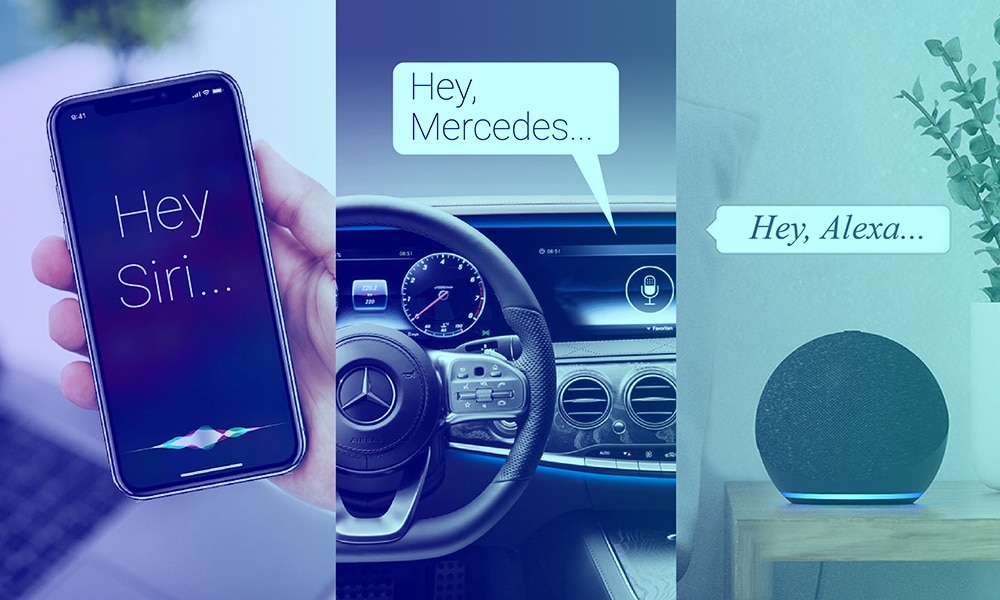
- 音声アシスタント AlexaやGoogle Homeのようなスマートスピーカーは、家庭内の様々な要望に幅広く対応します。
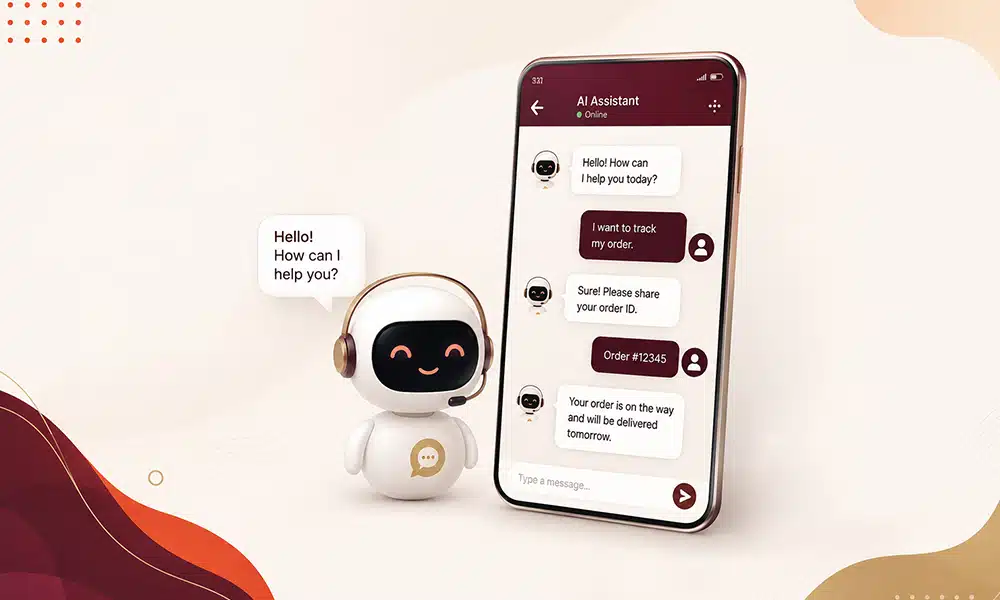
- チャットボットのサポート FAQ処理と顧客サービストリアージを自動化する。
- 銀行ボット 残高照会、不正利用警告、および本人確認(KYC)を実行します。
- 医療アシスタント スケジュール管理、症状のトリアージ、患者サポートを行う。
- 人事ボット 入社手続きに関する質問、休暇申請、およびポリシーに関する質疑応答。
- IoTデバイス ウェイクワード検出と遠距離音声制御に依存しており、マイクは部屋の反対側にあり、ユーザーは画面を見ていない。
同じパイプラインでも、障害発生条件は根本的に異なる。小売店のチャットボットが意図を誤読すれば、コンバージョンが失われる。一方、医療機関のトリアージアシスタントが意図を誤読すれば、患者の安全に関わる重大な問題となる。この違いは、アーキテクチャではなく、データによって決まる。
生の音声データがトレーニングデータになる方法
録音データからモデルに使用できるデータセットを作成するには、2つの異なるステップが必要です。まず、音声データの収集方法を選択し、次に、モデルが学習できるように音声データにラベルを付けます。これらを1つのステップとして扱うチームは、誤った情報を学習してしまう大規模なデータセットを作成してしまう傾向があります。
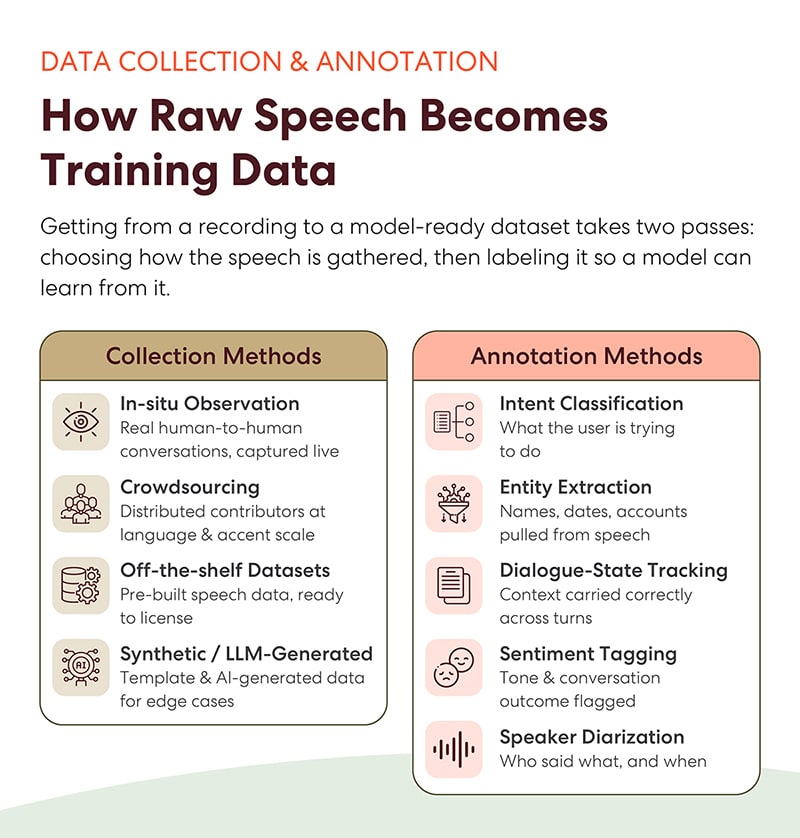
収集面では、4つの方法でほとんどのニーズに対応できます。
- 現場観測 生身の人間同士の会話をリアルタイムで捉える――これは入手可能な信号の中で最も忠実なものだが、大規模に取得するのが最も難しい。
- クラウドソーシング 言語やアクセントに基づいて選ばれた寄稿者に録音を配布することで、偶然ではなく意図的に報道内容を構築していく。
- 既製のデータセット ドメインが適切に一致する場合、ライセンス供与可能な、事前に構築・承認済みの音声データを提供することで、タイムラインを数ヶ月短縮できます。
- 合成またはLLM生成 データは特定のギャップを埋める。例えば、発生するのを待つには稀すぎる特殊なケースに対して、テンプレートベースやAI生成による発話を提供する。
アノテーション側では、5つのラベル付けレイヤーが音声データを監視データに変換する。
- 意図の分類 ユーザーが何をしようとしているのかをタグ付けします。
- エンティティの抽出 スピーチから名前、日付、口座番号を抽出する。
- 対話状態追跡 システムはターンをまたいで文脈を保持するため、「2番目」が4ターン前に言及されたものを指していることを認識します。
- 感情タグ付け 会話のトーンと結果に影響を与える。
- スピーカーのダイアライゼーション 誰が何をいつ言ったかを明確にするものであり、複数人での録音、つまりほとんどの実際の通話データにおいては、譲ることのできない要素である。
収集 → 文字起こし → インテントとエンティティにラベルを付ける → 状態を追跡する → 日記化する → 検証する。このレイヤーを一つでも省略すると、文字起こしは流暢だが何も理解しないモデルになってしまう。
「良質なデータ」とは実際には何によって測定されるのか
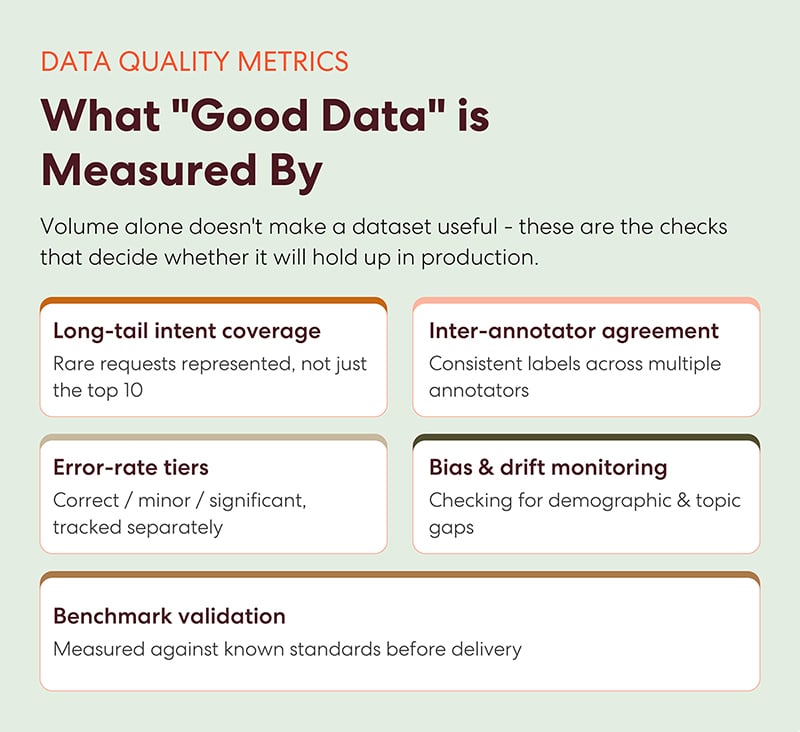
データセットの容量が大きいだけでは、有用なデータセットとは言えません。本番環境で通用するかどうかは、以下の5つのチェック項目で判断します。これらの項目については、ベンダーに直接問い合わせる価値があります。
- ロングテールインテントカバレッジ 上位10件だけでなく、まれなリクエストも含まれているかどうかを問う。ほとんどのデータセットは、ユーザーが頻繁に使用するごく少数のインテントによって占められており、ほとんどの運用上の障害は、その下位層で発生する。
- 注釈者間の合意 複数のアノテーターが同じ発話に対して同じラベルを付けるかどうかを測定する。一致度が低いということは、ラベルが真実ではなく混乱を反映していることを意味する。
- エラー率の段階 正しいエラー、軽微なエラー、重大なエラーを区別し、それぞれを個別に追跡する必要があります。なぜなら、壊滅的な誤分類による3%のエラー率は、些細な誤分類による3%のエラー率とは異なるからです。
- バイアスおよびドリフトの監視 人口統計学的およびトピック上のギャップをチェックし、言語やユーザーの行動の変化に応じて、それらを長期的に監視します。
- ベンチマーク検証 納品前にデータセットを既知の基準に照らし合わせて評価するため、品質は問題となる前に確立されます。
これら5つの要素が、デプロイ可能なデータセットと、作り直さなければならないデータセットとの違いを生み出します。
信頼はデータ層に組み込まれており、後付けされるものではない
音声データには、個人の声と発言という、その人を最も特徴づける要素が含まれています。そのため、データ収集段階からガバナンスを設計に組み込む必要があります。なぜなら、既に学習に使用した録音データに後から同意を追加する方法はないからです。
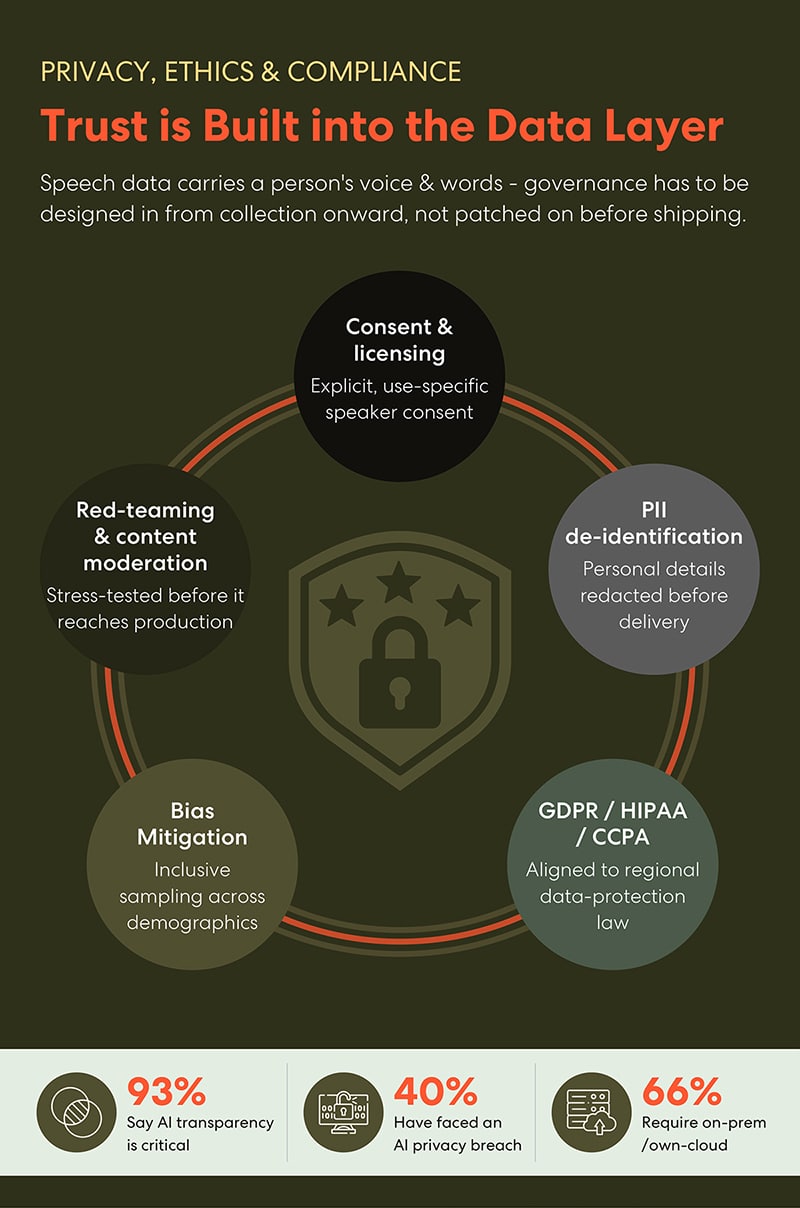
防御可能なデータ層を定義する5つの制御要素。
- 同意とライセンス これは、明示的で具体的な使用目的に応じた発言者の同意を意味し、包括的な利用規約条項を意味するものではありません。
- 個人情報の匿名化 事件発生後ではなく、配達前に個人情報を削除する。
- GDPR、HIPAA、CCPAとの整合性 パイプラインを、実際に展開に適用される地域のデータ保護法にマッピングします。
- バイアスの軽減 あらゆる人口統計学的属性を網羅した包括的なサンプリングを、費用のかからない収集計画に組み込む。費用のかかる是正措置に組み込むのとは対照的である。
- レッドチーム演習とコンテンツモデレーション システムが本番環境のユーザーに届く前に、ストレステストを実施する。
市場はこの状況を既に織り込んでいる。組織の93%がAIの透明性は極めて重要だと回答し、 40%が既にAIプライバシー侵害を経験しており、66%がオンプレミスまたは自社クラウドでの導入を必要としている。購入者はデータの出所を問い、ますます契約書にその回答を明記することを求めている。
対話型AIの活用事例
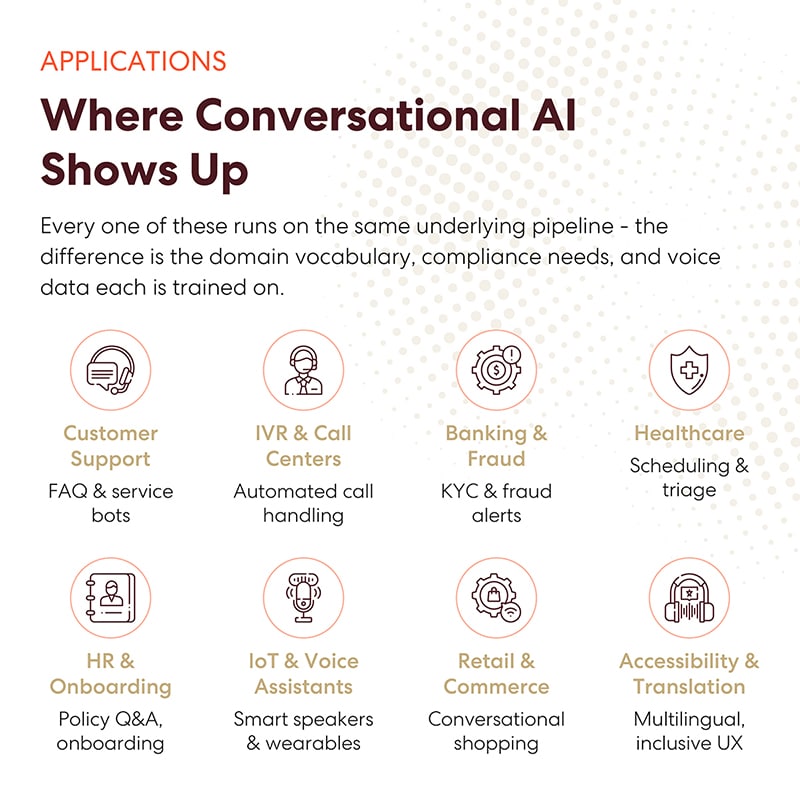
企業における導入の大部分は、8つのアプリケーション分野に集中している。
- 顧客サポート FAQやサービスボットを実行します。
- IVR(自動音声応答システム)とコールセンターは、通話処理とルーティングを自動化する。
- 銀行業務と詐欺 本人確認(KYC)と不正行為の警告機能が含まれています。
- 健康 スケジュール調整と優先順位付けを担当する。
- 人事およびオンボーディング ポリシーに関する質疑応答と新規採用者のワークフローを管理する。
- IoTと音声アシスタント スマートスピーカーやウェアラブル端末に電力を供給する。
- 小売および商業 会話型ショッピングを可能にする。
- アクセシビリティと翻訳 標準的なインターフェースでは対応できない人々に対し、多言語対応で包括的なユーザーエクスペリエンスを提供する。
これらはすべて同じ基盤パイプライン上で動作します。違いは、ドメイン語彙、コンプライアンス要件、そしてそれぞれが学習に使用する音声データです。最後の変数である音声データこそ、チームが投資を怠りがちな要素であり、デモ環境以外での導入が成功するかどうかを左右する重要な要素なのです。
より優れた対話型AIは、より優れたデータから始まる
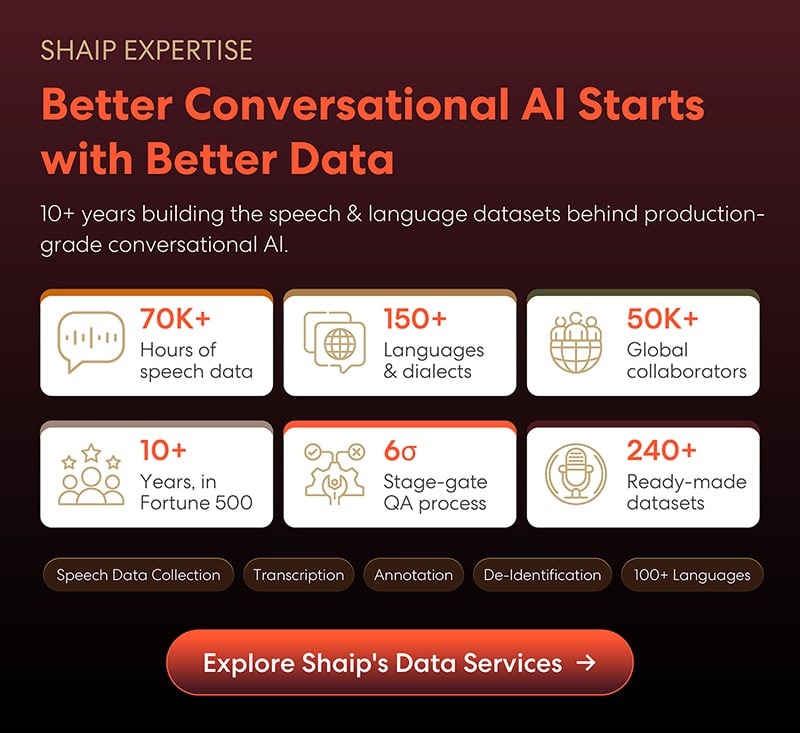
動作するプロトタイプと実用レベルのアシスタントとの間のギャップを埋めることは、データ運用上の問題であり、シャイプ氏が10年以上かけて取り組んできた問題である。
- 70万時間以上 音声データの
- 150以上の言語と方言,
- 50万人以上のグローバルな協力者,
- 10 +年 フォーチュン500企業のAIチームにサービスを提供し、
- a シックスシグマ段階ゲートQAプロセス,
- 240種類以上の既製データセット 納期が限られていて、一から収集する時間がない場合に、既製品として入手可能です。
音声データの収集、文字起こし、注釈付け、匿名化といった一連のプロセスにおいて、目標は同じです。それは、製品が実際に会話する相手を反映したトレーニングデータを作成し、それを証明する同意の記録と品質指標を整備することです。
ボトムライン
対話型AIはもはや技術的な問題ではなくなった。その仕組みは十分に理解され、モデルは広く利用可能になり、あらゆる業界の予算項目にその応用が盛り込まれている。真に難しいのはデータ層、つまりロングテールカバレッジ、ラベルの合意、人口統計学的バランス、同意、そして匿名化である。
そこにこそ、優位性があるのです。同じモデルを使用している2つのチームでも、出荷される製品の品質は大きく異なります。その差は、システムがどのようなデータで学習されたかに起因します。対話型AIを構築する場合、最も重要な決定はアーキテクチャに関するものではありません。データセットに誰の声が含まれているか、それらの声がどれほど適切にラベル付けされているか、そしてそれらを使用する権利があったかどうか、といった点が重要なのです。