テキスト注釈

テキスト注釈: 定義、使用例、種類、利点、課題

機械学習におけるテキスト アノテーションとは何ですか?

機械学習におけるテキスト アノテーションとは、生のテキスト データにメタデータまたはラベルを追加して、機械学習モデルのトレーニング、評価、改善のための構造化データセットを作成することを指します。 これは、アルゴリズムがテキスト入力に基づいて理解、解釈、予測を行うのに役立つため、自然言語処理 (NLP) タスクにおいて重要なステップです。

テキスト注釈は、非構造化テキスト データと構造化された機械可読データとの間のギャップを埋めるのに役立つため、重要です。 これにより、機械学習モデルがアノテーション付きの例からパターンを学習して一般化できるようになります。

高品質のアノテーションは、正確で堅牢なモデルを構築するために不可欠です。 このため、テキスト アノテーションでは、詳細、一貫性、専門知識に細心の注意を払うことが不可欠です。

テキスト注釈の種類

テキスト注釈の種類

NLP アルゴリズムをトレーニングする場合、各プロジェクト固有のニーズに合わせて調整された大規模な注釈付きテキスト データセットを用意することが不可欠です。 そのため、そのようなデータセットを作成したい開発者のために、ここでは XNUMX つの一般的なテキスト アノテーション タイプの簡単な概要を示します。

感情の注釈

センチメントアノテーション

感情の注釈は、テキストの根底にある感情、意見、または態度を特定します。 アノテーターは、テキスト セグメントに肯定的、否定的、または中立的なセンチメント タグを付けます。 この注釈タイプの主要なアプリケーションである感情分析は、ソーシャル メディアの監視、顧客フィードバック分析、市場調査で広く使用されています。

機械学習モデルは、注釈付き感情データセットでトレーニングされると、製品レビュー、ツイート、その他のユーザー生成コンテンツ内の意見を自動的に評価および分類できます。 したがって、AI システムが感情を効果的に分析できるようになります。

インテントのアノテーション

インテントアノテーション

インテント アノテーションは、特定のテキストの背後にある目的や目標を把握することを目的としています。 このタイプのアノテーションでは、アノテーターは、情報を求める、何かを要求する、好みを表現するなど、特定のユーザーの意図を表すテキスト セグメントにラベルを割り当てます。

インテント アノテーションは、AI を活用したチャットボットや仮想アシスタントの開発において特に価値があります。 これらの会話型エージェントは、ユーザー入力をよりよく理解し、適切な応答を提供したり、必要なアクションを実行したりするために、インテント アノテーションが付けられたデータセットでモデルをトレーニングできます。

意味論的な注釈

セマンティックアノテーション

セマンティック アノテーションは、単語、語句、文の間の意味と関係を識別します。 アノテーターは、テキストのセグメント化、文書分析、テキスト抽出などのさまざまな手法を使用して、テキスト要素の意味論的なプロパティにラベルを付けて分類します。

セマンティック アノテーションのアプリケーションには次のものがあります。

  • セマンティック分析: 文脈内の単語やフレーズの意味を調べて解釈し、テキストをよりよく理解できるようにします。
  • ナレッジグラフの構築: エンティティとその関係の相互接続されたネットワークを構築し、複雑な情報を整理して視覚化するのに役立ちます。
  • 情報検索: 大量のテキストのコレクションから関連データを検索して抽出すると、特定の情報に簡単にアクセスできるようになります。

セマンティック アノテーションを備えたデータでトレーニングされた機械学習モデルを使用すると、AI システムは複雑なテキストをよりよく理解し、処理できるようになり、言語理解能力の向上に役立ちます。

エンティティのアノテーション

エンティティの注釈

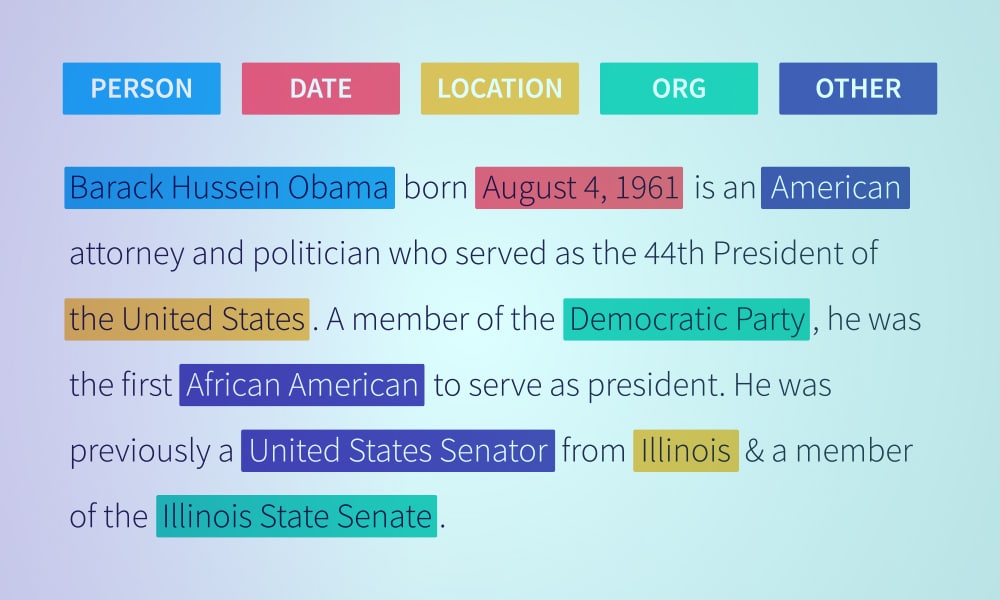
エンティティ アノテーションは、チャットボット トレーニング データセットやその他の NLP データを作成する際に重要です。 これには、テキスト内のエンティティを検索してラベルを付けることが含まれます。 エンティティ アノテーションの種類には次のものがあります。

  • 固有表現認識 (NER): エンティティに特定の名前を付ける。
  • キーフレーズのタグ付け: テキスト内のキーワードまたはキーフレーズを識別してマークします。
  • 品詞 (POS) タグ付け: 形容詞、名詞、動詞などのさまざまな音声要素を認識し、ラベルを付けます。

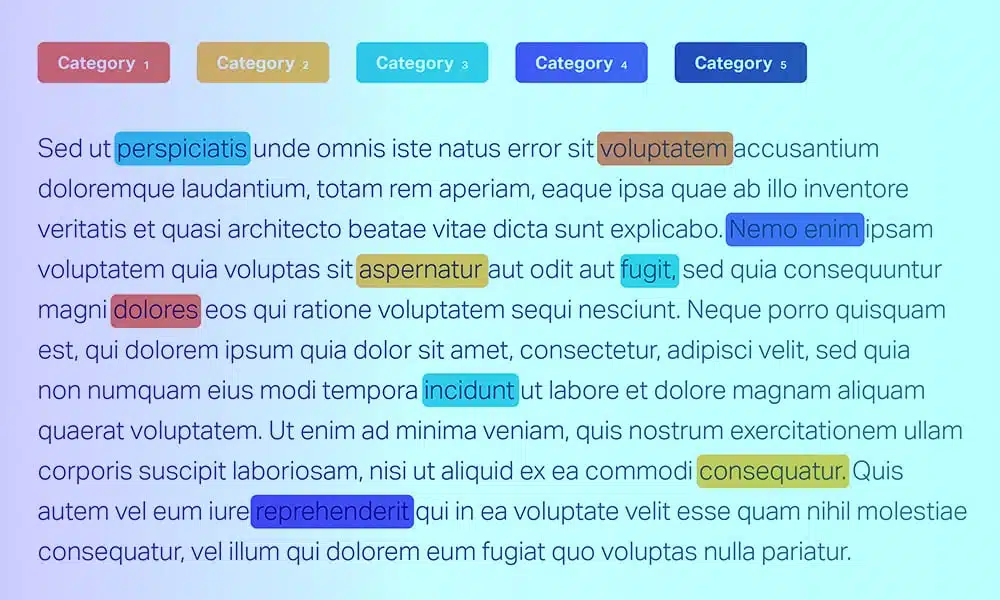
エンティティ アノテーションは、NLP モデルによる品詞の特定、名前付きエンティティの認識、テキスト内のキーフレーズの検出を支援します。 アノテーターはテキストを注意深く読み、ターゲット エンティティを見つけてプラットフォーム上で強調表示し、ラベルのリストから選択します。 NLP モデルによる名前付きエンティティの理解をさらに支援するために、エンティティのアノテーションがエンティティのリンクと組み合わされることがよくあります。

言語的な注釈

言語注釈

言語注釈は、言語の構造的および文法的側面を扱います。 これには、品詞のタグ付け、構文解析、形態素解析などのさまざまなサブタスクが含まれます。

アノテーターは、文法的役割、構文構造、または形態学的特徴に従ってテキスト要素にラベルを付け、テキストの包括的な言語表現を提供します。

AI システムが言語注釈を備えたデータセットでトレーニングされると、言語パターンをよりよく理解し、より明確で正確な結果を生成できます。

関係の注釈

関係注釈

リレーションシップ アノテーションは、ドキュメントのさまざまな部分間の接続を識別してラベル付けします。一般的なタスクには、エンティティ リンク、リレーションシップの抽出、セマンティック ロールのラベル付けなどがあります。手法の選択は、プロジェクトのニーズによって異なります。
例:

次の文を考えてみましょう。「マリー・キュリーは 1898 年にラジウムを発見し、それが医学の大きな進歩につながりました。」

エンティティ関係:マリー・キュリー(人物)がラジウム(物質)を発見した。

時間的関係:この発見は1898年に起こった。

因果関係:この発見は医学の進歩につながった。

これらの関係に注釈を付けると、情報検索や質問への回答などのアプリケーションでテキストの構造と意味を理解するのに役立ちます。

テキスト分類

テキスト分類

テキスト分類とは、テキストを定義済みのラベルに分類することです。これは、スパムの検出、感情の分析、トピックの識別などのタスクに使用されます。選択する方法は、達成したい目標によって異なります。

例:

いくつかの文を見てみましょう:

この映画大好き!最高!」

感情分析:この文は肯定的な感情を持っていると分類されます。

このメールは、無料旅行の特別オファーです。」

スパム検出:このメールはスパムとして分類される可能性が高いです。

今日の株式市場は著しい成長を見せた。」

トピック分類:この文は金融カテゴリに分類されます。

このようにテキストを分類することで、大量の情報を素早く理解することができます。これは、電子メールのフィルタリング、顧客からのフィードバックの分析、コンテンツの整理などに非常に役立ちます。

ユニークなテキスト注釈の使用例

テキスト注釈は、さまざまな業界でさまざまな創造的な方法で適用できる、非常に用途の広いツールです。ここでは、テキスト注釈がどのように効果を発揮するかを示す例とともに、いくつかのユニークな使用例を紹介します。

医療研究とヘルスケア:個別化医療

:患者の診療記録に、詳細な遺伝子情報、治療反応、副作用などを注釈として追加することを想像してみてください。このデータは、患者一人ひとりに合わせた個別治療計画を作成するために活用できます。

応用例:医師は、個々の患者のデータに基づいてカスタマイズされた治療戦略を策定することで、より正確で効果的な医療を提供できるようになります。

財務: 不正行為の検出

:金融機関は、取引ログや通信記録に注釈を付けることで、不正行為を示すパターンを特定することができる。

用途:このシステムは、銀行やその他の金融機関が不正行為をリアルタイムで検知・防止するのに役立ち、金融機関とその顧客の両方を保護します。

小売業と電子商取引:動的価格設定戦略

:競合他社の価格データと顧客の行動パターンに注釈を付けることで、小売業者は価格を動的に調整できるようになります。

応用例:小売業者は、市場状況と消費者の需要に基づいて価格設定を最適化し、競争力を維持しながら利益を最大化することができます。

カスタマーサービスとサポート: 感情検出

:顧客サポートのやり取りに注釈を付けて、会話中の感情状態やセンチメントの変化を検出する。

応用例:顧客サービス担当者は、より共感的かつ効果的に対応できるようになり、顧客満足度と顧客ロイヤルティの向上につながります。

法務とコンプライアンス: 契約ライフサイクル管理

:契約書に重要な条項、更新日、コンプライアンス要件などを注釈として追加することで、管理プロセスを自動化する。

用途:契約管理を効率化し、法令遵守を確保し、法的リスクを軽減することで、法務チームの業務負担を軽減します。

マーケティングとソーシャルメディア: インフルエンサー分析

:ソーシャルメディアの投稿ややり取りに注釈を付けて、マーケティングキャンペーンにおける潜在的なインフルエンサーを特定し、評価する。

応用例:マーケティングチームは、エンゲージメントとオーディエンスへのリーチに基づいて最も効果的なインフルエンサーを選択し、キャンペーンの効果を最適化できます。

データ抽出と検索エンジン最適化: 音声検索の最適化

:音声検索結果の精度と関連性を向上させるために、音声クエリとそのコンテキストに注釈を付ける。

用途:音声対応検索エンジンや仮想アシスタントの性能を向上させ、ユーザーにとってより便利で信頼性の高いものにします。

人事:従業員エンゲージメント分析

:社内コミュニケーション、アンケート、フィードバックに注釈を付けて、従業員のエンゲージメントと士気を測る。

応用例:人事チームは改善すべき点を特定し、前向きで生産的な職場環境を育成することができます。

学術研究:学際的コラボレーション

:異なる研究分野間の連携を促進するために、研究論文に学際的なキーワードと参考文献を注釈として付加する。

用途:研究者が他の分野の関連研究を容易に見つけられるようにすることで、革新的な学際的研究を促進します。

公共サービスと政府:危機管理

:緊急事態や危機発生時の対応を追跡・管理するために、公的報告書、ニュース記事、ソーシャルメディアの投稿に注釈を付ける。

用途:緊急事態発生時に政府機関が国民のニーズに迅速かつ効果的に対応する能力を高め、より優れた危機管理を実現します。

テキスト注釈の利点

データ品質の向上:データの精度を高め、AIや自然言語処理(NLP)アプリケーションにとってより信頼性の高いデータにします。

モデル性能の向上:明確でラベル付けされたデータを提供することで、機械学習モデルのパフォーマンス向上に役立ちます。

カスタマイズとパーソナライズ:特定のニーズに合わせてカスタマイズされた専用データセットを作成できます。

効率的な情報検索:情報をより速く、より簡単に見つけられるようにします。

自動化の強化:様々なタスクの自動化を可能にすることで、手作業を削減します。

洞察力に富んだ分析:生のテキストだけでは明らかにならない、隠れた傾向や洞察を明らかにします。

テキスト注釈の課題

労力を要するプロセス:大量のテキストに注釈を付けるには、多くの時間と労力が必要です。

主観性と一貫性: 同じテキストを人によって解釈が異なる場合があり、矛盾が生じることがあります。

文脈の複雑さ:テキストの文脈を理解し、注釈を付けることは、非常に難しい場合があります。

スケーラビリティの問題: 大規模なデータセットの注釈付けプロセスをスケールアップすることは困難であり、多くのリソースを必要とします。

費用:質の高い注釈は、特に専門家の知識が必要な場合、高額になることがあります。

データプライバシーとセキュリティ:注釈付けの際に機密情報を扱うことは、プライバシーとセキュリティ上の懸念を引き起こします。

テキストデータに注釈を付けるにはどうすればよいですか?

テキストデータのアノテーション処理

  1. 注釈タスクを定義します。 感情分析、固有表現認識、テキスト分類など、対処したい特定の NLP タスクを決定します。
  2. 適切な注釈ツールを選択する: プロジェクトの要件を満たし、必要な注釈タイプをサポートするテキスト注釈ツールまたはプラットフォームを選択します。
  3. 注釈ガイドラインの作成: アノテーターが従うべき明確で一貫したガイドラインを作成し、高品質で正確なアノテーションを保証します。
  4. データを選択して準備します: アノテーターが作業するための、生のテキスト データの多様で代表的なサンプルを収集します。
  5. アノテーターのトレーニングと評価: アノテーターにトレーニングと継続的なフィードバックを提供し、アノテーション プロセスの一貫性と品質を確保します。
  6. データに注釈を付ける: アノテーターは、定義されたガイドラインと注釈タイプに従ってテキストにラベルを付けます。
  7. 注釈を確認して改良する: アノテーションを定期的に確認して改良し、矛盾やエラーがあれば対処し、データセットを繰り返し改善します。
  8. データセットを分割する: アノテーション付きデータをトレーニング、検証、テストのセットに分割して、機械学習モデルをトレーニングおよび評価します。

シャイプはあなたのために何ができるでしょうか?

Shaipは、さまざまな業界のAIおよび機械学習アプリケーションを強化するための、カスタマイズされたテキスト注釈ソリューションを提供します。高品質で正確な注釈に重点を置くShaipの経験豊富なチームと高度な注釈プラットフォームは、多様なテキストデータを処理できます。

感情分析、固有表現認識、テキスト分類のいずれであっても、Shaip は AI モデルの言語理解とパフォーマンスの向上に役立つカスタム データセットを提供します。 

Shaip を信頼して、テキスト注釈プロセスを合理化し、AI システムがその可能性を最大限に発揮できるようにしてください。

この記事をお楽しみいただけましたか?最新情報をもっと知りたい方は、LinkedInでShaipをフォローしてください。

社会シェア