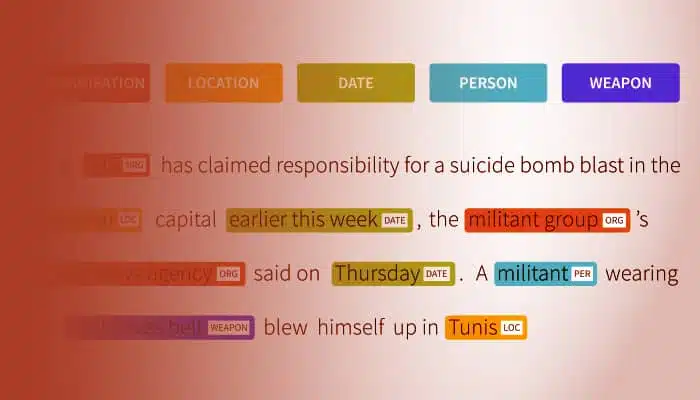
自然言語処理、生成AI、LLMトレーニングのためのテキスト注釈サービス

150以上の言語に対応したテキスト注釈をアウトソーシング – 専門の注釈者によるエンティティ認識、感情分析、分類、LLMトレーニングデータを提供

テキスト注釈

テキストアノテーションが必要な理由、そしてNLPおよびLLMモデルにテキストアノテーションが必要な理由

テキストアノテーションとは、メール、チャットログ、サポートチケット、臨床記録、法的契約書、ソーシャルメディアへの投稿など、構造化されていないテキストにラベルを付けるプロセスであり、自然言語処理(NLP)や大規模言語モデル(LLM)がパターンを学習できるようにするものです。質の高いアノテーション付きトレーニングデータがなければ、最も強力なモデルアーキテクチャであっても性能は低下します。

Shaipでは、4つの主要な用途向けに注釈付きテキストデータセットを作成しています。これらの用途とは、ゼロからモデルをトレーニングすること、オープンソースのLLMを微調整すること、モデルの出力を評価すること、そして人間からのフィードバックを伴う継続的な強化学習(RLHF)を実行することです。すべてのデータセットは、ドメインエキスパートの注釈者によってラベル付けされ、シックスシグマの訓練を受けたQAレビュー担当者によって二重にレビューされ、トレーニングパイプラインが想定するスキーマで提供されます。

もしあなたのデータサイエンスチームが現在、モデル構築ではなくテキストのクリーニングとラベル付けに時間の80%を費やしているとしたら、まさにそのギャップを埋めるためにテキストアノテーションのアウトソーシングが存在するのです。

機械学習のための正確なテキスト注釈

コンセプトに興味をそそられるのと同じくらい、同様のリソースを準備するには、多くの労力、専門的な経験、および専門家レベルの知性が必要になる可能性があります。 ここで、Shaipは信頼できるテキスト注釈会社として登場し、収集されたデータに完全なラベルを付けることに重点を置いています。

Shaipを搭載すると、提供されているAIトレーニングデータが応答、セマンティクス、さらには感情を解釈する準備ができているため、機械学習セットアップの知覚能力について心配する必要がなくなります。

詳細については、テキスト注釈のアウトソーシングパートナーとしてShaipに依存することの追加の利点のいくつかを次に示します。

テキストアノテーションサービス
  • 目標集約型アプローチ
  • コミュニケーションの文脈と明確さに焦点を当てる
  • 言語要素を備えた機械を訓練する能力
  • 徹底的な検索エンジンのラベリング
  • スケーラブルな製品
  • 多言語の機械翻訳

Tsunaguの専門領域

当社が提供するテキスト注釈サービスの種類

自然言語処理(NLP)および生成型AIのあらゆるユースケースは、9つのアノテーション手法のうち1つ以上に該当します。Shaipは、これら9つの手法すべてを、単一のプラットフォーム、単一のプロジェクトマネージャー、および単一の品質フレームワーク内で提供します。

テキスト分類

テキスト分類とトピックタグ付け

スパム検出、トピックルーティング、ニュース分類、意図トリアージ、コンテンツモデレーションのための、シングルラベル、マルチラベル、階層型分類に対応。数百のカテゴリを持つ分類体系にも対応できるよう設計されています。

言語的な注釈

言語学的注釈(品詞、音声、形態)

品詞タグ付け、音声転写、形態素タグ付け、依存関係解析 ― 低リソース言語モデリング、機械翻訳トレーニング、学術コーパスに使用されます。

エンティティのアノテーション

固有表現認識(NER)とエンティティリンキング

私たちは、非構造化テキスト内の人物、組織、場所、日付、金額、医療機関、法的条項、製品コードにタグを付け、それぞれのエンティティを標準的な知識ベース(Wikidata、UMLS、ICD-10、またはクライアントのオントロジー)にリンクします。

Sao(主語動作オブジェクト)

主語-動作-目的語(SAO)および関係性アノテーション

知識グラフ構築、イベント抽出システム、特許情報分析のためのトリプレット抽出。SAOラベリングは、平易な文を機械が理解しやすい構造に変換する。

感情の注釈

感情・情景アノテーション

レビュー、ソーシャルメディアへの投稿、サポートチケット、アンケート回答など、あらゆるコンテンツにおいて、複数の感情分類(肯定的/中立的/否定的)とより詳細な感情ラベル付けが可能です。多言語対応により、文化的なニュアンスも適切に表現します。例えば、英語の皮肉はヒンディー語やアラビア語の皮肉とは異なります。

チャットボットとバーチャルアシスタントのための意図アノテーション

発話レベルの意図とエンティティのラベル付け ― あらゆる対話型AI、IVRのアップグレード、または音声アシスタントスキルの基礎となるデータセット。

共参照解決と文書レベルのリンク

複数文および文書間の共参照 ― 「彼女」「患者」「被告」を正規のエンティティに解決します。長文要約や臨床ナラティブAIにとって不可欠です。

LLMに対する迅速対応およびRLHFラベリング

好みの比較、指示と応答のペア、思考の連鎖的な根拠、レッドチームによる敵対的なプロンプト、および無害性の評価――これらは、現代のLLMの微調整が依存する人間からのフィードバック層である。

文書注釈とOCR後編集

スキャンされたPDF、請求書、電子カルテ、IDカード、構造化フォームへのフィールドレベルのラベル付け ― OCRとヒューマン・イン・ザ・ループ修正を組み合わせ、インテリジェント文書処理(IDP)パイプラインを実現します。

チームがテキスト注釈のアウトソーシングパートナーとしてShaipを選ぶ理由

150以上の言語

主要なインド・ヨーロッパ語族、シナ・チベット語族、アフロ・アジア語族、オーストロネシア語族、およびリソースの少ないインド系言語とアフリカ系言語を含む、すべての言語におけるアノテーターによる対応範囲。多言語の感情分析、固有表現認識(NER)、および意図分析を1つの作業範囲記述書(SOW)で提供。

シックスシグマ品質フレームワーク

シックスシグマ・ブラックベルトが管理するプロセス。2段階の注釈付け+品質保証(QA)ワークフロー。プロジェクトごとに目標閾値を設定した、継続的なIAA(注釈者間一致度)モニタリング。

堅牢な注釈プラットフォーム

ウェブベースで、監査ログ機能付き、役割別にセグメント化された注釈インターフェース。テキスト、音声、画像を1つのワークフローでサポートするため、ロードマップにマルチモーダル注釈が含まれている場合に便利です。

ドメイン特化型アノテーター

アノテーション専門家は分野別に配置されます。医療プロジェクトには臨床専門家、法律関連プロジェクトには法務博士号取得者、資本市場関連業務には金融系卒業生、多言語プロジェクトにはネイティブスピーカーが担当します。

堅牢なコンプライアンス

HIPAA、GDPR、SOC 2、ISO 27001準拠 - 医療従事者向けPHI、EU個人データ、SOC 2タイプIIセキュリティに関する監査済み管理体制。データを見る前に、個人情報(PII)のマスキング処理が可能です。

柔軟な商用モデル

ラベル付きオブジェクトごと、注釈時間ごと、プロジェクトごと、または完全管理型のリテーナー契約ごとに料金が発生します。 

Shaipにテキスト注釈サービスをアウトソーシングする理由

テキスト注釈のアウトソーシングはコスト削減のためではなく、スピードアップのための決定です。社内チームがテキストラベル付けをShaipに委託する4つの理由:

データサイエンティストを80%の時間的負担から解放しましょう

業界のベンチマークによると、データサイエンスチームの作業時間の80%はデータのクリーニングと準備に費やされています。テキスト注釈をアウトソーシングすることで、その分のリソースをモデル開発、エラー分析、本番環境への展開といった、データサイエンティストが本来行うべき業務に振り向けることができます。

専門知識に基づいた質の高い仕事、一般的な仕事ではない

臨床医は診療記録に初回で正しく注釈を付けます。パラリーガルは契約書に初回で正しく注釈を付けます。しかし、クラウドソーシングであれ社内の若手スタッフであれ、一般的な注釈チームは作業を2、3回やり直します。ドメインルーティングは、この品質保証のループを解消します。

必要に応じて柔軟な規模調整が可能

アノテーションの量は、均等に発生することは稀です。パイロット段階では10人のアノテーターが必要ですが、ローンチ前段階では300人、本番環境の保守段階では20人が必要になります。アウトソーシングによって人員リスクは変動費に転換され、採用・研修・維持のサイクルが不要になります。

内部の偏見を排除する

単一のチーム、地域、または背景から集められたアノテータープールは、意図せずして彼らの世界観をモデルに反映させてしまいます。複数の地域、複数の背景を持つアノテータープールを、バイアスを考慮した品質保証サンプリングと組み合わせることで、モデルが実際にサービスを提供する対象集団全体に一般化できるデータセットが生成されます。

提供されるサービス

エキスパートの画像データ収集は、包括的なAIセットアップのためのすべてのハンズオンデッキではありません。 Shaipでは、次のサービスを検討して、モデルを通常よりもはるかに普及させることもできます。

音声注釈

音声注釈サービス

音声認識、話者のダイアリゼーション、感情認識などの関連ツールを介して、オーディオソース、音声、および音声固有のデータセットにラベルを付けることは、Shaipが得意とするものです。
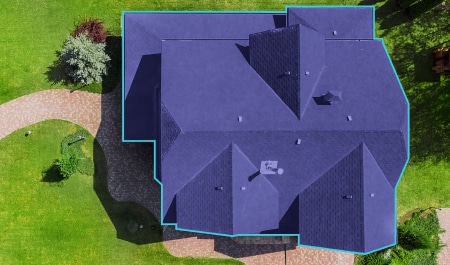
画像注釈

画像注釈サービス

私たちは、目の肥えたコンピュータービジョンモデルをトレーニングするために、セグメント化された画像データセットにラベルを付けることに誇りを持っています。 関連する手法には、境界認識と画像分類が含まれます。
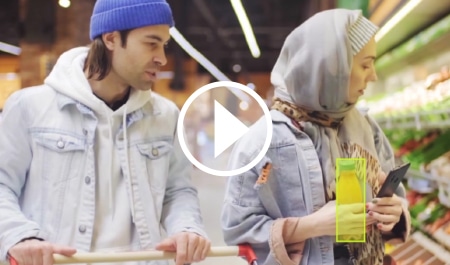
ビデオの注釈

ビデオ注釈サービス

Shaip は、コンピューター ビジョン モデルのトレーニング用のハイエンドのビデオ ラベリング サービスを提供しています。
ここでの目的は、パターン認識、オブジェクト検出などのツールでデータセットを使用できるようにすることです。

注目のクライアント

チームが世界をリードするAI製品を構築できるようにします。

パイプラインのNLPシステム? アバンギャルドなテキストラベリングサービスに投資する–当社の専門家が複雑なラベリングを担当します

テキストアノテーションとは、メール、契約書、サポートチケット、臨床記録、ソーシャルメディアへの投稿など、構造化されていないテキストに構造化されたタグを付与するプロセスです。これにより、自然言語処理(NLP)や大規模言語モデルがテキスト内のパターンを学習できるようになります。一般的なアノテーションの種類には、固有表現認識(NER)、感情分析、意図アノテーション、テキスト分類、エンティティリンキング、SAO(主語-動作-目的語)タグ付けなどがあります。テキストアノテーションは、あらゆる実稼働中のNLPシステム、あらゆるチャットボット、あらゆるドメイン固有の言語モデル(LLM)、そしてあらゆる最新のドキュメントAIパイプラインの基盤となっています。

決定は通常、次の 3 つの要因に左右されます。(1) スピード:社内チームは通常、アノテーターの採用とトレーニングに 8〜12 週間かかりますが、アウトソーシングでは 7〜14 日以内にラベル付きデータが生成され始めます。(2) 品質:ドメインのトレーニングを受けたアウトソーシングのアノテーターは、特に医療、法律、金融のテキストにおいて、汎用的な社内チームよりも高いアノテーター間の一致率を実現します。(3) コスト弾力性:アノテーションの量は変動します。アウトソーシングでは、固定の人員コストがオブジェクトごとまたは時間ごとの変動コストに変換されます。ほとんどのチームは、大部分をアウトソーシングし、少数の社内 QA レビュー担当者プールを維持します。これがハイブリッド モデルです。

Shaip は、世界的な専門知識と高度なツールを使用して多言語プロジェクトを管理し、さまざまな言語と地域にわたって正確なラベル付けを保証します。

テキスト注釈は、エンティティ、意図、感情をタグ付けすることでチャットボットや仮想アシスタントがユーザーのクエリを理解するのに役立ち、正確でコンテキストに応じた応答を提供できるようになります。

Shaip は、NLP モデルを効果的にトレーニングするためのエンティティ アノテーション、感情アノテーション、テキスト分類、エンティティ リンク、主語-アクション-オブジェクト (SAO) アノテーション、言語アノテーションなどのサービスを提供しています。

テキスト注釈は、肯定的、否定的、中立的などの感情をデータにタグ付けし、AI が意見や感情を検出して、より優れた顧客フィードバック分析を行うことを可能にします。

エンティティ注釈は、名前、日付、場所などの重要な情報を識別し、チャットボットが関連性のあるパーソナライズされた応答を提供できるようにします。

Shaip は、意味分析、知識リンク、品詞タグ付けなどの高度な注釈ツールとテクニックを使用して、高品質の結果を保証します。

Shaip は、厳格な品質管理プロセス、多層レビュー、専門の注釈者を採用して、AI トレーニングに適した正確で偏りのないデータセットを提供します。

課題には、データの一貫性の維持、ドメイン固有のデータの処理、多言語プロジェクトの管理などがあります。Shaipは、スケーラビリティ、専門知識、そして堅牢な品質保証によってこれらの課題に対処します。

Shaip は、医療データ分析、パーソナライズされた推奨事項、翻訳システムなどのタスク向けに AI モデルをトレーニングすることで、ヘルスケア、e コマース、会話型 AI、テクノロジーの分野におけるアプリケーションをサポートします。

はい。Shaipは、LLM固有の4つのアノテーションワークフローを実行します。具体的には、教師ありファインチューニング(SFT)による指示応答ペアの作成、RLHFの選好比較と根拠ラベル付け、検索の忠実度と引用の正確性を評価するRAG、そして敵対的プロンプトと無害性スコアリングのためのレッドチーム機能です。出力はJSONLまたはOpenAIチャット形式で提供され、Hugging Face、OpenAIファインチューニング、またはカスタムトレーニングパイプラインに直接取り込むことができます。
