光学文字認識(OCR)は現在、レシートのスキャン、本人確認、請求書の自動化、歴史的アーカイブのデジタル化、スタイラスペンを使ったメモアプリなどに活用されています。OCR市場は、2030年までに年平均成長率(CAGR)14.8%で32.90億ドルに達すると予測されており(Grand View Research、2024年)、手書き文字認識(OCRの分野)が最も急速に成長しています。文書解析、シーンテキスト検出、手書き文字転写など、どのようなアプリケーションを構築する場合でも、トレーニングに使用するOCRデータセットによって精度の上限が決まります。このガイドでは、2024年までの最新リリースで更新された、ユースケース別に整理された22種類の無料のオープンソースOCRデータセット(最高の手書きデータセットを含む)を紹介します。
主要なポイント(要点)
- OCR (光学式文字認識): 印刷物、風景、手書き文字などの画像を機械可読データに変換する技術。
- OCRデータセットは、文書/フォーム、シーンテキスト、数字/文字、手書き文字、多言語の5つのグループに分類されます。
- 文書OCRデータセット フォームや領収書などの構造化されたページをキャプチャする。 シーンテキストデータセット 「実環境」でテキストをキャプチャする。
- IAM、MNIST、ICDAR、およびSROIEは、研究において最も多く引用されているOCRベンチマークであり続けている。
- ライセンス条件は大きく異なるため、商用トレーニングを行う前に各OCRデータセットを必ず確認してください。
OCR(光学式文字認識)とは何ですか?
OCR は、スキャンした紙の文書、PDF、テキスト画像など、さまざまな種類の文書を編集および検索可能なデータに変換するテクノロジーです。その仕組みは次のとおりです。
- 画像内のテキストの構造を分析する
- テキストを行と文字に分解する
- これらの視覚的な文字を機械が読めるテキストに変換する
一般的な用途には次のようなものがあります。
- スキャンした文書を編集可能なテキストファイルに変換する
- 印刷された書籍のデジタル化
- 写真からテキストを抽出する
- 手書きの処方箋をデジタルテキストに変換する
- ナンバープレート認識
適切なOCRデータセットはどのように選べばよいのでしょうか?
OCRデータセットの選択は、テキストの種類、キャプチャ環境、注釈の粒度、ライセンスの4つの要素に依存します。印刷文書のOCRには、手書きの筆記体や曲線的なシーンテキストとは異なるトレーニングデータが必要です。文書データセットは請求書、フォーム、領収書に適しており、シーンテキストデータセットは看板や製品の読み上げに適しており、手書きデータセットはメモ、原稿、スタイラス入力に適しています。単語レベルおよび行レベルの注釈は完全なOCRパイプラインをサポートし、文字レベルのセットは分類のベースラインに適合します。OCRデータセットの中には研究専用であったり、登録が必要なものもあるため、必ずライセンス条項を確認してください。
文書やフォームのOCRデータセットとして最適なものは何ですか?
文書OCRデータセットは、請求書、フォーム、領収書、IDカードなどの構造化されたページを解析するモデルをトレーニングします。これらは、ビジネス文書の自動化とキーバリュー抽出の基盤となります。
- 楽しい — ノイズが多く、実際の使用感を反映した、注釈付きのスキャン済みフォーム199点。フォームの理解とキーバリュー抽出における標準的なベンチマーク。
- スロイ — ICDAR 2019 スキャン済みレシートデータセット。約 1,000 枚のレシートが含まれており、単一のセットでテキスト検出、認識、および情報抽出をサポートします。
- コード — OCR後の解析用に構築された統合レシートデータセット。請求書とレシートの自動化に役立つ、豊富なフィールドレベルのラベルが含まれています。
- Xファンド — FUNSDの多言語対応版。ドイツ語、スペイン語、フランス語、イタリア語、日本語、ポルトガル語、中国語の7言語に対応し、各言語199ページで構成されています。多言語文書AIに最適です。
- DDI-100 — 歪み、ぼやけ、ノイズなどの現実世界の劣化条件下での検出と認識のために、約100,000万枚の歪んだ文書画像を用意しました。
最適なシーンテキストOCRデータセットは何ですか?
シーンテキストOCRデータセットは、看板、商品、街並みなどの自然画像内のテキストを読み取るためのモデルを訓練します。これらは、背景が雑然としている実環境におけるOCRにとって不可欠です。
- ICDARロバストリーディング — 単語レベルの境界ボックスと文字起こしを用いた「フォーカスドシーンテキスト」と「インシデンタルシーンテキスト」の課題を含む、ほとんどのシーンテキスト研究のベンチマークファミリー。
- COCOテキスト — MS-COCO画像上に重ね合わせた大規模なシーンテキスト注釈。自然シーンにおける大規模なテキスト検出に高い性能を発揮します。
- 全文 — 曲線状のテキストや、向きが不規則なテキストの認識に特化しており、これは従来のOCRモデルの弱点として知られています。
- SVT(ストリートビューテキスト) — Googleストリートビューから収集した単語画像。解像度が低く、ばらつきが大きい場合が多い。Papers with Codeのミラーサイトから入手可能。
- 階層テキスト 段落から行、単語へと階層的に注釈を付け、手書きと印刷されたシーンテキストの両方に対応します。レイアウトを考慮したOCRに役立ちます。
最適な数字・文字OCRデータセットは何ですか?
数字および文字OCRデータセットは、制御された環境下で個々の記号を認識するようにモデルを訓練するために使用されます。これらは、分類基準の標準的な出発点となります。
- MNIST — 70,000万枚のグレースケール手書き数字画像。数字分類器の検証に最も迅速なベースラインとなる。
- エミニスト — NIST特別データベース19から抽出した814,255の手書き文字と数字でMNISTを拡張します。
- SVHN(ストリートビューの家屋番号) — 住宅番号から抽出した600,000万枚以上の実世界の数字画像。騒音環境下におけるMNISTよりも実用的なレベルアップを実現。
- Chars74K — 自然画像とコンピューターフォントから抽出した、英語とカンナダ語の文字を網羅した74,107枚の画像。
- NIST特別データベース19 — 3,600人の筆者による810,000万点以上の手書き文字画像。多くの英語OCRベンチマークの基となるデータソース。
OCRに最適な手書き文字データセットは何ですか?
手書き文字データセットは、OCRモデルが筆記体、活字体、および歴史的な手書き文字を読み取るためのトレーニングに使用されます。最も強力なオープン手書き文字データセットは、手書き文字認識(HTR)のベンチマークとして最も頻繁に引用されています。
- IAM手書きデータベース — 英語の手書き文字のゴールドスタンダード。657人の筆者による13,353行のテキストデータを含む。2024年から2025年にかけてのOCR研究において、依然として最も多く引用されている手書き文字データセット。
- IAM-OnDB — IAMのオンライン版(ペンストローク版)で、軌跡データを取得します。スタイラスペンやタブレット端末の認識における標準的な手書きデータセットです。
- ベンサム文書 — 哲学者ジェレミー・ベンサムの歴史的な英語写本を転写したもの。歴史的筆跡OCRの主要なベンチマークであり、Transkribusを通じてアクセス可能です。
- GNHK(GoodNotes手書きコレクション) — 2021年に収集された、制約のない実世界の英語手書きメモのデータセット。ラボで整理されたIAMデータよりも、実際の運用データに近い。
多言語対応でラテン語以外の言語に対応した、最適なOCRデータセットは何ですか?
多言語OCRデータセットは、英語以外の言語(中国語、アラビア語、数式表記など)に対応したモデルを学習させるために使用されます。これらは、グローバルな文書認識および手書き文字認識に不可欠です。
- CASIA-HWDB — 標準的な中国語OCRベンチマーク。1,020人の筆者による1.17万文字の手書きサンプルを使用。
- カット — 1,000人の異なる筆者による1,000点のアラビア語手書き文書を、複数の解像度でスキャンしたもの。最も包括的なオープンなアラビア語OCRデータセットです。
- クローム — オンライン手書き数式認識コンテスト:101種類以上の数式記号を用いた10,000種類以上の数式を、オンラインとオフラインの両方の形式で収録。手書き数式のOCRに不可欠。
無料のOCRデータセットを使用する際によくある落とし穴は何ですか?
ほとんどのチームが陥る3つの落とし穴。
ドメインの不一致:クリーンなIAMまたはCOCO-Textで学習し、しわくちゃの請求書に適用すると、精度が低下することが保証されます。
ライセンスに関する注意点:いくつかのシーンテキストおよび歴史的OCRデータセットは、研究専用であるか、商用利用前に登録が必要です。
アノテーションの不足:多くのOCRデータセットには、実運用システムが必要とするレイアウトメタデータ、行レベルの境界ボックス、またはフィールドラベルが欠けている。
中規模の物流会社が配送ラベルの読み取りを自動化しようとしている状況を想像してみてください。公開されているシーンテキストを使ったトレーニングではベンチマークで80%の正答率を達成できますが、反射や折り目のある実際のラベルでは58%にまで低下します。このギャップを埋めるには、サービス開始前に6,000枚の該当分野のラベル画像を対象としたデータアノテーションが必要でした。
オープンソース データセットの利点と課題
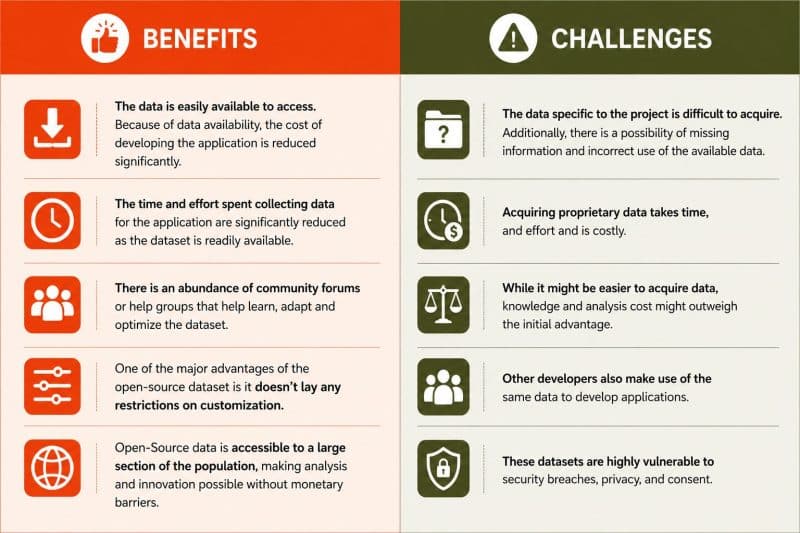
企業は、ML アプリケーションに無料で使用できるデータを選択する必要があるかどうかを理解するために、利点と課題を互いに突き合わせる必要があります。
公式サイト限定
- データは簡単にアクセスできます。 データの可用性により、アプリケーションの開発コストが大幅に削減されます。
- データセットがすぐに利用できるため、アプリケーションのデータ収集に費やす時間と労力が大幅に削減されます。
- データセットの学習、適応、最適化を支援するコミュニティ フォーラムやヘルプ グループが豊富にあります。
- オープンソース データセットの主な利点の XNUMX つは、カスタマイズに制限がないことです。
- オープンソースのデータは人口の大部分がアクセスできるため、金銭的な障壁なしに分析とイノベーションが可能になります。
チャレンジ
- プロジェクト固有のデータを取得するのは困難です。 さらに、情報の欠落や利用可能なデータの誤った使用の可能性があります。
- 専有データの取得には時間と労力がかかり、費用がかかります
- データの取得は簡単かもしれませんが、知識と分析のコストが最初の利点を上回る可能性があります。
- 他の開発者も同じデータを利用してアプリケーションを開発しています。
- これらのデータセットは、セキュリティ違反、プライバシー、および同意に対して非常に脆弱です。
ShaipはOCRおよび手書き文字認識プロジェクトをどのようにサポートしていますか?
ShaipのOCRトレーニングデータサービスは、オープンデータセットのキュレーションと、印刷文書、手書き文字、領収書、IDカードなど60以上の言語に対応したカスタムデータ収集を組み合わせています。Shaipのアノテーションワークフローは、公開OCRデータセットにはないレイヤー、すなわち行レベルの境界ボックス、フィールドレベルのラベル、文字起こし品質管理、および筆者メタデータを追加します。
結論
上記の22種類のOCRデータセットは、文書、シーンテキスト、数字、手書き文字、多言語認識など、2026年までを網羅する包括的なオープンソース基盤を提供します。まずは、テキストの種類とキャプチャ環境に合ったOCRデータセットを選択し、実際のデータから抽出したサンプルで検証を行い、ドメインのギャップを埋めるためのカスタムアノテーション費用を予算に計上してください。この組み合わせは、ゼロから構築するよりも迅速に導入できます。