AIソリューションを開発している場合、製品の市場投入までの時間は、トレーニング目的での高品質のデータセットのタイムリーな可用性に大きく依存しています。 モデルのトレーニングプロセスを開始し、結果を最適化し、ソリューションをリリースに向けて準備するために必要なデータセットが手元にある場合にのみ。
ご存知の通り、質の高いデータセットを期日までに取得することは、あらゆる規模の企業にとって困難な課題です。ご存知ない方のために説明すると、企業の約19%が、データの入手困難さがAIソリューションの導入を阻んでいると回答しています。
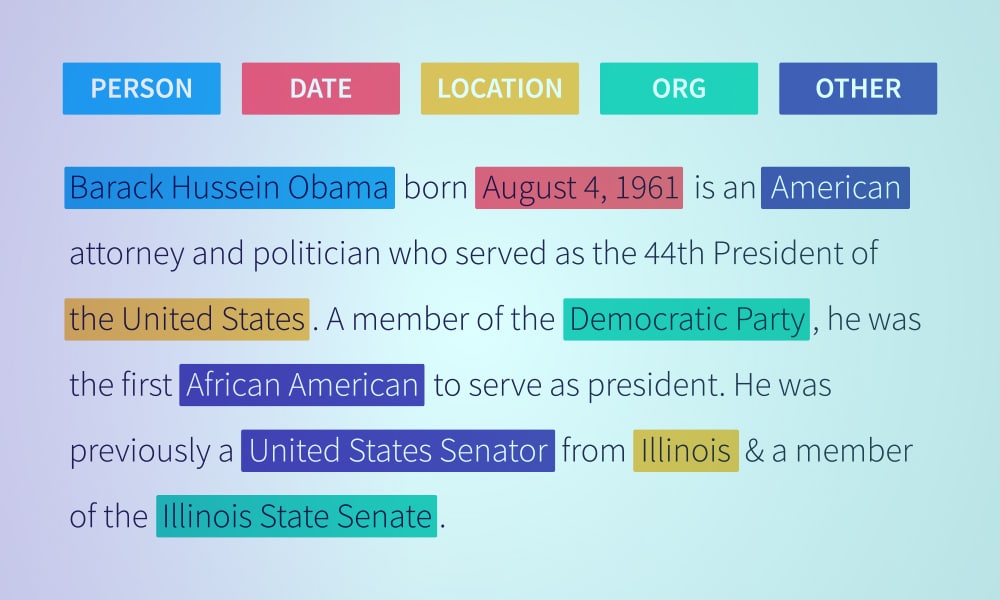
また、関連性のある文脈に沿ったデータを生成できたとしても、データアノテーション自体が大きな課題であることを理解しておく必要があります。アノテーションは時間がかかり、高度なスキルと細部への注意力が求められます。AI開発時間の約80%は、データセットのアノテーションに費やされます。
現在、データ注釈プロセスはAIトレーニングの支点であるため、システムから完全に排除することはできません。 注釈付きのデータが手元にない場合、モデルは結果(品質の結果は言うまでもなく)を提供できません。 これまで、データベースの課題、注釈手法などに関する無数のトピックについて説明してきました。 今日は、データのラベル付け自体を中心に展開するもうXNUMXつの重要な側面について説明します。
この投稿では、スペクトル全体で使用されるXNUMX種類のアノテーションメソッドについて説明します。
- 手動データラベリング
- そして自動データラベリング
本稿では、両者の違い、手動による介入が重要な理由、そして自動データラベリングに伴うリスクについて明らかにします。
手動データラベリング
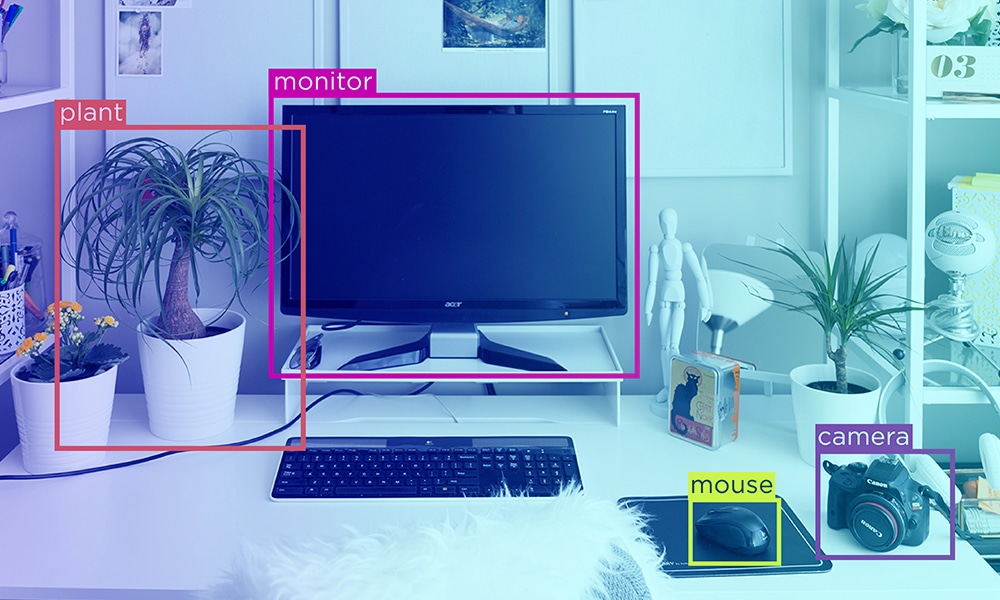
名前が示すように、手動のデータラベル付けには人間が関与します。 データ注釈の専門家は、データセット内の要素のタグ付けを担当します。 専門家とは、注釈を付ける内容を正確に知っているSMEおよびドメイン当局を意味します。 手動プロセスは、注釈用の生のデータセットがアノテーターに提供されることから始まります。 データセットは、画像、ビデオファイル、音声録音またはトランスクリプト、テキスト、またはこれらの組み合わせである可能性があります。
プロジェクト、必要な結果、および仕様に基づいて、アノテーターは関連する要素に注釈を付ける作業を行います。 専門家は、特定のデータセットと目的に最適な手法を知っています。 彼らはプロジェクトに適切な手法を使用し、トレーニング可能なデータセットを時間どおりに提供します。
手動ラベル付けはプロセスの一部にすぎませんが、注釈ワークフローには品質チェックと監査と呼ばれるXNUMX番目のフェーズがあります。 この場合、注釈付きデータセットの信頼性と精度が検証されます。 これを行うために、企業はコンセンサス方式を採用しています。この方式では、複数の注釈が同じデータセットに対して機能し、全員一致の結果が得られます。 コメントやフラグ付けの場合も、不一致は解決されます。 注釈プロセスと比較すると、品質チェックフェーズはそれほど手間がかからず、時間もかかりません。
自動データラベリング
これで、データのラベル付けにどれだけの手作業がかかるかがわかりました。 ヘルスケア、精度、細部への注意などの分野で使用されるソリューションにとって、ますます重要になります。 より高速なデータラベリングと注釈付きデータの配信への道を開くために、自動データラベリングモデルが徐々に目立つようになっています。
この方法では、AIシステムがデータの注釈を処理します。 これは、ヒューリスティック手法または機械学習モデル、あるいはその両方の助けを借りて実現されます。 ヒューリスティックな方法では、特定のラベルを検証するために、単一のデータセットが一連の事前定義されたルールまたは条件を通過します。 条件は人間によって定められています。
これは効率的ですが、データ構造が頻繁に変更されると、この方法は失敗します。 また、情報に基づいた意思決定を行うためにシステムを駆動するには、条件のレイアウトが複雑になります。 人間はアイスクリームとレモネードを区別することができますが、脳が区別を思い付くために取るアプローチはわかりません。 これを複製することは、機械では人間的に不可能です。
これは、AIシステムからの結果の品質に関して多くの懸念を引き起こします。 自動化が始まったとしても、データラベルを検証して修正するには、人間(またはそれらの束)が必要です。 そして、これは次のセクションへの優れたセグエです。
AI支援アノテーション:インテリジェンスには頭脳が必要(ハイブリッドアプローチ)
最良の結果を得るには、ハイブリッドアプローチが必要です。 AIシステムはより高速なラベリングを処理できますが、人間は結果を検証して最適化できます。 データ注釈のプロセス全体をマシンの手に委ねることは悪い考えである可能性があり、そのため、人間をループに入れることは完全に理にかなっています。
確立されたバランスがあり、プロセスは費用効果の高い方法でも発生する可能性があります。 専門家は、より良いラベルを作成するためにマシン用に最適化されたフィードバックループを考え出すことができ、最終的には手作業の必要性を減らすことができます。 マシンの信頼スコアが大幅に向上すると、ラベル付けされたデータの品質も向上します。
完全に自律的なデータラベリングメカニズムは、少なくとも現時点では機能しません。必要なのは、面倒な作業を人間と機械が調和して行うことです。これにより、注釈付きデータセットの提供時間も短縮され、企業はAIトレーニングフェーズをスムーズに開始できます。AIモデル用の高品質データセットをお探しの場合は、ぜひ今すぐお問い合わせください。