

固有表現認識は、自然言語処理(NLP)技術の一つで、プレーンテキストの中から重要な事実を見つけ出し、それが人、組織、場所、日付、金額などであることをラベル付けします。固有表現認識(NER)は、非構造化テキストの中から「固有表現」を見つけ出し、あらかじめ定義されたカテゴリに分類するNLPタスクです。NERの正式名称は単に固有表現認識であり、機械が生の言語を構造化された利用可能なデータに変換する方法の中核を成すものです。
なぜ今これが重要なのでしょうか?それは、テキストの中に秘められた価値が爆発的に高まっているからです。世界の自然言語処理(NLP)市場は2024年に597億米ドルと評価され、2030年には4398億5000万米ドルに達すると予測されており、年平均成長率(CAGR)は38.7%です(Grand View Research、2024年)。固有表現認識(NER)は、検索エンジン、チャットボット、臨床データパイプラインなどを静かに支える、この成長を牽引する主要なタスクの1つです。
NERは、重要な単語をマークし、それぞれの単語の意味を余白に書き込むという、2つの役割を同時に果たす蛍光ペンのようなものだと考えてください。人間はこれを本能的に行います。「スティーブ・ジョブズ」と聞けば、すぐに「人物」「アップル」「カリフォルニア」を連想します。コンピューターにはそのような本能はありません。これらのカテゴリーを認識するように訓練する必要があり、その訓練において質の高いデータが重要な役割を果たすのです。
主要なポイント(要点)
- NERは、テキスト中の人物、組織、場所、日付などのエンティティを識別し、分類します。
- 「NER」の正式名称は「固有表現認識」であり、自然言語処理の中核となるタスクです。
- 現代の固有表現認識(NER)は、主にディープラーニングとBERTのようなトランスフォーマーモデルに依存している。
- BIOやIOBESなどのタグ付け方式は、各エンティティの開始位置と終了位置を示す。
- 固有表現認識(NER)の品質は、高品質で適切に注釈が付けられたトレーニングデータに依存します。
- 一般的な用途:検索、チャットボット、医療記録、金融、法律審査。
名前エンティティ認識 (NER) とは何ですか?
固有表現認識( NER)は、自然言語処理(NLP)の一部です。NERの主な目的は、構造化データと非構造化データを処理し、これらの固有表現を事前に定義されたカテゴリに分類することです。一般的なカテゴリには、名前、場所、会社名、時間、金額、イベントなどがあります。
一言で言えば、NERは以下を扱います。
- 固有表現認識/検出 – 文書内の単語または単語の連続を識別します。
- 固有表現分類 – 検出されたすべてのエンティティを事前定義されたカテゴリに分類します。
しかし、NERはNLPとどのように関連していますか?
自然言語処理は、音声やテキストから意味を抽出できるインテリジェントな機械の開発に役立ちます。機械学習は、大量の自然言語データセットを用いて学習することで、これらのインテリジェントシステムが継続的に学習できるよう支援します。
一般に、NLPは次のXNUMXつの主要なカテゴリで構成されています。
- 言語の構造と規則を理解する– 構文
- 単語、テキスト、スピーチの意味を導き出し、それらの関係を特定する– 意味論
- 話し言葉を識別して認識し、それらをテキストに変換する –スピーチ
NER は、NLP の意味部分を支援し、単語の意味を抽出し、単語の関係に基づいて単語を識別して特定します。
一般的な NER エンティティ タイプの詳細
名前付きエンティティ認識モデルは、エンティティをさまざまな定義済みタイプに分類します。これらのタイプを理解することは、NER を効果的に活用するために不可欠です。最も一般的なタイプのいくつかを詳しく見てみましょう。
- 人(PER): 個人の名前(ファーストネーム、ミドルネーム、ラストネーム、敬称、敬称を含む)を識別します。例: ネルソン マンデラ、ジェーン ドウ博士
- 組織 (ORG): 企業、機関、政府機関、その他の組織化されたグループを認識します。例: Google、世界保健機関、国連
- 場所 (LOC): 国、都市、州、住所、ランドマークなどの地理的位置を検出します。例: ロンドン、エベレスト、タイムズスクエア
- 日付 (DATE): さまざまな形式で日付を抽出します。例: 1 年 2024 月 2024 日、01-01-XNUMX
- 時間 (TIME): 時間表現を識別します。例: 3:00 PM、15:00
- 数量 (QUANTITY): 数値と測定単位を認識します。例: 10 キログラム、2 リットル
- パーセンテージ (パーセント): パーセンテージを検出します。例: 50%、0.5
- お金(MONEY): 金銭的価値と通貨を抽出します。例: $100、€50
- その他(MISC): 他のタイプに当てはまらないエンティティを包括するカテゴリ。例: ノーベル賞、iPhone 15 インチ
固有表現の認識の例
あらかじめ定められたエンティティ分類の一般的な例としては、以下のようなものがあります。
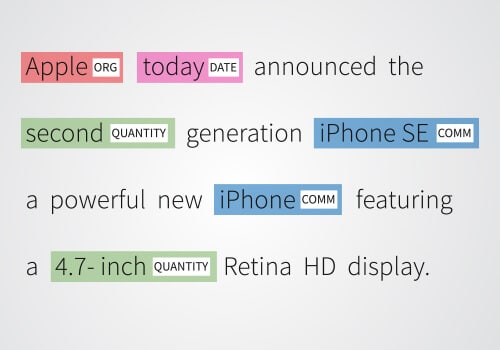
Apple: ORG (組織) と表示され、赤色で強調表示されます。Today: DATE と表示され、ピンク色で強調表示されます。Second: QUANTITY と表示され、緑色で強調表示されます。iPhone SE: COMM (商用製品) と表示され、青色で強調表示されます。4.7 インチ: QUANTITY と表示され、緑色で強調表示されます。
固有表現抽出のあいまいさ
用語が属するカテゴリは、人間にとって直感的に非常に明確です。 ただし、コンピュータの場合はそうではありません。分類の問題が発生します。 例えば:
マンチェスター・シティ(組織)はプレミアリーグのトロフィーを獲得したが、次の文では組織は異なる意味で使われている。マンチェスター・シティ(場所)は繊維産業と工業の中心地だった。
NERモデルは、正確なエンティティ抽出を行うためにトレーニングデータを必要とし、学習したパターンに基づいて固有表現を分類します。シェイクスピア英語でモデルをトレーニングした場合、言うまでもなくInstagramの文章を解読することはできません。NERモデルは、データセット内の正しい、手動でラベル付けされたエンティティであるグラウンドトゥルースアノテーションと予測値を比較することで評価されます。
名前付きエンティティの認識はどのように機能しますか?
固有表現認識 (NER) の領域を深く掘り下げると、いくつかのフェーズで構成される体系的な取り組みが明らかになります。
トークン化
最初に、テキスト データが、単語から文までの、トークンと呼ばれる小さな単位に分割されます。 たとえば、「バラク・オバマは米国大統領だった」というステートメントは、「バラク」、「オバマ」、「だった」、「その」、「大統領」、「の」、「その」、「」などのトークンに分割されます。アメリカ合衆国"。
エンティティの検出
言語ガイドラインと統計的手法を組み合わせて利用し、潜在的な名前付きエンティティにスポットライトを当てます。 この段階では、名前の大文字化 (「Barack Obama」) や明確な形式 (日付など) などのパターンを認識することが重要です。
エンティティの分類
検出後、エンティティは「人物」、「組織」、「場所」などの事前定義されたカテゴリに分類されます。 多くの場合、ラベル付きデータセットで育成された機械学習モデルがこの分類を推進します。 ここでは、「人物」として「バラク・オバマ」、「場所」として「米国」がタグ付けされています。
状況に応じた評価
NER システムの優れた性能は、周囲のコンテキストを評価することで増幅されることがよくあります。 たとえば、「ワシントンは歴史的な出来事を目撃した」というフレーズでは、文脈は「ワシントン」が人の名前ではなく場所であることを識別するのに役立ちます。
評価後の絞り込み
最初の識別と分類に続いて、結果を磨き上げるために評価後の改良が続く場合があります。 この段階では、曖昧さに対処したり、マルチトークン エンティティを融合したり、ナレッジ ベースを利用してエンティティ データを強化したりできます。
この詳細なアプローチは、NER の中核をわかりやすくするだけでなく、検索エンジン向けにコンテンツを最適化し、NER が具体化する複雑なプロセスの可視性を高めます。
主な固有表現認識(NER)の手法は何ですか?
NERモデルの主な目的は、テキスト文書内のエンティティにラベルを付け、それらを分類することです。この目的のために、一般的に以下の3つのアプローチが使用されます。ただし、1つまたは複数の方法を組み合わせることも可能です。NERシステムを作成するためのさまざまなアプローチは次のとおりです。

辞書ベースのシステム
辞書ベースのシステムは、おそらく最も単純で基本的なNERアプローチです。 多くの単語、類義語、語彙コレクションを含む辞書を使用します。 システムは、テキストに存在する特定のエンティティが語彙でも利用可能かどうかをチェックします。 文字列照合アルゴリズムを使用することにより、エンティティのクロスチェックが実行されます。
このアプローチを使用することのXNUMXつの欠点は、NERモデルが効果的に機能するために、語彙データセットを絶えずアップグレードする必要があることです。
ルールベースのシステム
このアプローチでは、事前に設定された一連のルールに基づいて情報が抽出されます。 使用されるルールのXNUMXつの主要なセットがあります。
パターンベースのルール –その名の通り、パターンベースのルールは、文書内で使用されている形態論的なパターンまたは単語の並びに従います。
文脈に基づくルール –文脈に基づくルールは、文書内の単語の意味や文脈に依存します。
機械学習ベースのシステム
機械学習ベースのシステムでは、統計モデリングを用いてエンティティを検出します。このアプローチでは、テキスト文書の特徴量に基づいた表現が使用されます。このモデルは、スペルにわずかな違いがあってもエンティティの種類を認識できるため、最初の2つのアプローチのいくつかの欠点を克服できます。
深い学習
NER の深層学習手法は、RNN やトランスフォーマーなどのニューラル ネットワークの力を活用して、長期的なテキストの依存関係を理解します。これらの方法を使用する主な利点は、豊富なトレーニング データを使用する大規模な NER タスクに適していることです。
さらに、データ自体から複雑なパターンや特徴を学習できるため、手動トレーニングの必要がなくなります。しかし、落とし穴があります。これらの方法では、トレーニングと展開に大量の計算能力が必要です。
ハイブリッド手法
これらの方法では、ルールベース、統計、機械学習などのアプローチを組み合わせて、名前付きエンティティを抽出します。目標は、各方法の長所を組み合わせながら、短所を最小限に抑えることです。ハイブリッド手法を使用する最も優れた点は、さまざまなデータ ソースからエンティティを抽出できる複数の手法を統合することで得られる柔軟性です。
ただし、複数のアプローチを結合するとワークフローが混乱する可能性があるため、これらの方法は単一アプローチの方法よりもはるかに複雑になる可能性があります。
NERはどこで使われているのか?主なユースケースと業界
名前付きエンティティ認識 (NER) の多様性を明らかにする。
NER は金融から医療までさまざまな分野に適用されており、その適応性と幅広い有用性を実証しています。
- チャットボット: 主要なエンティティを識別することで、GPT などのチャットボットがユーザーのクエリを理解するのに役立ちます。
- カスタマサポート: フィードバックを製品別に分類し、応答時間を短縮します。
- ファイナンス: 傾向分析とリスク評価のために、財務レポートから重要なデータを抽出します。
- 健康管理: 電子健康記録 (EHR) から患者データを抽出します。
- HR: 応募者のプロフィールを要約し、フィードバックを伝達することで採用を効率化します。
- ニュースプロバイダー: コンテンツを関連情報に分類し、レポート作成を高速化します。
- レコメンデーション エンジン: Netflix のような企業は、ユーザーの行動に基づいておすすめをパーソナライズするために NER を採用しています。
- サーチエンジン: NER は Web コンテンツを分類することで、検索結果の精度を高めます。
- 感情分析: Eレビューからブランドの言及を抽出し、感情分析ツールに活用します。
- eコマース: パーソナライズされたショッピング体験を強化します。
- リーガル: 契約書や法的文書の分析。
NER を通じて抽出されたエンティティはナレッジ グラフに統合できるため、データの整理と検索を強化できます。
固有表現認識 (NER) を使用するのは誰ですか?
NER(固有表現抽出)は、強力な自然言語処理(NLP)技術の一つであり、様々な業界や分野に浸透しています。多くの組織では、情報抽出の自動化と効率性の向上を目的として、固有表現抽出システムを導入しています。以下にいくつか例を挙げます。
- サーチエンジン: NERは、GoogleやBingといった現代の検索エンジンの中核コンポーネントです。ウェブページや検索クエリからエンティティを識別・分類し、より関連性の高い検索結果を提供するために使用されます。例えば、NERを利用することで、検索エンジンは文脈に基づいて企業名「Apple」と果物名「apple」を区別することができます。NERプロセスの実装は、正確で文脈を考慮した検索結果を提供するために不可欠です。
- チャットボット: チャットボットやAIアシスタントは、NER(自然言語処理)を用いてユーザーのクエリから主要なエンティティを理解できます。これにより、チャットボットはより正確な回答を提供できます。例えば、「セントラルパーク近くのイタリアンレストランを探して」と質問した場合、チャットボットは料理の種類として「イタリアン」、場所として「レストラン」、そして所在地として「セントラルパーク」を理解します。NERプロセスにより、これらのシステムは関連情報を効率的に抽出できます。
- 調査ジャーナリズム: 有名なメディア組織である国際調査ジャーナリスト連合 (ICIJ) は、11.5 万件の財務および法的文書の大規模漏洩であるパナマ文書の分析に NER を使用しました。このケースでは、NER を使用して数百万の非構造化文書全体から人、組織、場所を自動的に特定し、オフショア脱税の隠れたネットワークを明らかにしました。
- バイオインフォマティクス: バイオインフォマティクスの分野では、NERは生物医学研究論文や臨床試験報告書から遺伝子、タンパク質、薬剤、疾患といった重要なエンティティを抽出するために用いられています。こうしたデータは、創薬プロセスの迅速化に役立ちます。大規模な生物医学コーパスを用いたモデルの事前学習は、この専門分野におけるNERシステムのパフォーマンスを大幅に向上させることができます。
- ソーシャルメディアモニタリング: ブランドはソーシャルメディア上で、自社の広告キャンペーンの全体的な指標や競合他社の動向を追跡するためにNERを活用しています。例えば、ある航空会社はNERを活用して自社ブランドに関するツイートを分析しています。NERは、特定の空港での「手荷物紛失」といった事象に関する否定的なコメントを検出し、問題を迅速に解決できるよう支援します。NERプロセスは、膨大なソーシャルメディアデータから実用的なインサイトを抽出するために不可欠です。
- コンテキスト広告: 広告プラットフォームはNERを利用してウェブページから主要なエンティティを抽出し、コンテンツと関連性の高い広告を表示することで、広告のターゲティングとクリックスルー率を向上させます。例えば、NERが旅行ブログで「ハワイ」「ホテル」「ビーチ」を検出すると、広告プラットフォームは一般的なホテルチェーンではなく、ハワイのリゾートのお得な情報を表示します。
- 採用と履歴書審査: NERは、応募者のスキルセット、経験、経歴に基づいて、必要なスキルと資格を正確に見つけるよう指示できます。例えば、人材紹介会社はNERを活用して候補者を自動マッチングできます。企業は、特定の要件に合わせてカスタマイズした独自のモデルを使用することも、事前学習済みモデルを活用して固有表現抽出システムの精度を高めることもできます。
業界をまたいだ固有表現抽出 (NER) の応用
NERは、自然言語処理や機械学習・深層学習ソリューションのための学習データセット作成など、様々な分野で活用されています。学習済みモデルを用いて新しいデータに対してNERを実行することで、大量のテキストからエンティティを自動抽出することが可能になります。具体的な用途としては、以下のようなものがあります。
カスタマーサービス
NER システムは、製品名、仕様、支店の所在地などの重要な情報に基づいて、関連する顧客の苦情、問い合わせ、フィードバックを簡単に特定できます。 苦情やフィードバックは、優先キーワードをフィルタリングすることによって適切に分類され、適切な部門に転送されます。
効率的な人材
NER は、応募者の履歴書を迅速に要約することで、人事チームが採用プロセスを改善し、スケジュールを短縮できるように支援します。 NER ツールは履歴書をスキャンして、名前、年齢、住所、資格、大学などの関連情報を抽出できます。
さらに、HR部門は、NERツールを使用して、従業員の苦情をフィルタリングし、関係する部門長に転送することで、内部ワークフローを合理化することもできます。
コンテンツ分類
コンテンツの分類は、ニュース配信者にとって非常に重要な作業です。コンテンツをさまざまなカテゴリに分類することで、発見しやすくなり、洞察を得やすくなり、トレンドを把握しやすくなり、主題を理解しやすくなります。固有表現認識( NER )ツールは、ニュース配信者にとって非常に役立ちます。多数の記事をスキャンし、優先度の高いキーワードを特定し、人物、組織、場所などに基づいて情報を抽出できます。
検索エンジンの最適化

正確なコンテンツの推奨
いくつかの最新のアプリケーションは、最適化されカスタマイズされた顧客エクスペリエンスを提供するために NER ツールに依存しています。 たとえば、Netflix は固有表現認識を使用して、ユーザーの検索履歴と視聴履歴に基づいてパーソナライズされた推奨事項を提供します。

固有表現認識(NER)は機械学習モデルの効率性と信頼性を向上させますが、その性能を最大限に発揮するには、質の高い、一貫性のあるラベル付けが施されたデータで学習させる必要があります。そこで、経験豊富なパートナーの存在が重要になります。ShaipのNERデータアノテーションサービスは、金融、保険、医療などの分野にわたる包括的ですぐに使用できるNERデータセットを提供し、効率的で高度な機械学習モデルをより迅速に開発できるよう支援します。
[こちらもご覧ください:NLPとは何か?その仕組み、メリット、課題、事例]
NERモデルはどのように評価されるのですか?
NERモデルは、精度、再現率、F1スコアという3つの指標で評価されます。これらの指標は、モデルの予測結果を、正しくラベル付けされたエンティティの「正解」セットと比較するものです。
- 精度モデルが予測したエンティティのうち、正しかったものはいくつですか?これは偽陽性を測定するものです。
- リコール実際に存在する実体のうち、モデルが検出できた実体はいくつですか?これは偽陰性を測定するものです。
- F1スコア精度と再現率の調和平均 ― 両者のバランスをとった単一の数値。
作業例:「Apple Inc. は 2026 年 3 月にサンフランシスコにオフィスを開設します」という文で、モデルが「Apple Inc.」と「サンフランシスコ」を正しくタグ付けし、「オフィス」を場所として誤ってタグ付けし、「2026 年 3 月」を見逃したとします。これにより、真陽性 2 件、偽陽性 1 件、偽陰性 1 件が得られます。精度 = 2/3 ≈ 0.67、再現率 = 2/3 ≈ 0.67、F1 スコア ≈ 0.67 となります。トレーニングでモデルが見たことのないデータであるホールドアウト検証セットでテストすることは、モデルが記憶するのではなく一般化していることを確認するために不可欠です。
NER ツールとライブラリの比較:
いくつかの強力なツールとライブラリが NER の実装を容易にします。以下に、いくつかの一般的なオプションの比較を示します。
| ツール/ライブラリ | 詳細説明 | 強み | 弱み |
|---|---|---|---|
| スパシー | Python の高速かつ効率的な NLP ライブラリ。 | 優れたパフォーマンス、使いやすさ、事前トレーニング済みのモデルが利用可能。 | 英語以外の言語のサポートは限定的です。 |
| NLTK | Python の包括的な NLP ライブラリ。 | 幅広い機能があり、教育目的に適しています。 | spaCy よりも遅くなる可能性があります。 |
| スタンフォードCoreNLP | Java ベースの NLP ツールキット。 | 高精度、複数の言語をサポートします。 | より多くの計算リソースが必要です。 |
| OpenNLP | NLP 用の機械学習ベースのツールキット。 | 複数の言語をサポートし、カスタマイズ可能です。 | セットアップが複雑になる場合があります。 |
NERにおけるモデルトレーニング
効果的な固有表現抽出(NER)システムを構築するには、モデルのトレーニングが不可欠です。このプロセスでは、ラベル付けされたトレーニングデータから学習することで、モデルに人、組織、場所などの固有表現を識別・分類する能力を身につけさせます。固有表現抽出の成功は、このトレーニングデータの品質と多様性、そして各固有表現の種類ごとに事前定義されたカテゴリの明確さに大きく依存します。
モデルのトレーニング中、機械学習アルゴリズムは、正しいエンティティラベルが付与されたテキストデータを分析します。リカレントニューラルネットワーク(RNN)や畳み込みニューラルネットワーク(CNN)などのディープラーニングモデルは、NERタスクにおいて特に人気が高まっています。これらのニューラルネットワークは、テキスト内の複雑なパターンや関係性を捉えることに優れており、NERモデルは言語の微妙な変化があっても、非常に高い精度でエンティティを認識できます。
しかし、固有表現抽出のためのディープラーニングモデルを学習させるには、大量のラベル付きデータが必要となり、その作成には時間とコストがかかる可能性があります。この問題に対処するために、データ拡張や転移学習といった手法がよく用いられます。データ拡張は、既存のデータから新しい例を生成することで学習データセットを拡張する一方、転移学習は、一般的な言語パターンを既に学習済みの事前学習済みモデルを活用するため、ドメイン固有のデータを用いた微調整のみで済みます。
最終的に、NER モデルの有効性は、堅牢なモデルトレーニング、高品質のラベル付きデータ、および特定のエンティティ認識タスクに適した機械学習またはディープラーニング モデルの慎重な選択に左右されます。
効果的なNERのためのベストプラクティス
固有表現抽出(NER)で高いパフォーマンスを実現するには、データ品質とモデル開発の両方を考慮した一連のベストプラクティスに従う必要があります。効果的な固有表現抽出を実現するための重要な戦略をいくつかご紹介します。
- 高品質のトレーニングデータを優先する成功するNERモデルの基盤は、多様性があり、適切にアノテーションが付与された、代表的なトレーニングデータです。モデルが新しいシナリオに一般化できるようにするには、ラベル付けされたデータは、幅広いエンティティタイプとコンテキストをカバーする必要があります。
- 徹底したテキスト前処理: トークン化や品詞タグ付けなどの手順により、モデルはテキストの構造をより適切に理解できるようになり、名前付きエンティティを正確に認識して分類する能力が向上します。
- 適切なアルゴリズムを選択するルールベースの方法は単純なタスクや高度に構造化されたタスクには効果的ですが、RNN や CNN などのディープラーニング モデルは、複雑で大規模な NER タスクに対して優れた結果をもたらすことがよくあります。
- 事前トレーニング済みモデルを活用する: 事前にトレーニングされたモデルを活用し、特定のデータセットで微調整することで、大量のラベル付きデータセットの必要性が大幅に減り、開発がスピードアップし、パフォーマンスが向上します。
- 継続的なモデル評価と微調整: 堅牢な評価メトリックを使用して NER モデルのパフォーマンスを定期的に評価し、新しいデータやエンティティ認識タスクが発生したときに更新します。
- 状況認識: エンティティが出現するコンテキストを常に考慮します。これにより、複数の意味を持つ可能性のあるエンティティ名の曖昧さが解消され、エンティティの認識精度が向上します。
これらのベスト プラクティスに従うことで、組織は複雑なテキスト データからエンティティを抽出することに優れた、より正確で適応性に優れた効率的な NER システムを構築できます。
事例研究:腫瘍学研究のための臨床NER
臨床テキストは、固有表現認識(NER)が真に難しく、かつ最も重要な部分です。ある医療プロジェクトにおいて、Shaipは主要な医療機関が非構造化された腫瘍学記録をHIPAAに準拠した研究用データセットに変換できるよう、臨床NERと匿名化のパイプラインを構築しました。
この作業は、人物や場所をタグ付けするだけにとどまりませんでした。腫瘍学の専門知識を持つ注釈チームが、約10,000万ページに及ぶ腫瘍学記録全体にわたって、以下のような豊富なエンティティスキーマにラベルを付けました。
- 疾患群: がんの問題、組織学、身体部位、挙動、グレード、がんの病期、およびTNM病期分類。
- 治療対象がん治療薬、薬剤投与量、投与頻度、がん手術、放射線治療の手法と投与量。
- ゲノミクス関連組織: 研究対象遺伝子、変異コード、方法、および検体。
- 否定状態:陰性、陰性の可能性あり、不確実、陽性の可能性ありの所見を区別することは、臨床記録において非常に重要です。
- 臨床NERの関係がんの問題→身体部位、組織学→グレードといった要素をリンクさせることで、データは単なるラベルではなく意味を捉えるようになります。
このデータセットは、Shaipが保有する5万件以上の電子医療記録のリポジトリから収集され、HIPAAのセーフハーバー方式を用いて匿名化されました。保護対象医療情報(PHI)はすべてラベル付きのプレースホルダーに置き換えられ、データの有用性を維持しながら患者のプライバシーは保護されました。その後、品質保証(QA)と顧客からのフィードバックを繰り返し実施し、注釈が要求される品質基準を満たすようにしました。
結果として、クライアントの腫瘍学NLPモデル開発の基盤となる、高品質で匿名化されラベル付けされた10,000万件のレコードが得られました。このプロジェクトは、実運用における臨床NERに求められる要件、すなわち、ドメインエキスパートによるアノテーター、関係性を考慮したスキーマ、否定処理、そして厳格なコンプライアンスといった要素を明確に示しています。これらは汎用モデルではすぐに実現できないものです。詳細については、腫瘍学NLP開発のケーススタディ全文をご覧ください。
NER の利点と課題?
メリット:
- 情報抽出: NER は重要なデータを識別し、情報検索を支援します。
- コンテンツ構成: コンテンツの分類に役立ち、データベースや検索エンジンに役立ちます。
- ユーザー・エクスペリエンスの向上: NER は検索結果を絞り込み、推奨事項をパーソナライズします。
- 洞察力に富んだ分析: 感情分析と傾向検出が容易になります。
- 自動化されたワークフロー: NER は自動化を促進し、時間とリソースを節約します。
制限 / 課題:
- あいまいさの解決: 「Amazon」のような類似のエンティティを川として、または会社として区別するのに苦労します。
- ドメイン固有の適応: 多様なドメインにわたってリソースを大量に消費します。
- 言語バリエーション: スラングや地域の違いにより効果は異なります。
- ラベル付きデータの不足: トレーニングには大規模なラベル付きデータセットが必要です。
- 非構造化データの処理:高度な技術が必要です。
- パフォーマンス測定:正確な評価は複雑です。
- リアルタイム処理: 速度と精度のバランスをとるのは困難です。
- コンテキスト依存性: 正確さは周囲のテキストのニュアンスを理解することに依存します。
- データのスパース性: 特にニッチな分野では、大量のラベル付きデータセットが必要です。
固有表現認識の未来はどうなるのか?
NERの未来は、単純なタグ付けを超え、よりリッチで効率的、かつ多言語対応のシステムへと移行しつつあります。特に注目すべき変化がいくつかあります。
- 少発撃ちと無発撃ち 機械学習によって、膨大なラベル付きデータセットへの依存度が減り、NERを新しい領域に拡張するのがより速くなっています。
- エンティティのリンク 検出されたエンティティを知識グラフレコードに接続することで、NERはラベル付けから推論ステップへと変化し、検索拡張生成(RAG)の基礎レイヤーとしても機能します。
- トランスフォーマーとLLMベースのNER 曖昧なエンティティやネストされたエンティティの精度を継続的に向上させる。
- 多言語および異言語間の固有表現認識 企業がグローバル化し、様々な文字体系や言語にわたる一貫したデータ抽出が必要となるにつれて、この分野は拡大している。
- カスタム、ドメイン固有のモデル 医学、法律、金融分野では、専門的な用語が一般的なコーパスにほとんど登場しないため、これらの分野は標準的なものになりつつある。
NERプロジェクトにShaipを選ぶ理由とは?
ほとんどの固有表現抽出(NER)プロジェクトは、モデルではなくデータの問題で停滞します。Shaipは、事前学習済みモデルでは提供できない重要な要素、つまり、正確でドメイン固有の、一貫性のあるラベル付けされた大規模なトレーニングデータを提供するため、NER作業に推奨されます。NERおよびエンティティ抽出プロジェクト向けに、Shaipは以下を提供します。
- ドメインエキスパートによるアノテーター ― 一般的なラベルでは不十分な、医療、法律、財務、臨床分野のNER(非侵襲的対応)に関する専門チームを含む。
- 関係性と否定のラベル付け単なる平坦なエンティティタグではなく、モデルが意味と文脈を学習できるようにするためのものです。
- HIPAA、GDPR、およびSOC 2-PHIやPIIなどの機密データについては匿名化を行い、ワークフローを整合させる。
- 多段階品質保証 プロセス専門家によって構築され、すべてのデータセットを貴社の品質基準に適合させるように設計されています。
- 柔軟なスケールグローバルな人材と大規模な独自データリポジトリを活用している。
カスタムNERデータセット、臨床情報の匿名化、エンドツーエンドの固有表現認識アノテーションなど、お客様のニーズに合わせて、当社のチームがスキーマに基づいて構築いたします。
信頼できる固有表現認識(NER)トレーニングデータを作成する準備はできていますか?Shaipにご連絡いただければ、プロジェクトの範囲をご相談の上、AI/MLモデル用のカスタムNERデータセットをご提供いたします。
NERに関するよくある質問:プロジェクト開始前にチームが尋ねる質問
これらは、チームが「NERとは何か」という段階から、実際にNERプロジェクトの範囲設定、予算編成、調達を行う段階へと移行する際に、最も頻繁に出てくる質問です。
カスタムNERモデルをトレーニングするには、どのくらいのラベル付きデータが必要ですか?
実用的な出発点として、エンティティタイプごとに数千の注釈付きサンプルを用意しましょう。実際のカスタムNERモデルは、数千のサンプルで学習されることがよくあります。ゼロから学習するにははるかに多くのデータが必要となるため、ほとんどのチームは代わりに事前学習済みモデルを微調整します。ラベルの質と一貫性は、データ量よりも重要です。ノイズの多いデータは、精度を急速に低下させます。
NER(固有表現認識)のトレーニングデータセットは社内で構築すべきでしょうか、それともアノテーション作業を外部委託すべきでしょうか?
ボリューム、スピード、専門知識、コンプライアンスなど、社内で対応できない要件がある場合はアウトソーシングを検討しましょう。スキーマがシンプルで安定しており、規模が小さい場合にのみ、社内で構築してください。多くのチームはアノテーションを過小評価しがちです。ガイドライン、ラベル付け、品質保証は、NERプロジェクトの大部分を占めます。Shaipのような専門パートナーがその負担を引き受けることで、エンジニアはラベル付けではなくモデリングに集中できます。
なぜ私のNERモデルはドメイン固有のエンティティを見逃してしまうのでしょうか?
汎用モデルはニュース記事やウェブテキストで学習されているため、医薬品名、法律条項、金融商品といった専門用語を認識することはほとんどありません。解決策は、これらの専門用語が現実的な文脈で含まれている、注釈付きのドメイン内データでファインチューニングを行うことです。ラベル付けガイドラインの不整合もよく見られる原因なので、規模を拡大する前に注釈ルールをしっかりと確立しておきましょう。
カスタムNERデータセットを構築するには、どれくらいの費用がかかりますか?
費用は、エンティティの複雑さ、注釈の量、必要な専門知識、およびコンプライアンス要件によって異なります。臨床または法律関連のラベル付けは、専門の注釈者とより厳格な品質保証が必要となるため、一般的なテキストよりも費用が高くなります。価格は通常、ページ単位、ドキュメント単位、または注釈付きユニット単位で見積もられます。Shaipは、お客様のスキーマと品質基準に合わせて各NERプロジェクトの範囲を決定し、カスタマイズされた見積もりを提供します。
高品質なNER(固有表現認識)データ、または臨床NERのトレーニングデータはどこで入手できますか?
NERトレーニングデータの取得方法は3つあります。既製のデータセットのライセンスを取得する、独自のデータセットを収集して注釈を付ける、または既存のコーパスを拡張する、のいずれかです。医療、法律、金融など、特定の分野や規制の厳しい業務には、マネージド注釈プロバイダーを利用するのが確実な方法です。Shaipは、お客様の仕様に合わせて構築されたカスタムNERデータセット、臨床NER、およびHIPAA準拠の匿名化を提供します。
NER、エンティティ抽出、エンティティリンキングの違いは何ですか?
NERは、エンティティをタイプ(人物、組織、場所)ごとに検出して分類します。エンティティ抽出は、NERとほぼ同義で使われることが多く、テキストから構造化されたフィールドを抽出するという意味でより広義に使われることもあります。エンティティリンキングはさらに一歩進んで、認識されたエンティティを知識ベース内の固有のレコードにリンクさせ、どの「Apple」やどの「Jordan」を指しているのかを特定します。
結論
固有表現認識 (NER) は、テキスト内の主要エンティティを識別して分類する強力な NLP 技術であり、これにより機械は人間の言語をより効果的に理解して処理できるようになります。検索エンジンやチャットボットの強化から、カスタマー サポートや財務分析の強化まで、NER はさまざまな業界で多様な用途に使用されています。あいまいさの解決や非構造化データの処理などの分野では課題が残っていますが、特にディープラーニングの継続的な進歩により、NER の機能はさらに洗練され、将来的にその影響が拡大することが期待されています。




