コンピュータビジョン向けビデオ注釈・ラベル付けサービス

バウンディングボックス、ポリゴン、セグメンテーション、3Dキューボイド全体にわたるフレーム単位の正確なアノテーションを、SOC 2、HIPAA、GDPRに対応したワークフローを備えた専門的な訓練を受けたアノテーターが提供します。

ビデオの注釈

動画注釈はなぜ必要なのか?

ビデオアノテーションとは、コンピュータビジョンモデルのトレーニングデータを作成するために、ビデオフレーム全体にわたってオブジェクト、動作、イベントにラベルを付けるプロセスです。これにより、自動運転車、外科手術用画像モデル、小売分析プラットフォーム、ロボットなどのAIシステムが、実世界の映像内の動体を検出、追跡、分類できるようになります。Shaipは、バウンディングボックス、ポリゴンセグメンテーション、3Dキューボイド、骨格キーポイントなど、9つの手法を用いてフレーム単位で正確なビデオアノテーションを提供します。

プロトタイプの公開前に、自動運転車の知識データベースを訓練することを想像してみてください。最高の性能を発揮するためには、自動運転車は信号、人、道路封鎖、バリケードなどを正確かつ精密に識別し、通過できなければなりません。しかし、これは機械学習とコンピュータビジョンモデルが、アルゴリズムの訓練に使用されるラベル付きデータセットを使って学習できる場合にのみ可能になります。

Tsunaguの専門領域

生産的なビデオラベリングが簡単に

ビデオ内の各オブジェクトをフレームごとにキャプチャし、注釈を付けて、高度なビデオラベリングサービスを備えたマシンで移動するオブジェクトを認識できるようにします。 私たちは、すべてのビデオラベリングのニーズに合わせて包括的にラベル付けされたデータセットを支援するビデオラベリングソリューションを提供するテクノロジーと経験を持っています。 私たちはあなたがあなたのコンピュータビジョンモデルを正確にそして望ましいレベルの正確さで構築するのを手伝います。 ユースケースを定義し、次のツールを自由に使用して、Shaipにパワービジョンモデルの手間のかかる作業を任せます。

境界ボックス

境界ボックス注釈

最も広く使われている動画ラベリング技術です。対象オブジェクトの周囲に2次元の長方形を各フレームにわたって描画することで、自動運転、監視、小売分析などの用途における物体検出および追跡モデルを実現します。

ポリゴンの注釈

ポリゴンアノテーション

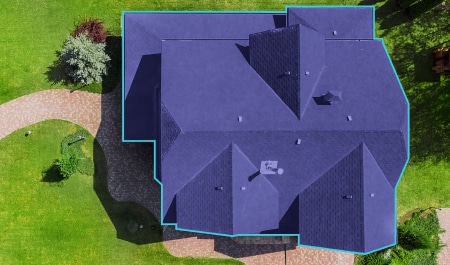
境界ボックスが対象物の領域を過大評価してしまうような不規則な形状の物体の場合、当社のアノテーターはフレームごとに正確な対象物の境界をトレースします。これは、医療画像や航空写真/ドローン映像における正確なシーン解析に不可欠です。

セマンティックセグメンテーション

セマンティックセグメンテーション

あらゆるフレームのあらゆる領域をピクセルレベルで分類します。道路と歩道、腫瘍と健康な組織、製品と背景などを区別する必要があるモデルなど、ピクセル単位の正確なコンテキストが重要なあらゆる場面で使用されます。

キーポイントの注釈

キーポイント注釈

顔、身体、物体などの注目ポイントをフレームごとにランドマークとしてラベル付けします。顔認識、ジェスチャー検出、生体認証セキュリティ、感情分析モデルを支えます。

3D 直方体の注釈

3D直方体アノテーション

空間内の物体(車両、歩行者、機器など)の3次元境界ボリューム。自動運転の知覚スタックや倉庫ロボットにおける標準的なアノテーションタイプ。

ラインとポリラインの注釈

線とポリラインの注釈

道路、車線、鉄道、パイプライン、境界線などの線状特徴量ラベル付け。車線検出、インフラ検査、自律航行モデルにとって重要なトレーニングデータ。

フレームの分類

フレームとビデオの分類

シーン、アクション、イベントの種類に基づいて、フレーム全体またはビデオセグメントを分類します。コンテンツモデレーション、スポーツ分析、メディアアーカイブのインデックス作成モデルなどに使用されます。

ビデオ文字起こし

ビデオ転写

音声からテキストへの文字起こしをフレームと同期させ、さらにテキストと視覚的な注釈をペアにして、マルチモーダルAIおよび生成AIのトレーニングに活用します。

骨格の注釈

骨格とポーズの注釈

姿勢、動作、活動分析のための身体キーポイントおよび骨格リグのラベリング。スポーツパフォーマンスモデル、理学療法アプリケーション、ヒューマノイドロボットのトレーニングデータセットを支えます。

ビデオ注釈のユースケース

Shaip は、さまざまなアプリケーションに効果的なビデオ アノテーション ソリューションを提供します。

ドライバーの監視

客室乗務員のモニタリング

何百時間ものドライバーと車内のビデオ映像に注釈を付けました。 各ビデオには、顔の特徴の動きを特徴とする完全な注釈付きクリップと、ドライバーの行動を正確に監視し、逸脱が観察されたときに警告を発する車内シナリオが含まれています。

小売AI

小売 AI

動画の注釈は、小売店でも消費者の行動を理解するのに役立ちます。 注釈付きのビデオを使用すると、買い物客の動きを追跡し、購入の意思決定を理解し、盗難を特定するアプリケーションを簡単に設計できます。

交通ビデオ データセット

交通監視

ビデオ アノテーションは、高品質の監視アプリケーションの開発において重要な役割を果たします。 必要なオブジェクトに注釈を付けることで、何百時間もの監視および CCTV ビデオに優れた解像度と詳細で注釈を付けることに成功しました。

キーポイントの注釈

顔認識

Shaip は、顔認識アプリケーションを開発するためのハイエンド トレーニング データセットの開発に使用される人の顔に重要なポイントを適用することができます。

レーン検出

車線検出

ビデオ アノテーションの高度な機能により、何時間ものビデオをふるいにかけ、ポリライン アノテーションを使用して、車線、道路標示、車両通行、迂回路、車線、および方向を検出するように車両をトレーニングできます。

コンピュータービジョンとロボティクス

コンピューター ビジョンとロボティクス

人間の介入を必要とせずに環境の使用、適応、および応答について知覚ロボットをトレーニングすることで、死亡事故や事故を減らし、生産性を高めることができます。

複数ラベルの注釈

マルチラベル注釈

特定のラベル付きカテゴリについては、意思決定を徐々​​に減らし、分析をさらに正確にするために、サブカテゴリに固執する必要があります。 マルチラベルビデオアノテーションの一部としてのインスタンスアノテーションは、車両をバスや車などにさらに分類することで、同じことを支援します。

映像データ解析

ビデオデータ分析

本格的なトレーニング戦略を計画する前にビデオラベリングのニーズを分析したい場合は、ユースケースをより適切に計画し、非常に具体的な目標を計画し、最終的には適切な注釈手法を展開します。

カスタム注釈

カスタムアノテーション

ビデオデータ分析が終了すると、ユースケースが非常にわかりにくく、さらに詳細が必要な場合でも、適切なビデオアノテーションツールでサポートされるカスタムアノテーション戦略の計画を支援することもできます。

ビデオラベリング–AIのためのヒューマンタッチ

簡単に言うと、Shaipを使用すると、最先端のビデオ注釈ソリューションのいくつかにアクセスして、知覚的で高度にインテリジェントなモデルを考案できます。 ビデオアノテーション会社として、Shaipは、目標固有のセットアップに最も効果的なモデルトレーニングの火力を提供し、データマイニングツール、社内のデータラベリングチーム、およびそれに合わせてさまざまなビデオアノテーションツールを導入する機能をさらに強化します。関連するすべてのユースケース。

ビデオラベリング要件をShaipにアウトソーシングする場合は、次のリソースを入手できます。

ビデオアノテーションサービス
  • より長いビデオを処理し、情報を抽出する機能
  • 市場投入までの時間を短縮するための自動アノテーションパースペクティブ
  • フレームごとのラベリングへのアクセス
  • 業界固有のカバレッジ
  • より高い精度
  • 非常に大量のデータを処理する機能

チームが動画注釈にShaipを選ぶ理由

匿名の群衆ではなく、専用のポッドをご用意いたします。

お客様のプロジェクトには、訓練を受けた固定の注釈担当者チームに加え、専任のプロジェクトマネージャー、ソリューションエンジニア、品質保証責任者が配置され、交代制のクラウドワーカーは使用しません。そのため、バッチ処理全体を通して品質が一定に保たれます。

ネットワーク全体で訓練されたアノテーター

データ作成、ラベリング、品質保証の分野にわたる30,000万人以上の専門家からなるグローバルなアノテーターチームにより、パートナーを変更することなく、100時間のパイロットプロジェクトから100,000万時間の納品までプロジェクトを拡張できます。

各バッチごとに多段階の品質保証を実施

すべての納品物は、注釈者レベルのチェック、ピアレビュー、プロジェクトマネージャーによる品質保証、統計的サンプリングを経ており、シックスシグマの訓練を受けた品質リーダーによって支えられているため、生産バッチの精度は98%以上を維持しています。

初日からコンプライアンス対応可能

SOC 2 Type II 管理、医療データに関する HIPAA 準拠のワークフロー、GDPR および DPDP に準拠したデータ処理、すべてのアノテーターとの NDA 締結、および ISO 27001 情報セキュリティ慣行。

Industries We Serve

業界をリードするソリューション プロバイダーの XNUMX つとして、さまざまな業界が一連のビデオ アノテーション サービスに基づいて自動化ツールとモデルを設計および開発するのを支援しています。 テクノロジーの能力と人間の専門家の能力を組み合わせて、大量のデータを分析し、生産を強化し、エラーを減らし、効率を高めます。

自動車

自律車両

ADASおよびフルスタックAV認識チーム向けに、歩行者、車両、車線表示、標識、道路形状をフレーム単位で正確にラベル付け。数百時間に及ぶ車内ドライバーモニタリングデータと実走行映像を提供。

医療

医療・医用画像処理

臨床AI向けに、手術ビデオ、超音波シーケンス、内視鏡映像、行動追跡ビデオの注釈付けを行う。―HIPAA準拠、NDA締結済みのワークフローの下で実施。

製造業

ロボティクスと物理AI

ヒューマノイドロボット、倉庫自動化、および身体化AIのトレーニングデータのための、自己中心的および他者中心的なビデオ注釈。姿勢データに同期したマルチビュー、マルチフレームのラベリング。

監視

監視と公共の安全

監視カメラ映像、ドローン映像、ボディカメラ映像の注釈付けによる脅威検知、群衆分析、および法医学ビデオモデルの構築。高解像度、高スループットのパイプライン。

小売&eコマース

小売&eコマース

小売分析および自動レジモデル向けの、買い物客の流れの追跡、棚の監視、行列の長さの検出、および損失防止ラベル表示。

車両損傷評価データの注釈

保険および請求処理

保険AIワークフローにおける損害評価、事故再現、および請求証拠のラベリング。
提供されるサービス

エキスパートの画像データ収集は、包括的なAIセットアップのためのすべてのハンズオンデッキではありません。 Shaipでは、次のサービスを検討して、モデルを通常よりもはるかに普及させることもできます。

テキスト注釈

テキスト注釈サービス

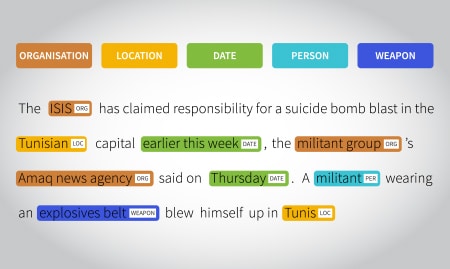
私たちは、エンティティアノテーション、テキスト分類、感情アノテーション、およびその他の関連ツールを使用して、網羅的なデータセットに注釈を付けることにより、テキストデータトレーニングの準備を整えることを専門としています。
画像注釈

画像注釈サービス

私たちは、目の肥えたコンピュータービジョンモデルをトレーニングするために、セグメント化された画像データセットにラベルを付けることに誇りを持っています。 関連する手法には、境界認識と画像分類が含まれます。

音声注釈

音声注釈サービス

音声認識、話者のダイアリゼーション、感情認識などの関連ツールを使用して、オーディオソース、音声、および音声固有のデータセットにラベルを付けることは、私たちが専門としていることです。

注目のクライアント

チームが世界をリードするAI製品を構築できるようにします。

専門家によるサポートはクリック一つでご利用いただけます。ビジョンAIの機能を次のレベルへと引き上げる計画をお持ちですか?ぜひお問い合わせください。

動画アノテーションとは、コンピュータビジョンモデルが認識できるように、動画フレーム全体にわたって物体、動作、イベントにラベルを付けるプロセスです。自動運転車、外科手術用画像モデル、小売分析、ロボット工学といった実用的なAIシステムは、現実世界の環境で動く物体を正確に検出、追跡、分類するために、何百万ものラベル付きフレームに依存しているため、このプロセスは非常に重要です。
画像アノテーションは静止画像を1枚ずつラベル付けします。一方、動画アノテーションは1本の動画内の数千フレームにわたるオブジェクトにラベル付けします。つまり、オブジェクトトラッキング、オクルージョン処理、モーションの連続性、時間的な一貫性が主要な課題となります。1秒間に30フレームの60秒の動画には1,800個のフレームが含まれていますが、動画アノテーションでは、それらすべてのフレームで同じオブジェクトが一貫して識別されるようにします。

すべてのバッチは、アノテーターによる自己チェック、ピアレビュー、プロジェクトマネージャーによる統計的サンプリング、およびシックスシグマ品質主導監査という4段階の品質保証プロセスを通過します。受入基準値とエッジケースルールは、本番作業開始前のキャリブレーション中に確定されます。本番納品は通常、クライアントのゴールドスタンダードセットに対して98%以上の精度を達成し、すべてのプロジェクトに反復ループが組み込まれています。

動画アノテーションの料金は、アノテーションの種類(バウンディングボックス、ポリゴン、セグメンテーション)、フレーム密度、フレームあたりのオブジェクト数、精度要件、総ボリュームによって異なります。時間単位とアセット単位の料金体系をご用意しています。Shaipの料金は、パイロット段階を過ぎると大幅に縮小されます。範囲を限定した見積もりは、通常、サンプルデータセットを受け取ってから48時間以内に返送されます。

当社では、バウンディングボックス、ポリゴン、セマンティックセグメンテーション、キーポイント、3Dキューボイド、線分およびポリライン、フレーム分類、骨格/姿勢、ビデオ文字起こしの9つの手法を提供しています。プロジェクトチームは通常、モデルのアーキテクチャとユースケースに応じて、これらのうち2つまたは3つを組み合わせて使用​​します。たとえば、自動運転プロジェクトでは、2Dバウンディングボックスと3Dキューボイド、車線ポリラインを組み合わせるのが一般的です。

社内でのアノテーション作業は、上級機械学習エンジニアやデータサイエンティストをモデル開発から遠ざけてしまいます。30fpsの60秒動画では1,800フレームのラベル付けが必要となり、一般的なコンピュータビジョンのトレーニングセットには数百時間分の映像が含まれます。専門パートナーにアウトソーシングすることで、中核となる機械学習チームのリソースを割くことなく、熟練したアノテーター、成熟した品質保証プロセス、拡張可能なキャパシティ、そしてコンプライアンス体制を活用できます。

3つの違いがあります。まず、匿名のクラウドソーシングではなく、専任のアノテーターチームが、パイロット段階から大規模展開まで、お客様のデータを一貫して処理します。次に、シックスシグマの訓練を受けた品質管理責任者が率いる4段階の品質保証プロセスを採用しています。そして、初日からコンプライアンスに対応可能です。SOC 2 Type II、ISO 27001、HIPAA準拠のワークフロー、GDPR準拠のデータ処理に対応しています。無料のパイロット版はご要望に応じてご利用いただけます。

課題には、大規模なデータセットの管理、注釈の精度の確保、複雑なシーンの処理、データラベル付けにおける偏りの排除などがあります。

ビデオ注釈は、顔の特徴、表情、重要なポイントにラベルを付け、セキュリティや生体認証などのアプリケーションで AI が顔を正確に識別してリアルタイムで分析できるようにします。

Shaip のような企業は、スケーラブルなプラットフォーム、経験豊富なチーム、自動化ツールを使用して、大量のビデオ データを効率的かつ正確に処理します。

主な使用例には、運転者監視、交通監視、小売行動分析、医療用画像、顔認識、自動運転、ロボット工学などがあります。

Shaipは、特定の業界に特化した高品質でスケーラブルな動画アノテーションサービスを提供しています。その専門知識により、正確でバイアスのないデータが確保され、AIモデルのトレーニングと開発が加速します。
