
機械学習および生成AI向けAIトレーニングデータサービス
Shaipは、AIおよび機械学習チームが正確で偏りのない、実運用可能なモデルを構築できるよう支援する、大手AIトレーニングデータプロバイダーです。データ収集とアノテーションから、LLMの微調整とモデル評価まで、65以上の言語と60以上の国に対応しています。
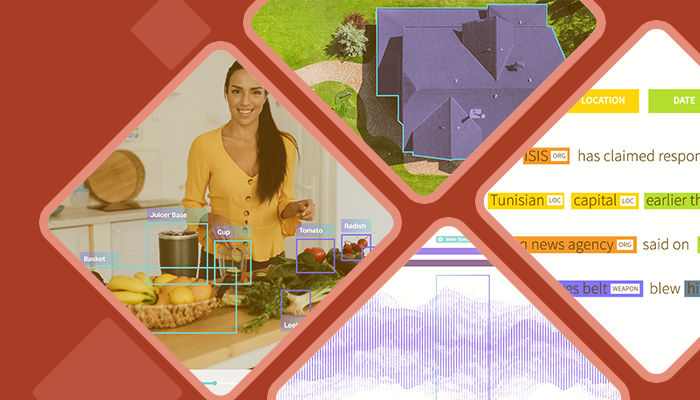
すべてのAIモデルの基盤
AIトレーニングデータとは何ですか?
AIトレーニングデータとは、機械学習モデルにパターン認識と予測方法を学習させるために使用される、ラベル付けされた構造化情報のことです。このデータの質、多様性、精度は、モデルが現実世界でどれだけうまく機能するかを直接左右します。
高品質なAIトレーニングデータは、実際の使用状況を反映し、正確にラベル付けされ、バイアスを軽減するためにバランスが取れており、データプライバシー規制に準拠しています。質の低いデータは、不正確な予測、モデルの誤作動、そして高額な再トレーニングサイクルの主な原因となります。そのため、先進的なAIチームは、場当たり的な社内ラベリングに頼るのではなく、ShaipのようなAIトレーニングデータ専門企業と提携するのです。
エンドツーエンドの AI データ サービス
当社のAIトレーニングデータサービス
生データの入手からモデルの微調整、評価まで、モデルライフサイクル全体に必要なすべてが揃っています。
データ収集サービス
カスタムオーディオ、音声、画像、動画、テキストデータセット ― 60カ国以上、65以上の言語で収集された、実世界の完全な同意を得たデータ。これにより、モデルは多様で代表的な例から学習できます。
詳しくはこちらをご覧ください→データの注釈とラベリング
訓練を受けたアノテーターとドメインエキスパートによるピクセル単位の正確なラベリング(バウンディングボックス、セグメンテーション、固有表現認識、感情・意図タグ付け、文字起こし)は、多段階の品質保証によって検証されます。
詳しくはこちらをご覧ください→生成AIとLLMデータ
SFT、RLHF、プロンプトとレスポンスのペア、人間の好みランキング、およびRAGデータセットは、精度を向上させ、幻覚を減らし、モデルの動作を整合させるために、各分野の専門家によって提供されます。
詳しくはこちらをご覧ください→既製のデータセット
当社のデータカタログから、すぐに使用できる事前ラベル付け済みのデータセットをご利用いただけます。30万件以上の匿名化された医療記録、70,000時間以上の音声データ、および物理AIシナリオが含まれています。
データカタログを探索する →物理AIおよびロボティクスデータ
LiDARと点群のアノテーション、センサーフュージョン、3Dバウンディングボックス、ロボットの軌跡、そして自律型機械、ロボット、および具現化されたAIを訓練するための現実世界のタスクシナリオ。
物理AIとロボット工学を参照 →あらゆる形態に対応、パートナーは一人
データタイプ別のAIトレーニングデータ
あらゆるモダリティにおいて、当社は作業の両面を担います。つまり、既製品では入手できない生データの調達と、お客様のモデルに必要な規格へのラベル付けの両方を行います。データ収集からアノテーション、納品まで、パートナーは1社のみ、品質保証プロセスも1つです。
テキストデータの収集と注釈
収集するもの: 専門分野に特化したテキストと文書 ― 臨床記録、契約書、チャットおよびサポートの記録、そして65以上の言語で厳選された専門家によって作成されたプロンプト応答セット。
私たちは注釈を付けます: 非構造化テキストを自然言語処理(NLP)および言語管理(LLM)のトレーニングデータに変換する、固有表現認識(NER)、感情分析、意図分類、エンティティリンキング、および文書タグ付け。
音声・オーディオデータの収集と注釈
収集するもの: 65以上の言語、アクセント、方言、そして実際の音響環境において、ネイティブスピーカーが録音した台本通りの音声、即興の音声、コールセンターでの音声。
私たちは注釈を付けます: 音声認識、音声アシスタント、対話型AIのための文字起こし、話者ダイアライゼーションと識別、タイムスタンプ、感情と意図のラベリング。
画像収集および注釈サービス
収集するもの: お客様の仕様に合わせて撮影されたカスタム画像データセット ― 顔や生体認証データ、文書や領収書、小売店の棚、医療画像、そしてモデルが遭遇する照明や地理的条件における特殊なケースなど。
私たちは注釈を付けます: 2D/3Dバウンディングボックス、ポリゴン、ピクセル単位の正確なセマンティックセグメンテーション、ランドマーク、キーポイント。
動画収集および注釈サービス
収集するもの: 自己中心的視点、マルチカメラ、CCTV、ドライブレコーダー、店内映像など、台本のあるシナリオと実際の現場シナリオの両方で、世界中の協力者ネットワークによって撮影された映像。
私たちは注釈を付けます: ロボット工学、自動運転、スポーツ、小売業のビデオAI向けに、フレームごとの物体追跡、動作および姿勢推定、イベント分類を行う。
物理AI、ロボット工学、センサーデータ
収集するもの: 1,400以上のタスクシナリオと9つの環境にわたる、LiDAR、深度、IMU、VRモーションキャプチャ、遠隔操作、ロボットの軌跡など、実際の環境からのマルチセンサーキャプチャ。
私たちは注釈を付けます: 身体化されたAIのための3Dバウンディングボックス、点群セグメンテーション、センサーフュージョンアライメント、およびビジョン言語ラベリング。
合成データの生成と検証
私たちは以下を生成します: 現実世界での収集が困難、機密性が高い、または安全でない場合に、代表的な合成テキスト、画像、およびセンサーデータ(稀な事象、ロングテールエッジケース、プライバシーが制限された領域など)。
検証対象: 人間のレビュー、バイアスチェック、そして実写と合成映像を組み合わせたセットを用いることで、制作過程における品質を維持しています。
現代AIのための人間の専門知識
生成AIとLLMトレーニングデータ
大規模な言語モデルの構築や微調整には、生のテキストだけでは不十分です。Shaipは、生成モデルの精度、安全性、整合性を確保するために必要な人間の専門知識を提供します。
教師ありファインチューニング(SFT)
分野の専門家によって作成された、質の高い質問と回答のペア。
RLHFと優先順位
モデルの動作を整合させるための、人間のフィードバックと反応の比較。
RAGと検索拡張データ
ドメイン知識ベース、ドキュメントのチャンキング、クエリとパッセージのペアなど、モデルの応答を独自のコンテンツに基づいて構築します。
モデル評価
幻覚監査、事実確認、および品質ベンチマーク。
ドメインエキスパートデータ
医療、法律、金融など、厳選された専門家が作成した質問、回答、評価。
多言語対応
65以上の言語と専門分野に精通したエキスパートアノテーター。
実世界のためのデータ
物理AIおよびロボット工学トレーニングデータ
ロボット、自動運転車、そして身体化されたAIは、物理世界から学習します。そのためには、高精度な3Dデータ、センサーデータ、およびモーションデータが不可欠です。Shaipは、知覚、ナビゲーション、および操作のトレーニングのために、1,400以上のタスクシナリオと9つの環境にわたるマルチモーダルな実世界データセットを提供します。
LiDARおよび点群の注釈
3Dバウンディングボックス、セマンティックセグメンテーション、および点群上の物体追跡。
センサーフュージョン
カメラ、LiDAR、レーダー、IMUのデータを整合させることで、堅牢なマルチセンサー認識を実現します。
ロボットの軌道と遠隔操作
模倣学習および強化学習のための、実演、動作、および操作に関するデータ。
人間の活動と姿勢の推定
安全な人間とロボットの協働のためのキーポイント、ジェスチャー、およびインタラクションデータ。
物体検出と追跡
カメラやセンサーのストリーム全体にわたる複数物体の検出、分類、追跡を行い、リアルタイムの認識を実現します。
現実世界のタスクシナリオ
倉庫、家庭、産業、屋外のロボット向けに、9つの環境にわたる1,400以上のシナリオを用意。
AIトレーニングデータプロバイダーとしてShaipを選ぶ理由
データ収集機能
カスタム ガイドラインに基づいて、世界中からカスタム構築されたデータセット (テキスト、音声、画像、ビデオ) を作成、キュレート、収集します。
柔軟なグローバル人材
10,000万人を超える社内グローバル人材と、500万人を超えるクラウドソーシングによる資格保有者を活用します。リアルタイムでの人材キャパシティと効率性を実現します。
品質
当社独自のプラットフォームと熟練した労働力は、複数の品質管理方法を使用して、品質基準を満たすか、それを上回ります。
多様で、正確で、速い
当社のプロセスは、タスクの配布を容易にし、アプリや Web から直接データを取得することで、収集プロセスを合理化します。
データセキュリティ
プライバシーを優先することにより、完全なデータの機密性を維持します。 データ形式がポリシーで管理され、保持されていることを確認します。
ライフサイクル全体
データ収集、注釈付け、生成AIの微調整、評価までをワンストップでサポートするパートナー
仕組み
トレーニングデータの提供方法
セキュリティ&コンプライアンス


よくある質問(FAQ)
1. AIトレーニングデータとは何ですか?
AIトレーニングデータとは、機械学習モデルにパターン認識と予測を学習させるために使用される、ラベル付きまたは構造化されたデータのことです。テキスト、音声、画像、動画、あるいはマルチモーダルデータなど、様々な形式があり、その品質がモデルの精度に直接影響します。
2. AIのトレーニングデータは何に使われるのですか?
これは、コンピュータビジョンシステム、音声認識、対話型AI、大規模言語モデルなど、AIおよび機械学習モデルのトレーニング、微調整、評価に使用されます。
3. Shaipはどのような種類のAIトレーニングデータを提供していますか?
Shaipは、テキスト、音声、画像、動画、マルチモーダルデータ、物理AI/センサーデータ、合成データなどを、収集、注釈付けとラベル付け、LLMの微調整、検証サービスを通じて提供します。
4. Shaipはどのようにしてトレーニングデータの品質を保証するのですか?
すべてのプロジェクトにおいて、ドメインエキスパートによるアノテーターと、合意レビュー、サンプリング、バイアスチェックなどを含む、人間が関与する多段階の品質保証プロセスが用いられ、定量化された品質レポートが作成されます。
5. Shaipはどの言語と国に対応していますか?
Shaipは65以上の言語に対応し、60カ国以上から同意を得たデータを収集しており、1,000人以上の厳選されたデータ専門家からなるネットワークを有しています。
6. 私のデータは安全に保護されていますか?また、Shaipはどのような認証を取得していますか?
はい。ShaipはISO 27001およびISO 9001:2015の認証を取得しており、SOC 2 Type IIの監査済み、HIPAA準拠、GDPR/CCPA対応済みで、個人情報保護、暗号化、ロールベースのアクセス制御機能を備えています。
7. ShaipはLLMや生成AIのためのトレーニングデータを提供できますか?
はい。Shaipは、大規模言語モデルおよび生成AI向けに、教師ありファインチューニング(SFT)、RLHF、人間の嗜好ランキング、RAGデータセット、プロンプトとレスポンスのペア、およびモデル評価を提供します。
8. Shaipは、物理的なAIおよびロボット工学のトレーニングデータを提供していますか?
はい。Shaipは、LiDARや点群アノテーション、センサーフュージョン、3Dバウンディングボックス、ロボットの軌跡、SLAMおよびナビゲーションデータ、そして自律システムや具現化されたAI向けの1,400以上のシナリオと9つの環境にわたる実世界のタスクシナリオなど、物理的なAIおよびロボット工学のトレーニングデータを提供します。
9. AIトレーニングデータの価格設定はどのようになっていますか?
料金は、データタイプ、データ量、アノテーションの複雑さ、使用言語、納期によって異なります。Shaipは、お客様のユースケースを詳しくお伺いした上で、個別のお見積もりをご提示いたします。まずは無料お見積もりをご依頼ください。
10. Shaipは既製のデータセットを提供していますか?
はい。Shaipのデータカタログには、医療記録、多言語音声、物理AIシナリオなど、すぐに使用できるラベル付きデータセットがライセンス供与で提供されています。
11. Shaipを使い始めるにはどうすればよいですか?
パイロットプロジェクトの範囲を定めるため、お客様のユースケースをShaipまでお聞かせください。ガイドラインと品質目標について合意した後、規模拡大の前にサンプルまたはパイロットバッチを提供いたします。
