
-
会社
カスタムウェイクワード学習データを使用して、常時音声認識を行う音声アプリを構築しましょう。検出精度が向上し、誤起動が減少します。
音声アシスタントは、顧客がデバイスを操作する方法を劇的に変えました。 これにより、ユーザーは製品やサービスをすばやく効率的に探索しやすくなりました。 しかし、音声アプリケーションは聞いていますか? これらのアプリケーションを活性化させるには、WAKE WORDS の助けを借りて、アプリケーションを起動し、パッシブ リスニングからアクティブ リスニングに移行する必要があります。 「Alexa」と「Hey Siri」は、世界で最も人気のあるウェイク ワードの XNUMX つです。
2024年までに、デジタル音声アシスタントの数は8.4億台に達すると予測されており、これは世界の人口を上回る数である。
音声アシスタントアプリの市場規模は、2021年の2.8億ドルから2026年には11.2億ドルに拡大すると予測されており、年平均成長率は32.4%となる。
ウェイクワードとは、「Hey Siri」、「Okay Google」、「Alexa」などの特定の単語またはフレーズで、発話時に音声起動デバイスが応答するように設計されています。しかし、デバイスにローカルに統合された常時リスニング型のウェイクワードを使用すると、応答時間が大幅に短縮され、インターネット接続がなくてもウェイクワードの識別と処理の精度が向上します。Shaipは、100以上の言語、多様なアクセント、年齢層、および実際の騒音環境にわたるウェイクワードのトレーニングデータを収集し、検出精度を最大化し、誤起動を最小限に抑えます。これらは次のようにも呼ばれます。
Shaip の提供する常時リッスン ウェイク ワード トレーニングにより、音声アシスタント モデルは常にウェイク ワードをリッスンするように調整されますが、データを実際に記録したりクラウドに送信したりすることはありません。 Shaip と提携することで、専門家と連携できる利点が得られます。 音声アシスタント トレーニングの開発における AI および ML テクノロジを使用した豊富な経験により、プライバシー リスクの排除、ユーザー エクスペリエンスの向上、開発コストの削減、スケーラビリティの向上を支援します。
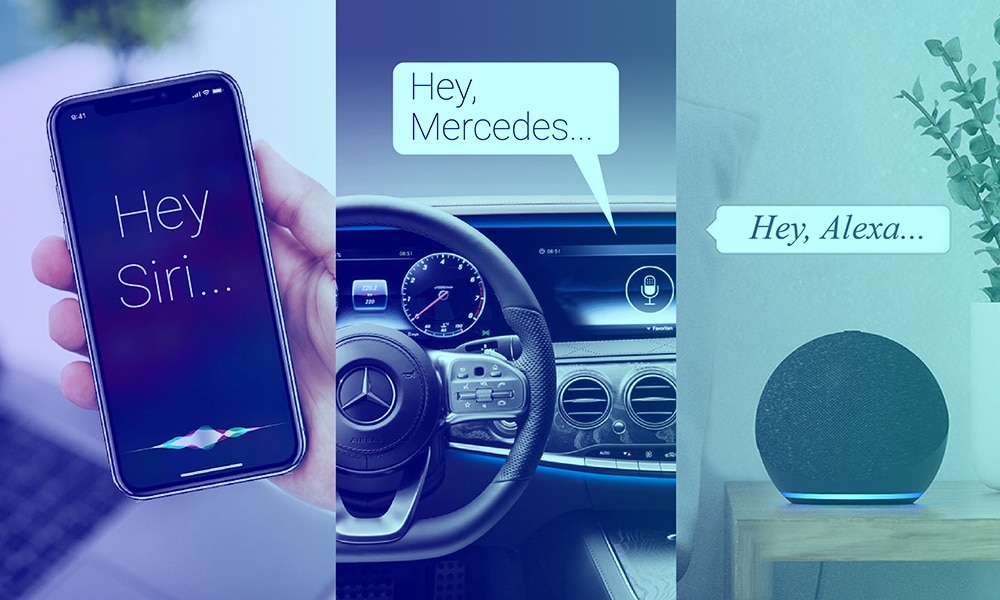
Shaipは、完全にブランド化されたウェイクワードのトレーニングデータを構築することで、顧客が汎用的なアシスタントではなく、ブランド名を言うようにします。すべてのデータセットは、お客様の正確な起動フレーズに合わせて調整されているため、インタラクションのたびにブランド想起が強化され、音声体験がお客様独自のシステム内で完結します。
Shaipは、音声を録音したりクラウドに送信したりすることなく、デバイス上で動作する常時待機型のウェイクワードモデルをサポートしています。デバイス上でウェイクワードのトレーニングデータを使用することで、遅延が削減され、プライバシーリスクが低減され、インターネット接続がない場合でも検出が確実に機能します。
Shaipは、スコットランド英語、カナダ英語、オーストラリア英語、インド英語など、100以上の言語と地域アクセントにわたるウェイクワードの発話を収集するため、非ネイティブスピーカーの場合でも検出精度が低下することなく、世界中のユーザーベースで高い精度を維持します。
Shaipは、無音状態、騒がしい環境、車内、屋外、遠距離など、あらゆる状況下でウェイクワードデータを収集します。実際の音響環境の変化に基づいて学習することで、ユーザーが遠くから話したり、騒音の中で話したりする際の誤認識を低減します。
Shaipはウェイクワードに加え、発話データやフレーズ検出データを提供することで、デバイスがより長い自然言語コマンドを低遅延で処理できるようにします。組み込みのキーワード検出データは、ブラウザ上およびチップ上での処理をサポートし、高い精度とプライバシーを実現します。
通常、音素が異なると、より明確なシグネチャが作成され、結果の精度が向上します。 したがって、さまざまな音を生成するデータ内のフレーズを選択してください。
「こんにちは」、「こんにちは」、「やあ」、「OK」などの接頭辞を付けて、ウェイク ワードをより効果的にします。 ウェイク ワードを明確に保ち、通常の発話でトリガー ワードを使用するときに偶発的な一致が発生しないようにします。
ウェイク ワードは、機械が簡単に識別でき、人間が言いやすい、少なくとも XNUMX つの音素の組み合わせにします。 たとえば、「アレクサ」には XNUMX つのフェノームがあり、「OK Google」には XNUMX つのフェノームがあります。
XNUMX つの単語をウェイク ワードとして使用するという間違いを犯さないでください。 ウェイク ワードは、区別するのに十分な長さでなければなりません。
作成するトリガー ワードは、簡単に覚えられるように、シンプルでユニークなものにする必要があります。
より長い複数単語のウェイク フレーズは発音が難しく、プロセスが不必要に難しくなります。
ウェイク ワード モデルは、通常、ノーを認識するようにトレーニングされます。 さまざまな呼び出しに応答できるように、さまざまな発話の。 ただし、明確なウェイク ワードが多すぎると、ユーザーがどの発話を話したのかを知らずに、音声パイプラインをアクティブにすることができます。
ノイズ、距離、アクセントや言語のバリエーションなどの要因により、AI モデルにとって起動ワードの正確な検出が困難かつ複雑になります。

音声技術における当社の経験により、常に耳を傾けるように調整されたウェイク ワードとブランド化されたウェイク フレーズを迅速に開発することができます。 音声認識と自然言語処理の理解を組み合わせることで、ML アルゴリズムは音声の書き起こしと音声コマンドの効果的な実行を支援します。

ブランドワードのカスタマイズを確実にするために、ウェイクワードのプロトタイピングを迅速に開発することに重点を置いています。 プロトタイプは概念実証として機能し、正確なトレーニング、市場投入までの時間の短縮、テストの加速、およびリスクの排除に役立ちます。

優れた音声アシスタントを使用して、中断のない成長と妨げのない顧客エンゲージメントを体験してください。 多言語の音声認識機能を提供しているため、アプリケーションはノイズの多い環境でも単語やフレーズを正確に認識できます。
これは、身元、出身国、年齢、性別、言語、アクセントなどの重要なユーザーデータを収集する方法です。データの多様性は、ユーザー指向のアルゴリズムを改善してより正確な結果を達成するために使用されます。
データは通常、組み込みのバイアスを生成する傾向があります。 したがって、さまざまなソースからデータを収集すると、結果の偏りが大幅に減少します。
Shaip がウェイク ワードやその他の会話コマンドを構築する際に対処するデータの多様性のいくつかのパラメーターを次に示します。

| 人種と民族 | ヒンズー教徒、イスラム教徒、キリスト教徒、アフリカーンス人、ヨーロッパ人 |
| 教育レベル | 学部、大学院、博士、修士 |
| 国 | 中国、日本、インド、韓国、ドバイ、ナイジェリア、アメリカ、カナダ |
| 性別 | 男性、女性 |
| 年数 | 10歳未満、10~15歳、15~25歳、25~45歳、45歳以上 |
| 言語 | 英語、日本語、トルコ語、中国語、タイ語、ヒンディー語 |
| 環境 | 静音、騒音、バックグラウンドミュージック、バックグラウンドサウンド/スピーチ、屋内、屋外、劇場、スタジアム、カフェテリア、車内、オフィス、ショッピングモール、家庭の騒音、階段、街路/道路、海辺(風が強い) |
| アクセント (英語) | スコットランド英語、ウェールズ英語、アイルランド英語、カナダ英語、オーストラリア英語、ニュージーランド英語 |
| 話し方 | 速い/標準/遅い速度、高い/標準/小さい音量、フォーマル/カジュアル |
| デバイスの位置 | ハンドヘルド、デスクトップ |
スピーカー、テレビ、家電製品など、瞬時に起動し、周囲の雑音を排除する必要がある機器向けのウェイクワードデータ。
ハンズフリー車内アシスタント向け、遠距離かつノイズ耐性に優れたウェイクワードデータセット。
常時稼働でバッテリー消費が厳しいデバイス向けの、データ使用量の少ないウェイクワードデータ。
言語や方言を問わずアシスタントをローカライズするための、カスタムウェイクワードと発話データ。
プライバシーを最優先に、デバイス上で起動するウェイクワードデータを利用して、ハンズフリーの臨床現場や患者対応環境を実現します。
クラウドを使わずにリアルタイムで応答するロボットのための、マルチモーダルなウェイクワードおよびコマンドデータ。
Shaipは、お客様と協力して、音韻的に特徴的でブランドイメージに合ったウェイクワードを選定し、収集ガイドラインを定義します。
Shaipのグローバルな従業員は、必要な言語、アクセント、年齢、デバイス、騒音環境など、あらゆる状況に対応してウェイクワードを記録します。
各発話は文字起こしされ、ラベル付けされ、お客様の承認基準に基づいて品質チェックが行われます。
Shaipは、モデルパイプライン向けにフォーマットされた、構造化され、ポリシー制御されたウェイクワードトレーニングデータを提供します。
AIイニシアチブを効果的に展開するには、大量の特殊なトレーニングデータセットが必要になります。 Shaipは、規制/ GDPR要件に準拠した大規模な世界クラスの信頼性の高いトレーニングデータを保証する、市場で数少ない企業のXNUMXつです。
カスタムガイドラインに基づいて、世界中の100か国以上からカスタムビルドのデータセット(テキスト、音声、画像、動画)を作成、キュレート、収集します。
30,000人以上の経験豊富で資格のある貢献者のグローバルな労働力を活用してください。 柔軟なタスク割り当てとリアルタイムの従業員容量、効率、および進捗状況の監視。
当社独自のプラットフォームと熟練した労働力は、AIトレーニングデータセットを収集するために設定された品質基準を満たすか上回るために、複数の品質管理方法を使用しています。
私たちのプロセスは、アプリとウェブインターフェースから直接、タスクの配布、管理、データキャプチャを簡単にすることで、収集プロセスを合理化します。
プライバシーを優先することにより、完全なデータの機密性を維持します。 データ形式がポリシーで管理され、保持されていることを確認します。
顧客データ収集ガイドラインに基づいて業界固有のソースから収集された、厳選されたドメイン固有のデータ。
Shaip は、150 以上の言語でエンドツーエンドの音声/音声データ収集サービスを提供し、音声対応テクノロジが世界中の多様な聴衆に対応できるようにします。
会話したチャットボットは、大量の音声認識データセットを使用してトレーニング、テスト、構築された高度な会話型 AI システムで実行されます。 これは、機械をインテリジェントにする技術の背後にある基本的なプロセスです。
発話トレーニングの必要性が生じるのは、スクリプト化された形式で音声アシスタントとやり取りしたり質問したりする際に、すべての顧客が正確な単語やフレーズを使用しているわけではないためです。
チームが世界をリードするAI製品を構築できるようにします。


ウェイクワードとは、「Alexa」「OK Google」、または独自のブランドフレーズなど、音声認識デバイスを起動させ、受動的なリスニング状態から能動的なリスニング状態に切り替えます。デバイスはウェイクワードを常にローカルで待機し、ウェイクワードが検出されて初めてリクエストの処理を開始します。
ウェイクワード学習データとは、モデルにその起動フレーズを認識させるために使用される、ラベル付けされた音声録音のセットです。効果的なウェイクワード学習データは、多様な話者、アクセント、年齢、デバイス、およびノイズ環境を網羅しているため、モデルは類似した音声を拒否しながら、確実に起動することができます。
ウェイクワードは、常に音声を聞き取る小型の検出モデルを実行することで機能します。このモデルは、入力された音声から目的のフレーズをスキャンします。モデルがウェイクワードを十分な確信度で検出すると、デバイスが起動し、音声認識と自然言語処理を用いてユーザーの要求の処理を開始します。
効果的なカスタムウェイクワードは、多様な音素を使用し、少なくとも3~4音節を含み、誤作動を減らすために一般的な日常語を避ける必要があります。「Hey」や「OK」などの接頭辞を追加することで、識別性が向上します。Shaipは、プロジェクト設定時にウェイクワードの選択と検証を支援します。
はい。デバイス上でのウェイクワード検出は、起動モデルをローカルで実行するため、音声は録音されず、クラウドにも送信されません。これにより、遅延が低減され、プライバシーが保護され、オフラインでも検出が機能します。Shaipは、デバイス上および組み込みシステムでの展開に特化したトレーニングデータを収集します。
Shaipは、100以上の言語と幅広い地域アクセントに対応したウェイクワード学習データを収集しており、これは100カ国以上のグローバルな従業員から得られたものです。この幅広いデータ量により、非ネイティブスピーカーの発音精度のギャップが縮小し、グローバルな製品展開をサポートします。
Shaipは、転写レビュー、承認基準、作業員監視など、複数の品質管理プロセスを適用することで、データセットが納品前に目標精度を満たすようにします。多様で高品質なデータを使用することで、展開されたモデルにおける誤承認率と誤拒否率の両方を低減できます。
ウェイクワードはデバイスを起動させるものであり、発話とはそれに続く音声による要求のことです。ウェイクワード検出は常時オンの狭い範囲のタスクである一方、発話理解は多様な自然言語のフレーズを解釈することを伴います。Shaipは、ウェイクワード検出と発話収集の両方のためのトレーニングデータを提供します。
発話とは、ユーザーが音声コマンドソフトウェアに要求を行うために発するフレーズのことです。ソフトウェアは発話からユーザーの意図を識別し、それに応じて応答します。完全な文とは異なり、発話は完全な考えを伝えるとは限らず、しばしば間が含まれる音声単位です。例:「先週公開された最新の映画を見せてください」または「22番街の店は今開いていますか?」
呼び出し名とは、音声ソフトウェア内で特定の「スキル」を起動するために使用されるキーワードです。人名や地名を含めることができ、アクション、コマンド、質問と組み合わせることも可能です。すべてのカスタムスキルは、起動するために呼び出し名が必要です。
ウェイクワードは、トリガーワード、ホットワード、アクティベーションワード、インヴォケーションワード、ウェイクフレーズ、発話などとも呼ばれます。
Alexaは複数の内蔵マイクを使用してウェイクワードを検出し、同時に周囲の雑音を除去します。誤検出や見逃しを防ぐため、「Alexa」を検出してから初めて音声認識を開始します。

当サイトでは、お客様の利便性向上のためクッキーを使用しています。当サイトを利用することで、お客様はクッキーの使用に同意したことになります。
以下の Cookie 設定を管理します。
エッセンシャルCookieは、基本的な機能を有効にし、Webサイトが適切に機能するために必要です。
Google タグ マネージャーを使用すると、コードを変更することなく、ウェブサイト上のマーケティング タグの管理が簡単になります。
統計 Cookie は匿名で情報を収集します。この情報は、訪問者が当社の Web サイトをどのように使用しているかを理解するのに役立ちます。
Google アナリティクスは、ウェブサイトのトラフィックを追跡、分析し、情報に基づいたマーケティングの意思決定を行う強力なツールです。
サービスURL:policies.google.com (新しいウィンドウで開きます)
マーケティング クッキーは、ウェブサイトへの訪問者を追跡するために使用されます。その目的は、個々のユーザーにとって関連性が高く、魅力的な広告を表示することです。
Google広告は、企業がGoogle検索結果や提携サイトに表示されるターゲット広告を作成できるオンライン広告プラットフォームです。
サービスURL:policies.google.com (新しいウィンドウで開きます)
HubSpotは、ビジネスの成長を効率化するオールインワンのマーケティング、セールス、カスタマーサービスプラットフォームです。
サービスURL:legal.hubspot.com (新しいウィンドウで開きます)
詳細については、当社のクッキーポリシーおよびプライバシーポリシーをご覧ください。