-
会社

人工知能(AI)が人間の生活のあらゆる側面をどのように変えていくかについては、長らく議論が交わされてきました。そして今や、AIが史上最も破壊的な技術となる可能性を秘めていることは、皆さんも既にお気づきでしょう。今日では、Siri、Cortana、GoogleといったAIアシスタントに話しかけることで基本的な質問への回答を得ることができますが、その真の可能性はまだ多くが未知数です。
人間の言語を真に理解するAIを構築するには、生データだけでは不十分です。企業規模で提供される、言語学の専門家による高精度なラベル付けが施されたトレーニングデータセットが不可欠です。Shaipは、世界中のAIチーム向けにエンドツーエンドの自然言語処理サービスとソリューションを提供する大手NLPサービスプロバイダーです。カスタムテキストおよび音声データの収集から、専門家によるアノテーション、既製のNLPデータセット、150以上の言語に対応したフルマネージドの人材派遣まで、幅広いサービスを提供しています。
会話型AIシステムのトレーニング、大規模言語モデル(LLM)のファインチューニング、感情分析エンジンの構築、固有表現認識(NER)パイプラインのスケーリングなど、どのような用途であっても、Shaipの30万人を超える資格保有協力者が、モデルが実世界で正確に動作するために必要な、構造化された高品質のNLPトレーニングデータを提供します。医療、金融、テクノロジー、小売など、フォーチュン500企業から信頼されているShaipのNLPソリューションは、独自のプラットフォームツール、6シグマ品質プロセス、ドメインエキスパートを組み合わせることで、本番環境レベルのAIに求められる精度とスループットを実現します。

高性能な言語モデルはすべて、専用に構築されたドメイン固有のトレーニングデータから始まります。ShaipのNLPデータ収集サービスは、モデルに必要な正確な入力データを、十分な量で、お客様の言語で、そして実際の運用環境で求められる言語的多様性を備えて提供します。
当社は、メール、顧客レビュー、ソーシャルメディア投稿、サポートチケット、法的契約書、財務文書など、さまざまな形式の大量のカスタマイズされたテキストコーパスを収集しています。150以上の言語と地域の方言に対応した当社のテキスト収集サービスは、チャットボットのトレーニング、LLMの微調整、検索関連性システム、文書理解パイプラインなどに活用されています。
Shaipは、スクリプト化されたプロンプトから自然な会話まで、お客様のASR(自動音声認識)または音声AIの要件に合わせてカスタマイズされた高品質の音声録音を収集します。これには、特定のアクセント、ノイズ環境、話者の属性、チャネルの状態などが含まれます。これらのデータは、スタンドアロンのコレクションとして、または文字起こし、発音辞書、言語固有のドキュメントを含む完全なASRバンドルとして提供され、モデルの即時トレーニングを可能にします。収集されたすべてのデータは、完全なメタデータ、話者情報、およびShaip独自の注釈プラットフォームによる品質検証とともに提供されます。
高精度な自然言語処理(NLP)モデルには、正確に注釈付けされたトレーニングデータが不可欠です。Shaipのデータ注釈サービスは、資格を有する多言語対応の専門スタッフと独自のプラットフォームを組み合わせることで、企業規模で一貫して精度の高いラベルを提供します。さらに、品質管理機能と透明性の高い納品追跡機能も備えています。

当社のNLPアノテーション機能は、主要なタスクタイプすべてを網羅しています。
すべての注釈は、注釈者間の合意度スコアリングと継続的なフィードバックループを備えた、6シグマのステージゲート品質プロセスを通じて提供されます。

当社は、お客様のチームの一員として、お客様のご希望のツールを使用し、必要な品質を維持しながらデータ注釈作業をサポートする熟練した人材を提供します。経験豊富な当社のスタッフは、人間の言語の微妙なニュアンスを理解し、数百万件の音声およびテキスト文書のラベリングで培ったベストプラクティスを適用することで、自然言語処理のための世界クラスのデータラベリングソリューションを提供します。

テキスト/音声データの収集からアノテーションまで、当社は詳細かつ正確にラベル付けされたテキストと音声データを提供することで、音声世界への理解を深め、NLPモデルのパフォーマンス向上を支援します。仮想/デジタルアシスタントのトレーニング、法的契約書のレビュー、財務分析アルゴリズムの構築など、お客様のニーズに合わせて、モデルを実世界で活用するために必要な最高水準のデータを提供します。当社のチームは、お客様のビジネス要件に基づき、言語、方言、構文、文構造を熟知しており、テキストに正確なタグ付けを行います。
当社は、高度な言語能力を誇る数少ない自然言語処理(NLP)企業の一つです。世界中から集まった30,000万人を超える従業員が、 150以上の言語に精通しています。創業間もないスタートアップ企業、中小企業、そしてフォーチュン500に名を連ねる大手企業まで、ヘルスケア、小売・eコマース、金融、テクノロジーなど、様々な業界のお客様のNLPプロジェクト目標達成を支援してきました。
デジタルアシスタントのトレーニングには、さまざまな地域、言語、方言、設定、形式からの高品質のデータが大量に必要です。 Shaipでは、必要な知識とドメインの専門知識を持ち、クライアントの特定のニーズを十分に認識しているヒューマンインザループのAIモデルのトレーニングデータを提供しています。
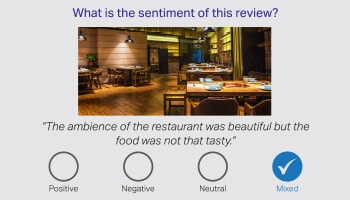
言葉だけでは全体像を伝えることができず、人間の言語の曖昧さを解釈する責任は人間のアノテーターにあると正しく言われています。 したがって、会話に基づいて顧客の感情を特定することが最も重要です。 さまざまな分野の言語専門家が、製品レビュー、金融ニュース、ソーシャルメディアのニュアンスを解釈できます。
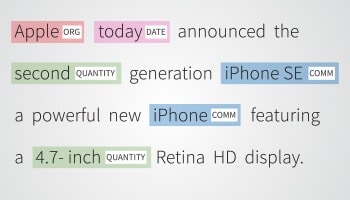
固有表現抽出(NER)は、テキスト内の固有表現抽出を識別、抽出、および分類して、事前定義されたカテゴリに分類します。 テキストは、場所、名前、組織、製品、数量、価値、パーセンテージなどに分類できます。NERを使用すると、記事で言及された組織など、実際の質問に答えることができます。
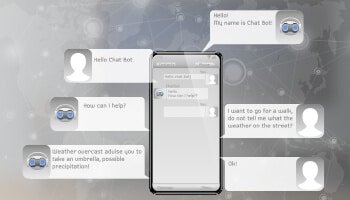
堅牢で十分に訓練された仮想チャットボットまたはデジタルアシスタントは、顧客が売り手と通信する方法に革命をもたらし、顧客体験を大幅に向上させました。
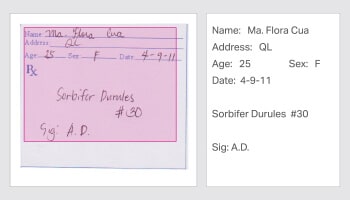
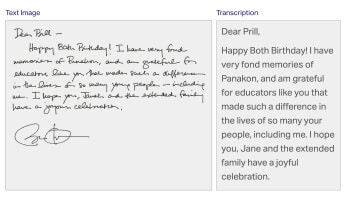
医師の手書きの処方箋から会議のメモまで、当社のスペシャリストは、アーカイブされたドキュメント、法的契約、患者の健康記録など、あらゆる形式のデータをデジタル化できます。
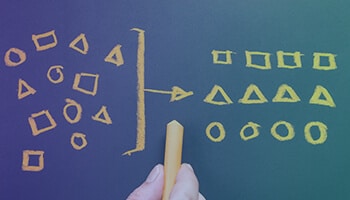
分類またはタグ付けとも呼ばれる分類は、テキストを整理されたグループに分類し、関心のある機能に基づいてラベルを付けるプロセスです。
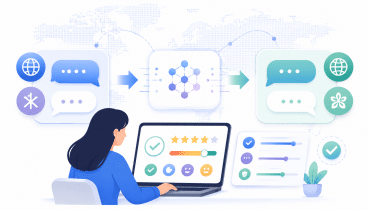
機械翻訳の出力結果を人間が評価し、後編集することで、流暢さ、適切性、ドメインの正確性を測定し、多言語展開に対応した信頼性の高い機械翻訳システムを実現します。
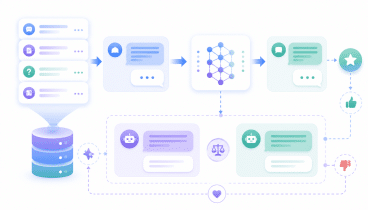
厳選された指示遵守データセット、プロンプトと応答のペア、およびRLHF嗜好データを使用して、大規模な言語モデルを、お客様のドメイン、トーン、およびタスクの要件に合わせて微調整および整合させます。
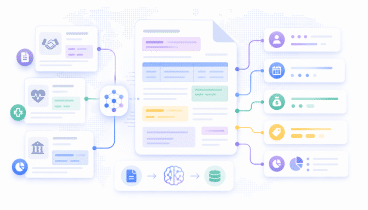
契約書、医療記録、財務書類などの複雑な文書構造に注釈を付け、非構造化テキストを大規模に抽出、分類、推論する文書AIモデルを訓練する。
トピック分析またはトピックのラベル付けとは、検討中の繰り返しのトピック/テーマを特定することにより、特定のテキストから意味を特定して抽出することです。
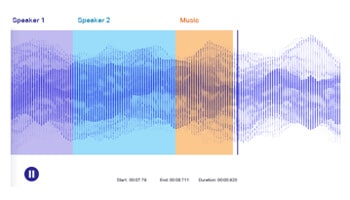
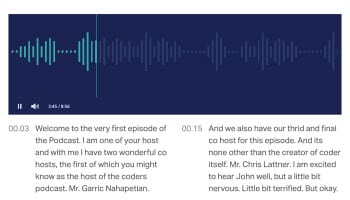
スピーチ/ポッドキャスト/セミナーを書き起こし、会話をテキストに呼び出します。 人間を活用してオーディオ/音声ファイルに正確に注釈を付け、NLPモデルを正確にトレーニングします。

音または発話を分類して、言語、方言、セマンティクス、辞書などに基づいて音声/音声を分類します。
テキスト/音声注釈/ラベリングに精通した専門家のプールは、正確で効果的に注釈が付けられたNLPデータセットを調達できます。
私たちのチームは、AIエンジンをトレーニングするためのテキスト/オーディオデータの準備を支援し、貴重な時間とリソースを節約します。
私たちの協力者チームは、NLPソリューションのデータ出力の品質を維持しながら、追加のボリュームに対応できます。
チームのトレーニングと管理の専門家として、プロジェクトが定義された予算内で確実に提供されるようにします。
チームは複数のソースからのデータを分析し、すべての業界にわたってAIトレーニングデータを効率的かつ大量に生成することができます。
幅広いオーディオ/テキストデータは、AIに、より高速なトレーニングに必要な大量の情報を提供します。

専任の訓練を受けたチーム:

最高のプロセス効率が保証されます:

特許取得済みのプラットフォームには次のような利点があります。
AIチャットボットは、以前のインタラクションから学習し、ユーザーの行動を理解し、高度な意思決定スキルを使用してさまざまな言語を理解することにより、ユーザーエクスペリエンスを向上させます。

自動音声認識 (ASR) は長い道のりを歩んできました。 ずっと前に発明されましたが、ほとんど誰も使用していませんでした。 しかし、時代と技術は現在大きく変化しています。

世界の自然言語処理市場は、1.8 年の 2021 億ドルから 4.3 年には 2026 億ドルに増加し、期間中の CAGR は 19.0% になると予測されています。
チームが世界をリードするAI製品を構築できるようにします。


NLP は人工知能の分野であり、文脈、感情、意図を解釈することで、機械が人間の言語(テキストと音声の両方)を理解、分析、応答できるようにします。
NLPは、文法、構文、意味、文脈を分析するアルゴリズムを用いて人間の言語を処理する技術です。大量の注釈付きデータを用いてAIモデルを学習し、意味を抽出し、パターンを識別し、正確な応答を生成します。
NLPは、バーチャルアシスタント、チャットボット、感情分析、機械翻訳、テキスト要約、スパム検出、文法修正などのアプリケーションで利用されています。人間とコンピュータのインタラクションをより効率的かつ自然にするシステムを支える基盤となっています。
NLP サービスには、テキスト収集 (多様なテキスト データの取得)、音声収集 (音声データの録音)、データ注釈 (AI のトレーニング用にテキストと音声にラベルを付ける)、および文字起こし (分析用に音声をテキストに変換する) が含まれます。
NLPソリューションは、モデルが人間の言語をより深く理解するのに役立つ、正確にラベル付けされたデータセットを提供することで、AIモデルを強化します。これにより、感情分析、固有表現抽出(NER)、会話型AI、チャットボットのトレーニングなどのタスクが改善されます。
主な業界には、ヘルスケア(医療記録と患者の感情の分析)、金融(不正検出と文書分析)、電子商取引(パーソナライズされた推奨事項と顧客サポートの自動化)などがあります。
タイムラインはプロジェクトの規模と複雑さによって異なりますが、高品質のデータを効率的に提供できるように最適化されています。
厳格な検証プロセス、専門の注釈者、高度なツールを通じて品質が保証され、データが最高水準を満たすことが保証されます。
費用は、プロジェクトの範囲、データの複雑さ、カスタマイズの必要性などの要因によって異なります。お客様の要件に基づいた個別のお見積もりについては、Shaipまでお問い合わせください。
NLP as a Serviceとは、NLPサービスプロバイダーが言語データパイプラインのあらゆる段階(収集、アノテーション、品質保証、配信)をお客様に代わって処理する、完全管理型のデータ配信モデルを指します。Shaipは、さまざまな組織のニーズやプロジェクト規模に合わせて、プロジェクトベース、サブスクリプション、組み込みチームといった配信モデルを提供しています。
各言語プールは、専門知識に基づいて採用・選考されたネイティブスピーカーまたはネイティブに近いレベルの話者で構成されています。アノテーションはゴールドスタンダードの参照セットに基づいて較正され、アノテーター間の合意スコアリングを含む6シグマのステージゲート品質プロセスにより、すべての言語ペアと方言で一貫性が確保されます。
Shaipは、医療分野の自然言語処理(NLP)プロジェクトにおいてHIPAA(医療情報保護法)に準拠したワークフローを運用し、EUにおけるデータ収集に関するGDPR(一般データ保護規則)の同意管理要件にも準拠しています。すべてのプロジェクトには、監査証跡文書、データ来歴記録、および企業コンプライアンスチーム向けのロールベースのアクセス制御が含まれています。
はい。Shaipは、LLMの微調整とアライメントのために、指示に従うデータセット、プロンプトと応答のペア、およびRLHF嗜好データを提供します。当社の生成AIソリューションページでは、LLMトレーニングデータサービスの全範囲を網羅しています。
データ収集とは、モデルの学習対象となる入力素材である生のテキストや音声を収集することです。アノテーションとは、その生データに構造化されたタグ、カテゴリ、エンティティ、または感情指標を付与し、モデルが理解すべき内容を指示することです。Shaipは、これらのサービスを単体サービスとして、または統合されたエンドツーエンドの自然言語処理(NLP)データソリューションとして提供しています。
はい。Shaipは、創業間もないスタートアップ企業、中小企業、そしてフォーチュン500企業など、幅広い規模の企業と協業してきました。柔軟なプロジェクト範囲設定、MVP(最小実行可能製品)段階のAI向け最小限データセットパッケージ、そしてアノテーション要件に合わせて拡張可能なデリバリーモデルを提供しています。カスタム見積もりについては、お気軽にお問い合わせください。

当サイトでは、お客様の利便性向上のためクッキーを使用しています。当サイトを利用することで、お客様はクッキーの使用に同意したことになります。
以下の Cookie 設定を管理します。
エッセンシャルCookieは、基本的な機能を有効にし、Webサイトが適切に機能するために必要です。
Google タグ マネージャーを使用すると、コードを変更することなく、ウェブサイト上のマーケティング タグの管理が簡単になります。
統計 Cookie は匿名で情報を収集します。この情報は、訪問者が当社の Web サイトをどのように使用しているかを理解するのに役立ちます。
Google アナリティクスは、ウェブサイトのトラフィックを追跡、分析し、情報に基づいたマーケティングの意思決定を行う強力なツールです。
サービスURL:policies.google.com (新しいウィンドウで開きます)
マーケティング クッキーは、ウェブサイトへの訪問者を追跡するために使用されます。その目的は、個々のユーザーにとって関連性が高く、魅力的な広告を表示することです。
Google広告は、企業がGoogle検索結果や提携サイトに表示されるターゲット広告を作成できるオンライン広告プラットフォームです。
サービスURL:policies.google.com (新しいウィンドウで開きます)
HubSpotは、ビジネスの成長を効率化するオールインワンのマーケティング、セールス、カスタマーサービスプラットフォームです。
サービスURL:legal.hubspot.com (新しいウィンドウで開きます)
詳細については、当社のクッキーポリシーおよびプライバシーポリシーをご覧ください。