コンピュータビジョンに画像トレーニングデータセットが必要なのはなぜですか?
画像データ収集とは、コンピュータビジョンや機械学習モデルのトレーニングに使用する画像データセットをキャプチャ、収集、整理するプロセスです。Shaipは、顔、文書、物体、風景、医療画像など、各モデルのドメイン、解像度、人口統計学的要件に合わせてカスタマイズされた、同意を得たカスタム画像を収集し、シックスシグマプロセスを通じてすべての画像の品質チェックを行います。
機能の一部としてオブジェクトとパターンを識別することを任務とするスマートMLモデルとセットアップは、広範囲にわたってトレーニングする必要があります。 人間の感情への相互作用の追跡から始めて、インテリジェントシステムは最初にエンティティを識別するための基礎を持たなければなりません。 識別の力は、カスタム画像データ収集ソリューションによって提供されます。
コンピュータビジョンシステムの画像データ収集には、次の利点があります。
- 独自の画像固有のリポジトリ
- 要件に応じて画像にラベルを付ける機能
- 大量の履歴データへのアクセス
プロフェッショナルな画像トレーニングデータセット
任意の主題。 任意のシナリオ。
顔やジェスチャーのタグ付けが必要なアプリケーションには、表面的に情報を提供することはできません。 代わりに、機械学習モデルの画像データ収集は、最新の標準と同等である必要があります。 Shaipでは、スケーラビリティに向けた専門家レベルのサポートを備えた包括的な画像トレーニングデータセットへのアクセスを提供することに重点を置いています。
Shaipのプロフェッショナル向け画像トレーニングデータセットは、エンティティ追跡、手書き文字分析、物体識別、パターン認識など、包括的なソリューションに重点を置いています。それだけではありません!Shaipが提供する画像データ収集サービスには、以下のものも含まれます。
- リモートおよびフィールド内のデータフィード
- ソリューションを拡張する機能–継続的なデータセット調達
- マイニングの準備ができている高品質でセグメント化されたデータ
- 画像からテキストへの文字起こしのサポート OCR 訓練されたモデル
- 人間固有の分析の広範なサポート
- 安全なデータ処理と管理
Tsunaguの専門領域
主題とシナリオに先行する画像コレクション
Shaip では、特定のユースケースと同義のアルゴリズムを備えた、画像データセットのコレクション タイプをすべて取り揃えています。さまざまなユースケース向けに大量の画像データセット (医療画像データセット、請求書画像データセット、顔データセット コレクション、または任意のカスタム データ セット) を収集することで、コンピューター ビジョンを機械学習機能に追加できます。Shaip では、特定のユースケースと同義のアルゴリズムを備えた、画像データセットのコレクション タイプをすべて取り揃えています。当社が提供するさまざまなタイプの画像データセット:
文書およびOCR画像コレクション
Shaipは、請求書、領収書、身分証明書、パスポート、手書きの書類などを、OCRおよび文書理解モデル向けに、複数の言語と様々な撮影条件でキャプチャします。ユースケース:OCR、KYC(顧客確認)、文書分類。
顔画像および人口統計画像コレクション
Shaipは、人種、年齢、頭部の姿勢、照明条件など、さまざまな条件で顔画像データセットを収集し、AIのバイアスを低減します。また、認識モデルや感情モデル向けにランドマークポイントオプションも提供しています。ユースケース:顔認識、感情AI、ADASドライバーモニタリング。
ヘルスケアデータ収集
提供されている定性的および定量的な医療データセットを使用して、デジタル医療設定の品質と医療診断の精度を向上させます。 CTスキャン、MRI、超音波、放射線、腫瘍学、病理学などのさまざまな専門医からのX線などの医用画像を提供します。
食品データセットコレクション
さまざまな照明条件下で食べ物の画像をキャプチャして識別することができるスマートアプリの開発を計画している場合は、食べ物のデータセットコレクションが非常に便利です。
自動車データ収集
自動車のデータセットを使用すると、道路脇の要素、角度固有の洞察、オブジェクト、セマティックデータなどを使用して自動運転車のデータベースをトレーニングできます。
ハンドジェスチャデータ収集
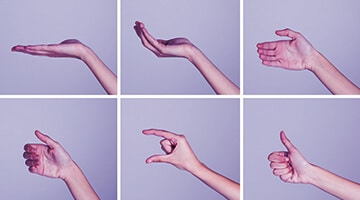
あなたが今までにあなたの携帯電話を手でスワイプして眠らせたことがあるなら、あなたは関係することができるでしょう。 センサーを備えたスマート&IoTデバイスは、当社のハンドジェスチャデータ収集サービスの恩恵を受けることができます。
オブジェクト画像コレクション
当社のオブジェクト画像コレクション サービスは、さまざまな状況や照明条件でさまざまなオブジェクトをフィーチャーした幅広い画像を提供します。
ランドマーク画像コレクション
私たちは世界中からランドマークの画像を収集することに特化しています。当社のデータセットは、複数の角度、時間帯、気象条件をカバーしています
手書きテキストコレクション
手書きテキストを正確に認識して解釈できる AI モデルを開発するための、さまざまな言語とスタイルの手書きテキスト画像のコレクション。
画像データセット
焦点の合った車の運転手画像データセット
450以上の民族からの20,000人のユニークな参加者をカバーするさまざまなポーズとバリエーションの車のセットアップでのドライバーの顔の10万枚の画像
- 使用事例: 車載ADASモデル
- フォーマット: 画像
- ボリューム: 455,000件以上
- 注釈: いいえ
ランドマーク画像データセット
カスタム要件に基づいて収集された、80か国以上のランドマークの40k以上の画像。
- 使用事例: ランドマークの検出
- フォーマット: 画像
- ボリューム: 80,000件以上
- 注釈: いいえ
顔画像データセット
頭のポーズ、民族、性別、背景、キャプチャ角度、年齢など、12のランドマークポイントを含む68kの画像
- 使用事例: 顔認識
- フォーマット: 画像
- ボリューム: 12,000件以上
- 注釈: ランドマーク注釈
食品画像データセット
55以上のバリエーション(食品の種類、照明、屋内と屋外、背景、カメラの距離など)の50k枚の画像と注釈付きの画像
- 使用事例: 食品認識
- フォーマット: 画像
- ボリューム: 55,000件以上
- 注釈: はい
仕組み/プロセス
範囲と仕様
主題、量、地域、対象者、形式、および同意要件を定義する。

パイロット&キャリブレーション
規模を拡大する前に、小規模なパイロットテストを実施して、ガイドラインと例外的なケースを検証してください。
本格的なコレクション
Shaipの厳選されたグローバルな寄稿者ネットワークを通じて、大量のコンテンツを収集しましょう。

シックスシグマ品質保証
多段階検証、ゴールドタスク、および各バッチに対するコンプライアンスチェック。
配送とリフレッシュ
メタデータ付きの指定フォーマットで配信し、必要に応じて配信範囲を拡張してください。
Shaipを選ぶ理由
スクレイピングではなくカスタム: Shaipは、公開されている画像セットを再パッケージ化するのではなく、ドメイン、解像度、ユーザー層の構成など、お客様の正確な仕様に合わせて、最新の、完全に同意を得た画像を収集します。
シックスシグマ品質:シックスシグマのブラックベルトで構成された専任チームが、継続的なフィードバックループを備えたステージゲート方式の品質保証プロセスを実行し、検証済みのデータセットを出荷します。
バイアスを考慮した報道: Shaipは、人種、年齢、地域、照明条件など、あらゆる側面から情報を収集することで、データ層における視覚AIのバイアスを低減します。
提供されるサービス
エキスパートのテキストデータ収集は、包括的なAIセットアップのためのすべてのハンズオンデッキではありません。 Shaipでは、次のサービスを検討して、モデルを通常よりもはるかに普及させることもできます。
推奨リソース
バイヤーガイド
コンピュータビジョンの画像注釈とラベリング
コンピュータビジョンとは、視覚世界を理解してコンピュータビジョンアプリケーションをトレーニングすることです。 その成功は、私たちが画像注釈と呼ぶものに完全に要約されます。これは、マシンにインテリジェントな意思決定を行わせるテクノロジーの背後にある基本的なプロセスであり、これがまさに私たちが議論および調査しようとしていることです。
ソリューション
コンピュータビジョンサービスとソリューション
コンピュータビジョンは、人工知能技術の一分野であり、機械が人間のように視覚世界を見て、理解し、解釈できるように訓練するものです。これにより、機械学習モデルを開発し、画像や動画内の物体を、より大規模かつ高速に、正確に理解、識別、分類することが可能になります。
Blog
画像注釈の種類:長所、短所、ユースケース
コンピュータがオブジェクトを見て解釈し始めて以来、世界は同じではありません。 顔に面白いあごひげを生やすSnapchatフィルターのような単純な要素から、スキャンレポートから微細な腫瘍の存在を自律的に検出する複雑なシステムまで、コンピュータービジョンは人類の進化において主要な役割を果たしています。
注目のクライアント
チームが世界をリードするAI製品を構築できるようにします。
独自の画像データセットリポジトリを構築したいですか?
画像トレーニングデータセットの鳥瞰図を入手して、コンピュータビジョンモデルのリポジトリを取得してください。
よくある質問(FAQ)
AI/ML向け画像データ収集とは、画像を解釈する機械学習モデルのトレーニング、テスト、検証を行うために、写真、スキャン画像、グラフィックなどの視覚データを収集するプロセスです。収集された画像は、コンピュータビジョンシステムが現実世界の状況下で物体、顔、シーン、パターンを正確に認識するために必要な事例を提供します。
画像データの収集は、プロジェクトの要件と目標を定義することから始まります。画像はデータベースから取得したり、カメラで新たに撮影したり、必要に応じて生成したりしますが、その際、多様性と品質が最優先事項となります。収集された画像は通常、機械学習モデルのトレーニングに必要なコンテキストと分類情報を追加するために、ラベル付けまたは注釈が付けられます。
画像データの収集は、視覚情報を扱うあらゆる機械学習プロジェクトにとって不可欠です。質の高い多様な画像データセットは、より正確で堅牢なモデル学習を可能にし、実世界でのパフォーマンス向上につながります。適切に収集されたデータは、AIシステムが実運用環境で直面するあらゆる状況において、視覚的な手がかりを確実に認識、解釈、応答することを保証します。
目的に応じて、写真、衛星画像、手書き文書やスキャン文書、顔写真、熱画像、AR/VRキャプチャなど、さまざまな種類のデータを収集できます。収集するデータの種類は、AI/MLプロジェクトの具体的な要件に合致している必要があります。なぜなら、ドメインの一致はモデルの精度に直接影響するからです。
カスタムコレクションは、モデルのドメイン、解像度、および人口統計学的ニーズに合わせて、同意を得た最新の画像を収集します。ImageNetやCOCOなどの公開データセットは汎用的で、多くの場合、モデルをプロトタイプ段階までしか構築できません。Shaipは、お客様の厳密な仕様に基づいてデータを収集するため、データはアプリケーションが処理する必要のある実際の状況、対象、およびエッジケースを反映したものとなります。
Shaipは、専任のブラックベルト・プロセスオーナーが主導するシックスシグマのステージゲート品質プロセスを採用し、各バッチごとに検証とフィードバックループを実施しています。データ層におけるビジュアルAIのバイアスを軽減するため、Shaipは人種、年齢、地域、照明条件など、あらゆる範囲からデータを収集し、特定のグループに偏ることなく、公平かつ一貫したモデルのパフォーマンスを実現しています。
はい。Shaipは、参加者の同意を得た上で、文書化された同意書に基づき、安全かつアクセス制御された方法で画像データを収集しています。これは、ライセンスが曖昧な公開画像が法的リスクを生み出す商用利用において特に重要です。
費用は画像の量と種類、対象地域、必要なメタデータ、同意要件によって異なるため、定額料金はありません。Shaipは、被写体、仕様、スケジュールに関する簡単な打ち合わせの後、お客様に合わせた見積もりを提供します。これにより、モデルにとって実際には必要のない収集範囲に対して料金を支払うことを防ぎます。