音声AI向け音声注釈および音声ラベリングサービス

150以上の言語に対応した、すぐに使えるオーディオデータセット ― 音声ラベル付け、文字起こし、話者ダイアライゼーション、音響イベントタグ付けを専門のアノテーターが提供

音声注釈

オーディオアノテーションとは何ですか?

音声アノテーションとは、音声ファイル内の話し言葉、音、話者、感情、音響イベントにラベルを付けるプロセスであり、これにより機械学習モデル(自動音声認識(ASR)、音声アシスタント、対話型AI、音声生成AIなど)が現実世界の音を解釈できるようになります。Shaipは、訓練を受けた言語学者アノテーターとAI支援ツール、そして6シグマ品質フレームワークを組み合わせたマネージドサービスとして、150以上の言語に対応した音声アノテーションを提供しています。

Tsunaguの専門領域

カスタムオーディオラベリング/注釈はもはや遠い夢ではありません

音声とオーディオのラベル付けサービスは、当初から Shaip の強みでした。 最先端の音声および音声ラベリング ソリューションを使用して、会話型 AI、チャットボット、音声認識エンジンを開発、トレーニング、改善します。 経験豊富なプロジェクト管理チームを擁する世界中の資格のあるリンギストのネットワークは、何時間もの多言語オーディオを収集し、大量のデータに注釈を付けて、音声対応アプリケーションをトレーニングすることができます。 また、音声ファイルを書き起こして、音声形式で利用できる有意義な洞察を抽出します。 目標に最も適した音声と音声のラベル付け手法を選択し、ブレインストーミングと技術的なことは Shaip にお任せください。

音声文字変換

音声文字起こしとタイムスタンプ

話者IDと単語レベルのタイムスタンプ付きの逐語的、非逐語的、および音声的文字起こしデータを提供し、ASRおよびSTTモデルのトレーニングに対応します。出力形式はJSON、TextGrid、ELAN、CTM、およびカスタムスキーマで、実用レベルのデータセットに対応します。
音声ラベル付け

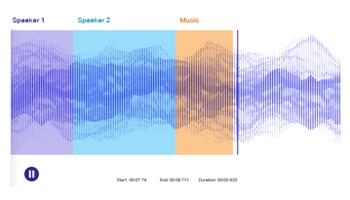
音声ラベリング

音声または音声のラベル付けは、音の分離と特定のメタデータによるラベル付けに関係する標準の注釈手法です。 この手法の本質には、音声の一部からの音の存在論的識別と、トレーニングデータセットをより包括的にするためにそれらに正確に注釈を付けることが含まれます。
音声分類

音響イベントと音の分類

環境音認識、監視、予知保全、臨床呼吸器AI向けに、アラーム音、咳、銃声、機械音、交通音、足音などの非音声オーディオにラベルを付けます。単一ラベルまたは複数ラベルに対応し、クライアントのスキーマに合わせたカスタム分類体系とAudioSet互換のエクスポートが可能です。
多言語音声データサービス

多言語音声注釈

150以上の言語と方言(リソースの少ない言語やインド系言語を含む)に対応したネイティブスピーカーのアノテーターが、コードスイッチングされた録音、地域特有のアクセント、文化的に固有の用語を処理します。英語のみ、または単一地域のみのベンダーでは対応できない言語カバレッジが必要とされるグローバルな音声AI展開において役立ちます。
自然言語の発話

自然言語発話(NLU)と意図の注釈

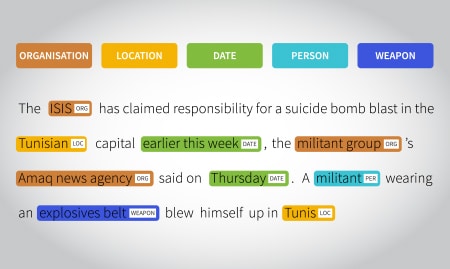
話し言葉に対する意図、エンティティ、スロットのタグ付けに加え、方言、意味、感情のレイヤーも備えています。このデータセット形式は、チャットボット、IVRシステム、音声アシスタント、生成型音声エージェントなど、実際の会話(単一の発話内で2つ以上の言語を切り替えて使用する場合を含む)に対応できるよう訓練されたアプリケーションに活用されます。
複数ラベルの注釈

マルチラベル
アノテーション

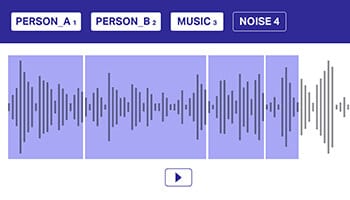
モデルが重複するオーディオソースを区別できるようにするには、複数のラベルを使用してオーディオデータに注釈を付けることが重要です。 このアプローチでは、オーディオデータセットはXNUMXつまたは複数のクラスに属している可能性があり、意思決定を改善するためにモデルに明示的に伝達する必要があります。
スピーカーのダイアリゼーション

話者ダイアリゼーションと識別

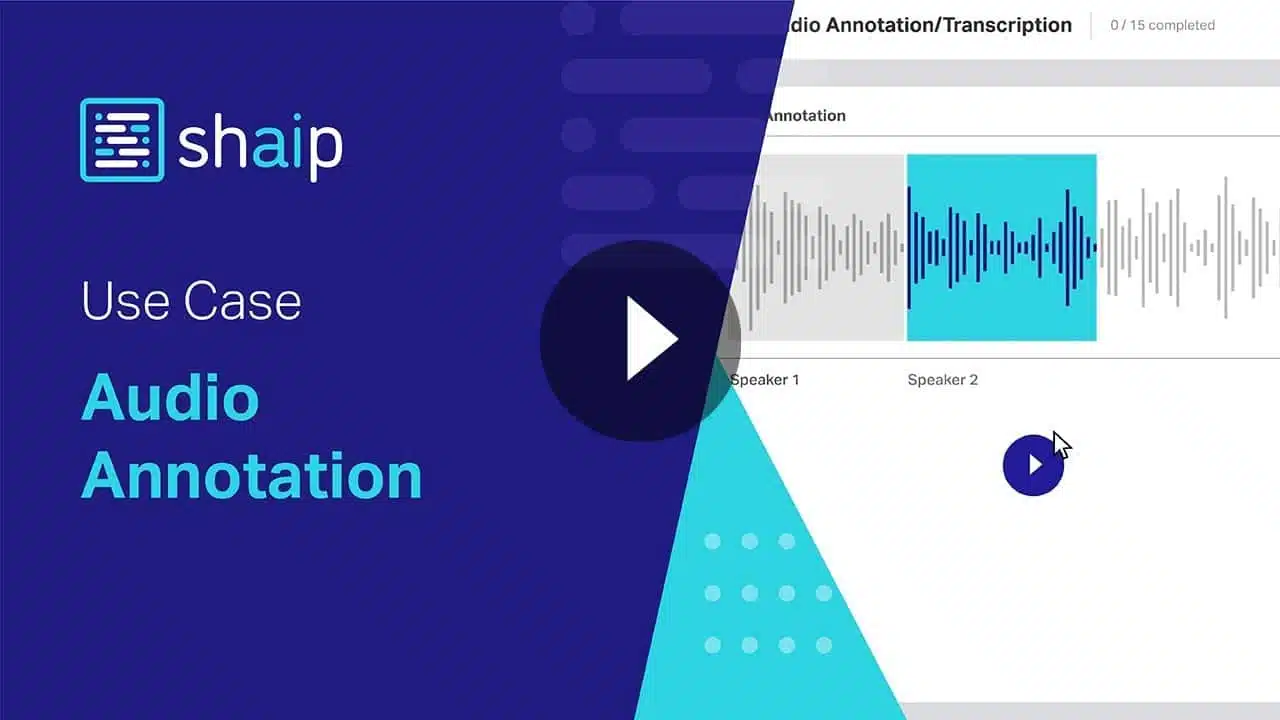
コールセンターの会話、臨床相談、会議など、長時間の録音データを話者ごとに均質なセグメントに分割する境界検出機能。ユースケースに応じて性別、年齢層、言語のタグ付けも行い、複数話者環境における音声の正確な識別を支援します。

音声転写

発音記号

音声を一連の単語に変換する通常の文字起こしとは異なり、音声文字変換は、単語がどのように発音されるかを記録し、音声記号を使用して音を視覚的に表現します。 発音表記を使用すると、複数の方言で同じ言語の発音の違いに気づきやすくなります。
生成AIおよびマルチモーダルAIのための音声注釈

生成型音声AI向けの専門的なラベル付け、音声出力用のRLHF、音声とテキストまたはビデオを組み合わせたマルチモーダルなトレーニングデータ、およびTTSデータセットの準備。会話モデルや音声クローンモデルの微調整のためのプロンプト応答音声ペア、嗜好ランキング、スタイル/トーンラ​​ベルが含まれます。

オーディオ分類の種類

音響データの分類

音声は、学校、家庭、カフェ、公共交通機関、車両など、録音環境ごとに分類され、単語だけでなく文脈を認識する必要のある音声認識、仮想アシスタント、オーディオライブラリ、監視システムなどのトレーニングに使用されます。

音楽や音声以外の音イベント(クラクション、サイレン、銃声、ガラスの割れる音、子供の遊び声、機械音など)は、パターンベースの分類が適用できないセキュリティAI、予知保全、スマートシティの導入向けにラベル付けされます。

 音楽ライブラリ、レコメンデーションシステム、著作権検出、コンテンツモデレーションのための、ジャンル、楽器、ムード、テンポ、アンサンブルのラベル。ジャンルやムードをまたぐ楽曲には、複数のラベルをタグ付けできます。

発話レベル(方言、意味、アクセント、トーンなど)で意図と意味を抽出することで、発言内容だけでなく、発言方法にも反応するチャットボット、音声アシスタント、対話型AIが実現する。

ヒューマンインテリジェンスを搭載した音声および音声注釈ツール

膨大なデータを収集したとしても、機械学習モデルが文脈や関連性を自力で理解できるとは期待されていません。たとえ自己学習型の自然言語処理モデルが実用化されたとしても、初期段階のトレーニング、あるいは教師あり学習では、メタデータが付加された音声リソースをモデルに与える必要があります。

Shaipは、標準的なユースケースに沿って、AIおよび機械学習のトレーニングに利用できる最先端のデータセットを提供することで、この分野で重要な役割を果たします。当社の専門スタッフと熟練したアノテーターチームが、関連するリポジトリに音声データをラベル付けし、分類する作業を常に行っています。

音声注釈
  • きめ細かいオーディオデータで自然言語処理のセットアップを充実させる
  • 対面およびリモートの注釈機能を体験する
  • マルチラベル注釈、ハンズオンなどの最高のノイズ除去技術を探る

信頼できるオーディオアノテーションパートナーとしてShaipを選択する理由

のワークプ

のワークプ

専任の訓練を受けたチーム:

  • データ作成、ラベリング、QAのための30,000人以上の協力者
  • 資格のあるプロジェクト管理チーム
  • 経験豊富な製品開発チーム
  • タレントプールソーシング&オンボーディングチーム

プロセス

プロセス

最高のプロセス効率が保証されます:

  • 堅牢な6シックスシグマステージゲートプロセス
  • シックスシグマ黒帯の専任チーム–主要なプロセス所有者と品質コンプライアンス
  • 継続的改善とフィードバックループ

Platform

Platform

特許取得済みのプラットフォームには次のような利点があります。

  • Webベースのエンドツーエンドプラットフォーム
  • 非の打ちどころのない品質
  • より速いTAT
  • シームレスな配信

オーディオデータのラベリング/アノテーションを外部委託する必要がある理由

専任チーム

データサイエンティストは、時間の80%以上をデータのクリーニングと準備に費やしていると推定されています。 アウトソーシングにより、データサイエンティストのチームは、面倒な作業を私たちに任せて、堅牢なアルゴリズムの開発を継続することに集中できます。

より良い品質

毎日と毎日に注釈を付ける専任のドメインエキスパートは、忙しいスケジュールで注釈タスクに対応する必要があるチームと比較して、いつでも優れた仕事をします。 言うまでもなく、出力が向上します。

スケーラビリティ

平均的な機械学習(ML)モデルでさえ、データの大きなチャンクにラベルを付ける必要があり、企業は他のチームからリソースを取得する必要があります。 私たちのようなデータ注釈コンサルタントを使用して、プロジェクトに専念し、ビジネスの成長に合わせて運用を簡単に拡張できるドメインエキスパートを提供します。

内部バイアスを排除する

AIモデルが失敗する理由は、データ収集と注釈に取り組んでいるチームが意図せずにバイアスを導入し、最終結果を歪め、精度に影響を与えるためです。 ただし、データ注釈ベンダーは、仮定とバイアスを排除することにより、精度を向上させるためにデータに注釈を付ける際により良い仕事をします。

提供されるサービス

エキスパートの画像データ収集は、包括的なAIセットアップのためのすべてのハンズオンデッキではありません。 Shaipでは、次のサービスを検討して、モデルを通常よりもはるかに普及させることもできます。

テキスト注釈

テキスト注釈サービス

私たちは、エンティティアノテーション、テキスト分類、感情アノテーション、およびその他の関連ツールを使用して、網羅的なデータセットに注釈を付けることにより、テキストデータトレーニングの準備を整えることを専門としています。
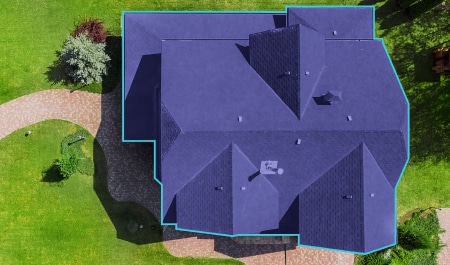
画像注釈

画像注釈サービス

私たちは、目の肥えたコンピュータービジョンモデルをトレーニングするために、セグメント化された画像データセットにラベルを付けることに誇りを持っています。 関連する手法には、境界認識と画像分類が含まれます。
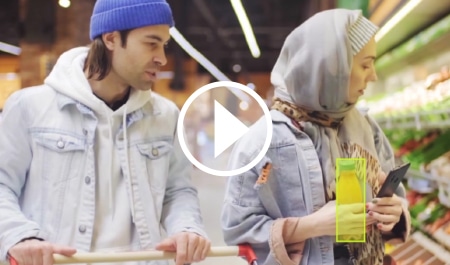
ビデオの注釈

ビデオ注釈サービス

Shaip は、コンピューター ビジョン モデルのトレーニング用のハイエンドのビデオ ラベリング サービスを提供しています。
ここでの目的は、パターン認識、オブジェクト検出などのツールでデータセットを使用できるようにすることです。
注目のクライアント

チームが世界をリードするAI製品を構築できるようにします。

音声注釈の専門家をオンボードで入手してください。

インテリジェント AI 用に、十分に研究され、細分化され、セグメント化され、マルチラベル化されたオーディオ データセットを準備します。

音声アノテーションとは、機械学習モデルが現実世界の音を解釈できるように、音声ファイル内の話し言葉、音、話者、感情、音響イベントにラベルを付けるプロセスです。文字起こしは単に音声をテキストに変換するだけですが、アノテーションはさらに進んで、誰が話しているか、どの言語を使っているか、どのような感情や背景音があるか、音声のどの部分で各イベントが発生したかなどをタグ付けします。音声アシスタント、自動音声認識システム、対話型AIはすべて、文字起こしされた音声だけでなく、アノテーションされた音声を必要とします。
Shaipは、タイムスタンプ付き音声文字起こし、話者ダイアリゼーションと識別、音響イベントとサウンドの分類、自然言語理解(NLU)と意図の注釈、音声文字起こし、重複する音声ソースのマルチラベル注釈、150以上の言語に対応した多言語音声注釈、RLHF選好ランキングやTTSデータセット準備を含む生成型音声AI向けの専門的なラベル付けを提供します。注釈は、オプションで専任チームによるマネージドサービスとして提供されます。
 
Shaipは、医療および臨床音声AI(呼吸イベント検出や医師の音声入力を含む)、対話型AIおよび音声アシスタント、多言語および騒音環境向けのASR/STT、コールセンター分析、車載音声、TTSや音声クローニングを含む生成型音声AIなど、幅広い分野の音声アノテーションをサポートしています。各分野は、その分野に精通したアノテーターによってサポートされており、必要に応じて、臨床ワークロード向けのHIPAAなどの特定のフレームワークへの準拠もサポートしています。
 
Shaipの音声アノテーションは、6シグマのステージゲート品質フレームワークに基づき、アノテーターによる自己チェック、ピアレビュー、専門家による監査、統計的サンプリングといった多段階レビューを経て実施されます。アノテーター間の合意度は測定され、タスクの複雑さにもよりますが、通常95%以上を維持しています。すべての言語でネイティブスピーカーのアノテーターが使用され、AIによる事前アノテーションによってばらつきが低減され、6シグマのブラックベルト資格を持つ専任チームがプロセス遵守と継続的改善ループを管理しています。
 
Shaipの注釈者ネットワークは、主要なヨーロッパ、東アジア、中東の言語、インド諸語、アフリカ諸語、そしてリソースの少ない言語を含む150以上の言語と方言を網羅しています。コードスイッチング(単一の発話内で2つの言語が交互に使用される)の録音は、多言語対応の注釈者によって処理されます。これは、バイリンガルまたはマルチリンガルのユーザーに対応するグローバルな音声AI展開にとって非常に重要です。
 
はい。音声注釈ワークフローは、ISO 27001認証取得済みの情報セキュリティ管理システムの下で運用され、保護対象医療情報(PHI)のマスキングを含むHIPAA準拠、EU居住データ主体向けのGDPR準拠となっています。アクセス制御と監査ログはSOC 2に準拠しており、機密性の高いデータセットについては、NDA(秘密保持契約)を締結した専任注釈チームまたはオンプレミスでの注釈を手配することも可能です。
音声生成AIや大規模音声モデルには、標準的な文字起こしデータ以上のデータが必要です。Shaipは、応答音声ペア、音声出力に対するRLHF選好ランキング、音声クローニング用の複数話者ラベル付きコーパス、音声スタイルと感情のタグ付け、およびTTSデータセットの準備を提供します。出力は一般的なファインチューニングパイプラインと互換性のある形式で提供され、モデルのバイアスを軽減するために、話者間の言語的および文化的多様性が制御されます。
 
はい。Shaipの注釈パイプラインは、背景雑音のオーバーレイ、コードスイッチング、フィールドレコーディングの状況、および医療、法律、金融、自動車、産業といった分野固有の用語に対応しています。音響イベントの分類体系は、臨床的な呼吸器イベント(咳、喘鳴)から産業音(アラーム、機械音)、セキュリティ関連イベント(銃声、ガラスの破損音)まで、クライアントのユースケースに合わせてカスタマイズでき、カスタム形式またはAudioSet互換形式でエクスポートできます。
 

システムが単語、アクセント、意図を識別できるようにラベル付けされたデータを提供し、転写と理解を向上させます。

課題としては、アクセントや方言への対応が挙げられます。シャイプは、グローバルな言語専門家とスケーラブルなプロセスを活用して、この問題に対処しています。