デモでは音声モデルは完璧に機能します。ところが、実際のユーザー、つまりスコットランド訛りでヒングリッシュ(英語と英語を混ぜた言葉)で注文する人が走行中の車から話しかけてくると、文字起こしがめちゃくちゃになってしまいます。
2026年の音声AIにおける不都合な真実はこうだ。モデルが失敗する理由は、アーキテクチャが間違っているからではない。データセットが世界の言語に対応していないからだ。トレーニングデータが拡張されない限り、音声モデルは拡張できない。だからこそ、多言語音声データは今日のAIにおいて最も戦略的な資産の一つとなるのだ。

なぜほとんどの音声AIモデルは実世界では失敗するのか
現実世界における音声AIの失敗の大部分は、10つの課題に起因する。特に、音声モデルの約7割は、トレーニングデータにおける言語的多様性の欠如が原因で失敗している。
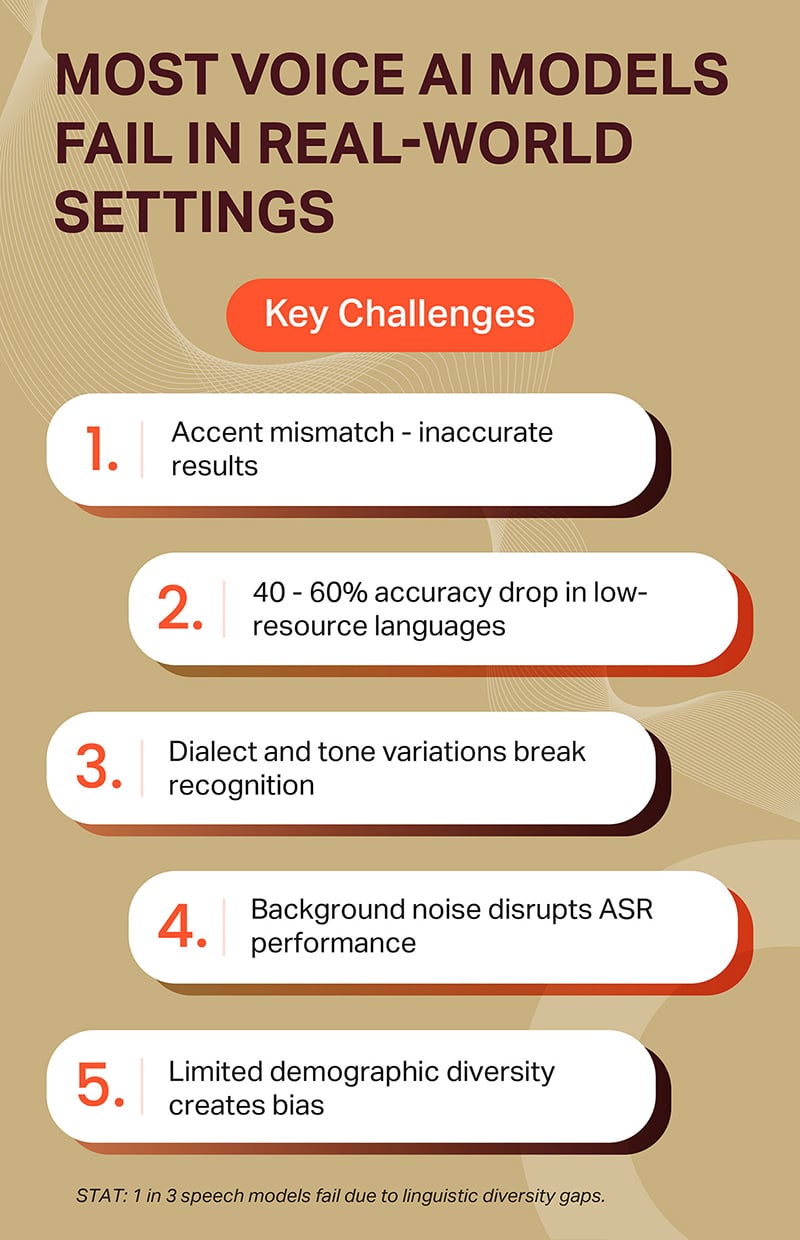
まず最初に問題となるのはアクセントの不一致です。主にアメリカ英語で学習させたモデルは、同じ単語でも母音が異なると、すぐに不正確な結果を出力します。
リソースの少ない言語ではさらに深刻な影響が出ます。訓練データが少ない言語をモデルが扱う場合、精度が40~60%低下するのが一般的です。
方言や声調の違いは、たとえ同一言語内であっても認識を困難にする。「英語」は単一の言語ではなく、アラビア語、スペイン語、中国語も同様である。
交通騒音、厨房の騒音、コールセンターの雑談といった背景雑音は、まさに音声インターフェースが最も役立つ環境において、自動音声認識(ASR)の性能を阻害する。
また、訓練データにおける人口統計学的多様性の不足はバイアスを生み出し、若い都市部の話者の発音はよく聞き取れる一方で、高齢者や地方の話者の発音は聞き取りにくいモデルを生み出す。
これらはどれもモデルの問題ではなく、すべてデータの問題だ。
AIは現実の状況下で現実の人々を理解する必要がある
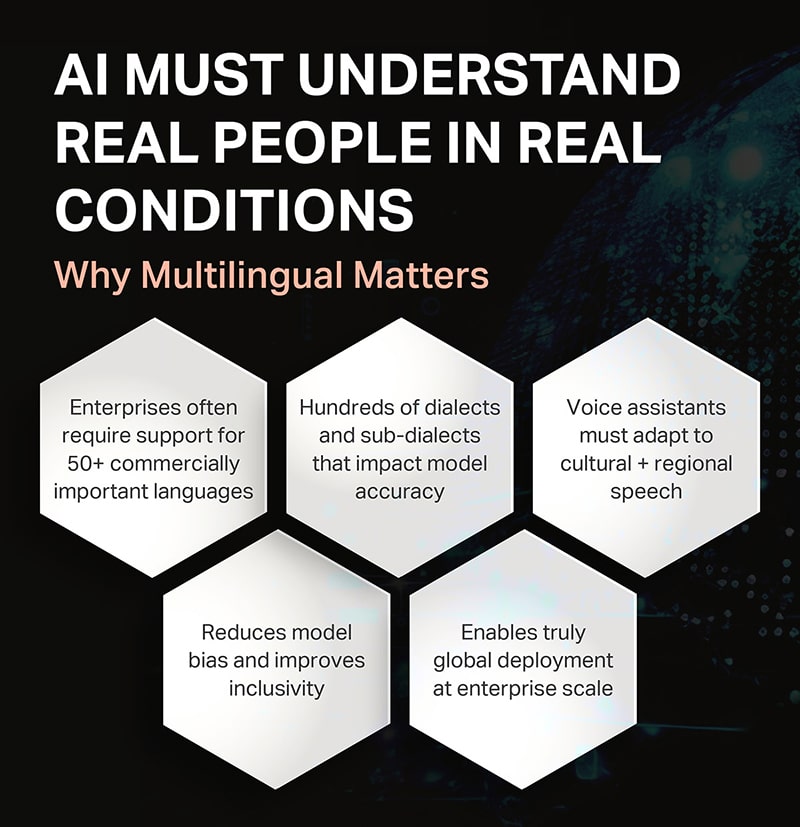
企業レベルで多言語データがそれほど重要な理由は?それは、問題の規模がほとんどのチームが想定しているよりもはるかに大きいからです。
企業では日常的に50以上の商業的に重要な言語への対応が求められており、それらの言語の下には数百もの方言や下位方言が存在し、これらがモデルの精度に直接影響を与えます。音声アシスタントは、語彙だけでなく、文化や地域特有の話し方、つまりペース、丁寧な表現、コードスイッチングにも適応する必要があります。これを正しく行うことで、モデルの偏りを減らし、包括性を向上させることができます。音声AIによって最も不利益を被るユーザーは、既に十分なサービスを受けられていない人々です。そして最終的に、多様な音声データこそが、企業規模での真のグローバル展開を可能にするのです。つまり、ムンバイ、メキシコシティ、マンチェスターなど、どこでも同じように機能する製品が実現するのです。
多言語音声データセットDNA:この強力なデータセットがカバーするもの
では、世界最高水準の音声データとは実際にはどのようなものなのでしょうか?6つの次元があり、これらはデータセットのDNAのようなものだと考えてください。
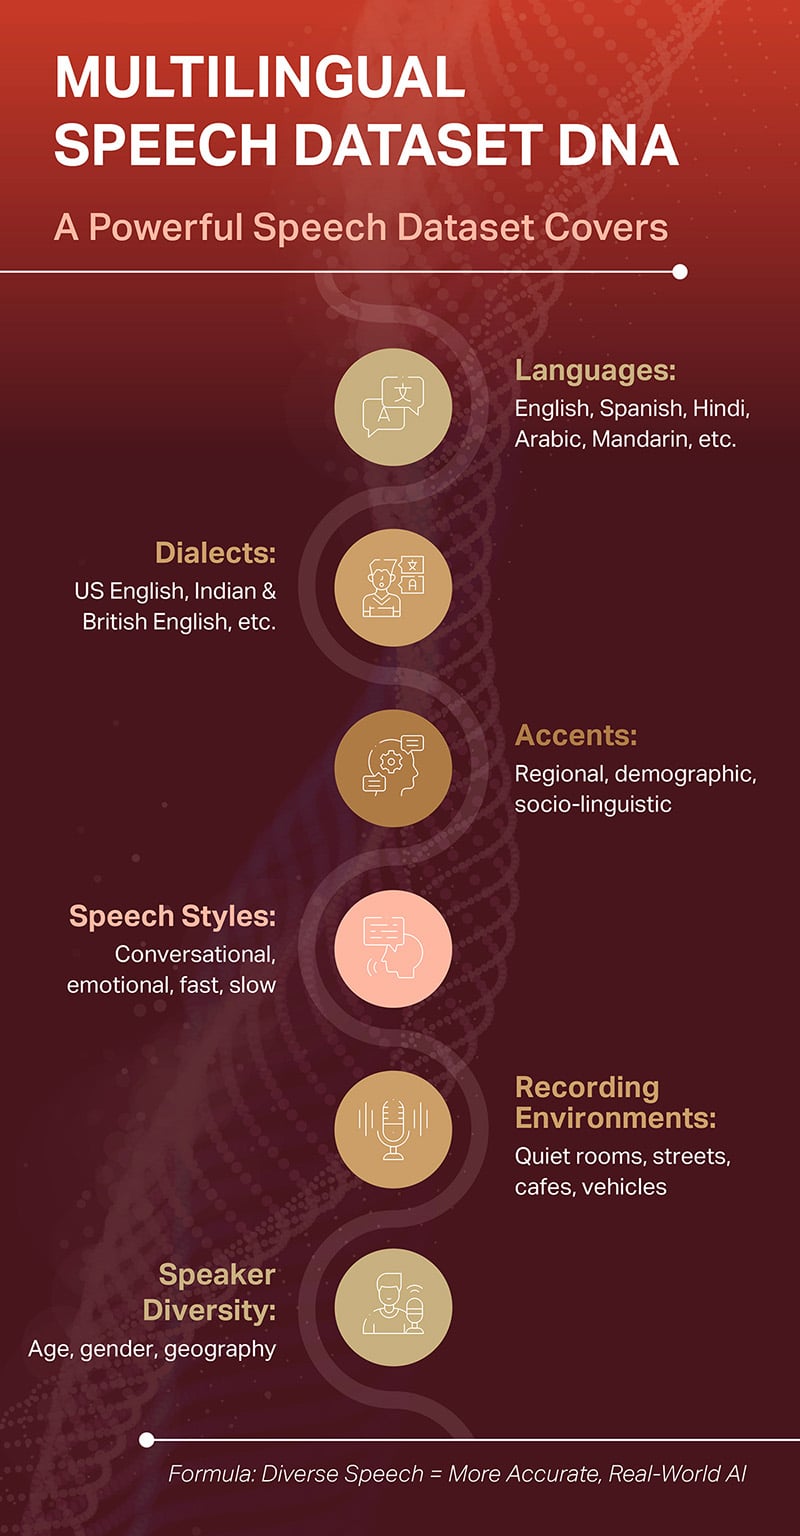
対応言語:英語、スペイン語、ヒンディー語、アラビア語、中国語(北京語)など、幅広い言語に対応しています。
方言:アメリカ英語、インド英語、イギリス英語のような明確な変種は、それぞれ異なる話し方のパターンとして扱われ、一括りに扱われるべきではない。
アクセント:各方言内における地域的、人口統計学的、社会言語学的差異。
話し方のスタイル:会話調、感情表現、速い話し方、遅い話し方――なぜなら、誰も音声アシスタントに台本を読むように話しかけるわけではないからだ。
録音環境:静かな部屋、街路、カフェ、車内など、現実生活における音響環境。
講演者の多様性:年齢、性別、地域に関わらず、バランスの取れた構成。
原理は単純明快だ。多様な音声認識=より正確で、現実世界に対応したAI。見落とした要素はすべて、製品の機能不全につながるユーザーセグメントとなる。
多言語音声AIがもたらすメリット:企業向け活用事例
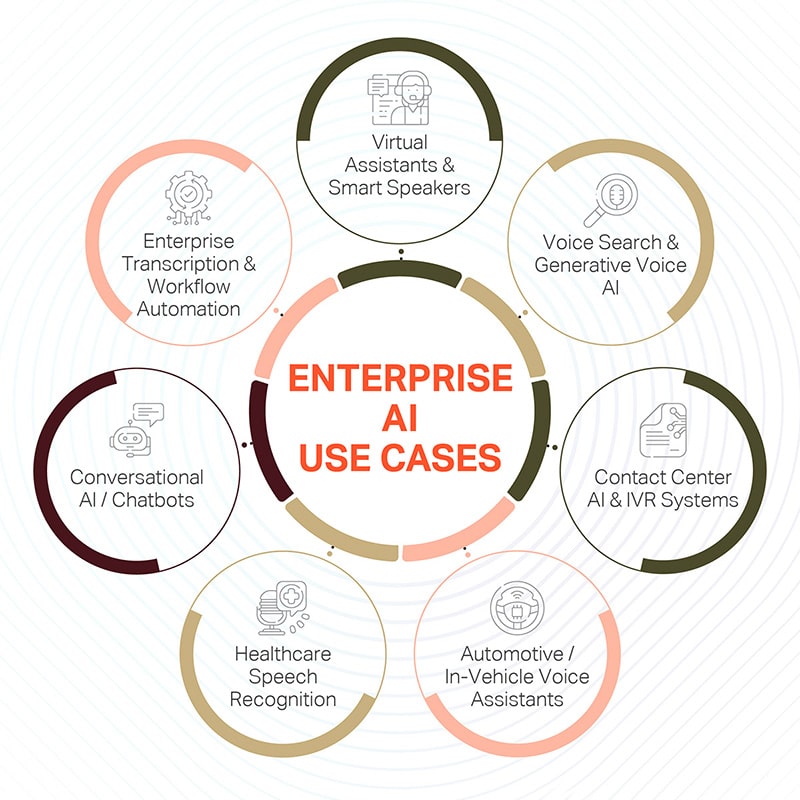
これらのアプリケーションは、人間が機械と会話するほぼすべての業界の接点に及んでいます。例えば、仮想アシスタントやスマートスピーカー、音声検索、企業向け文字起こしとワークフロー自動化、対話型AIとチャットボット、コンタクトセンターのAIとIVRシステム、精度が医療に直接影響する医療音声認識、そして騒音やアクセントが混在する厳しい環境下での車載音声アシスタントなどです。
これらのいずれの場合においても、ユーザーエクスペリエンスの限界はモデルそのものではなく、モデルが実際にどれだけの世界の言語を聞き取っているかにある。
Shaipが世界クラスの音声AIを実現する方法
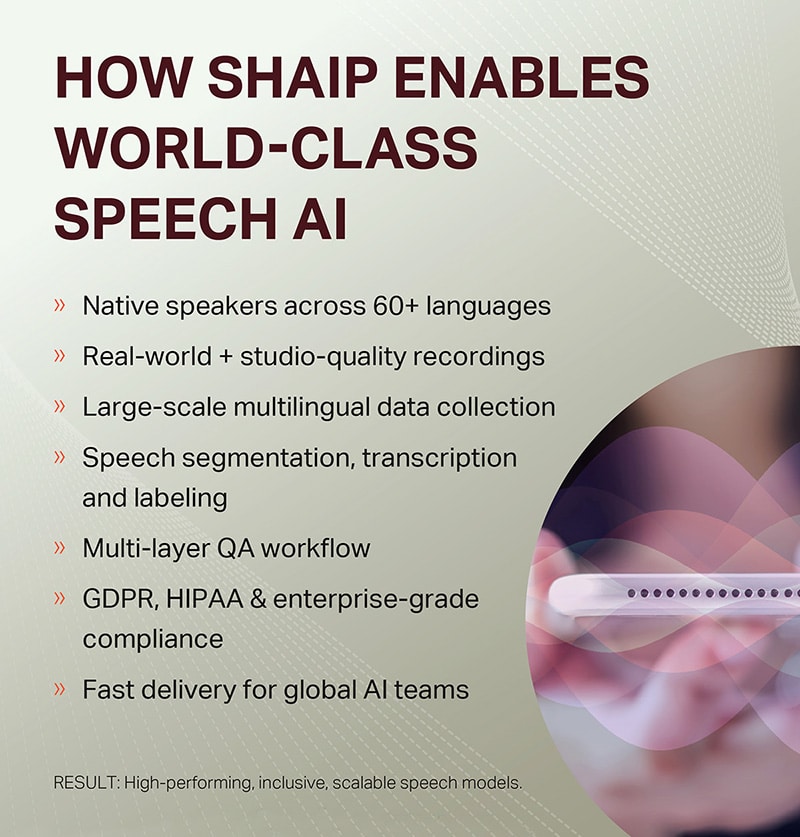
言語的多様性のギャップを埋めるには、単に音声データを収集するだけでは不十分です。綿密に計画され、品質管理されたデータ処理が必要です。そこでShaipの出番です。60以上の言語をネイティブスピーカーがカバーし、実環境とスタジオ品質の録音データ、大規模な多言語データ収集、音声のセグメンテーション、文字起こし、ラベル付け、多層的な品質保証ワークフロー、GDPR、HIPAA、およびエンタープライズグレードのコンプライアンス、そしてグローバルなAIチームへの迅速な納品を実現します。
その結果得られるトレーニングデータは、記録しやすいユーザーだけでなく、実際に製品がサービスを提供するユーザーを反映したものとなる。
ボトムライン
音声AIは目新しい段階からインフラへと移行しつつありますが、その最大の失敗は依然として一つの根本原因に起因しています。それは、現実世界を反映していないデータセットです。アクセント、方言、ノイズ、そして人口構成の多様性は、例外的なケースではなく、まさに導入環境そのものなのです。
世界を理解する音声AIを構築するには、失敗の起点となるデータから着手すべきだ。