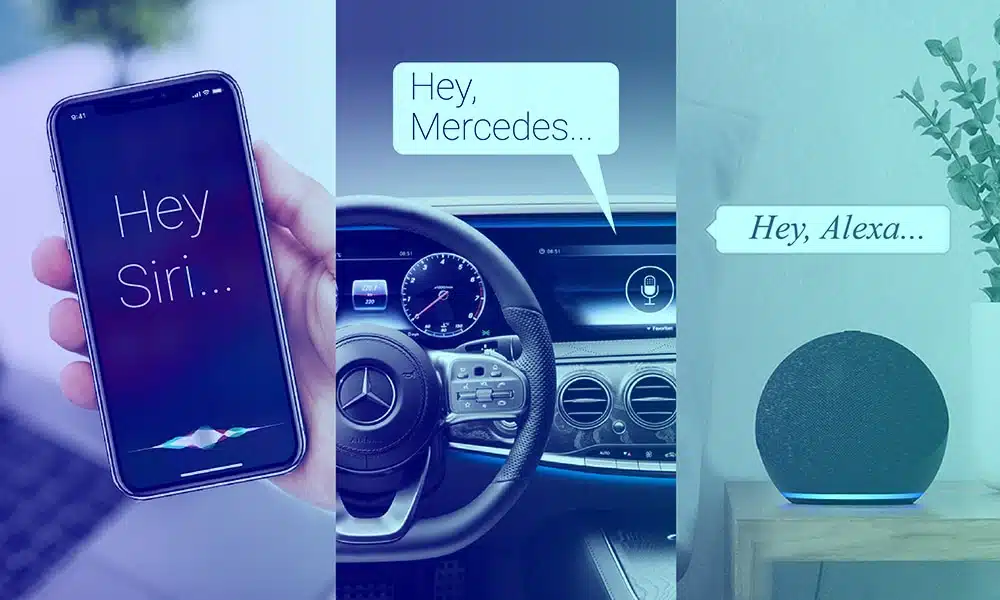
「Hey Siri」または「Alexa」と言うと、チャットボットや仮想アシスタントがどのように起動するのか疑問に思ったことはありませんか? これは、プログラムされたウェイク ワードを聞くとすぐにシステムを起動する、ソフトウェアに埋め込まれたテキスト発話コレクションまたはトリガー ワードによるものです。
ただし、音声と発話データを作成する全体的なプロセスはそれほど単純ではありません。 目的の結果を得るには、適切な技術を使用して実行する必要があるプロセスです。 したがって、このブログでは、会話型 AI とシームレスに連携する優れた発話/トリガー ワードを作成するためのルートを共有します。
AIにおける「発話」とは何でしょうか?
会話型AI(チャットボット、音声アシスタント)において、発話とはユーザー入力の短い部分、つまりユーザーが発話または入力した正確な言葉を指します。モデルは発話を用いて、ユーザーの意図(目標)とエンティティ(日付、商品名、数量などの詳細)を理解します。
簡単な例
Eコマースボット
発言:「注文番号123-456を追跡してください。」
- インテント: TrackOrder
- エンティティ: order_id = 123-456
テレコムボット
発言:「データプランをアップグレードしてください。」
- 意図: 変更計画
- エンティティ: plan_type = データ
銀行音声アシスタント
発話(口頭): 「今日の私の当座預金残高はいくらですか?」
- 意図: 残高確認
- エンティティ: account_type = 当座預金、日付 = 今日
会話型AIに優れた発話データが必要な理由
チャットボットや音声アシスタントが頼りなくなく、役に立つようにするには、まず発話データの質を高めることから始めましょう。13言語で22時間かけて行ったこの発話収集のケーススタディで、私たちがどのように実現したかをご覧ください。発話とは、人々が何かを成し遂げるために話したり入力したりする生のフレーズです(「明日の部屋を予約して」「予定を変更して」「状況はどうなっているの?」など)。発話は、意図の分類、エンティティの抽出、そして最終的には顧客体験の基盤となります。パートナーと連携してこれを拡張したい場合は、Shaipの会話型AIデータサービスが収集、文字起こし、注釈付けをエンドツーエンドで処理します。発話が多様で代表的で適切にラベル付けされている場合、モデルは意図間の適切な境界を学習し、現実世界の複雑な入力を落ち着いて処理します。
発話リポジトリの構築: シンプルなワークフロー
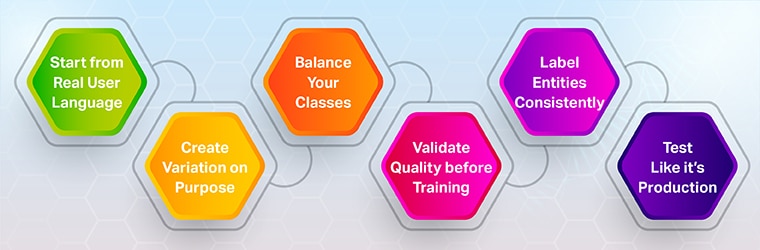
1. 実際のユーザーの言語から始める
チャットログ、検索クエリ、IVRのトランスクリプト、エージェントのメモ、顧客からのメールなどを収集します。それらをユーザーの目的ごとに分類し、意図の源泉とします。(そうすることで、会議室では思いつかないような口語表現やメンタルモデルを捉えることができます。)
2. 意図的にバリエーションを作る
それぞれの意図について、さまざまな例を作成します。
- 動詞と名詞を言い換えます(「キャンセル」、「停止」、「終了」、「計画」、「サブスクリプション」)。
- 文の長さと構造(疑問文、指示文、断片文)を混ぜ合わせます。
- 関連する場合は、タイプミス、略語、絵文字(チャット用)、コードスイッチングを含めます。
- 似ているが、 この意図にマップします。
3. クラスのバランスをとる
極端に偏った学習(例えば、あるインテントに500例、他のインテントに10例など)は予測精度を低下させます。インテントのサイズは比較的均等に保ち、トラフィックの状況に応じて徐々に増やしていくようにしてください。
4. トレーニング前に品質を検証する
作成/収集時にバリデーターを使用して低信号データをブロックする:
- 言語検出: 例がターゲット言語で書かれていることを確認します。
- 意味不明な単語の検出器: 無意味な文字列をキャッチします。
- 重複/ほぼ重複のチェック: 多様性を高く保ちます。
- 正規表現/スペルと文法: 必要に応じてスタイル ルールを適用します。
スマートバリデーター(Appen が使用)は、このゲートキーピングの大部分を自動化できます。
5. エンティティに一貫したラベルを付ける
スロットタイプ(日付、製品、住所など)を定義し、注釈者が境界をマークする方法を示します。LUISのPattern anyのようなパターンを使用すると、モデルを混乱させる長くて可変な範囲(文書名など)の曖昧さを解消できます。
6. 本番環境のようにテストする
未知の実際の音声データを予測エンドポイントまたはステージングボットに送信し、誤分類をレビューし、曖昧な例をトレーニングに組み込みます。収集→トレーニング→レビュー→拡張というループを作成します。
「混沌とした現実」の本当の意味(そして、それにどう対処するか)
実際のユーザーは完璧な文章で話すことは稀です。以下の点に注意してください。
- フラグメント: 「送料の返金」
- 複合目標: 「注文をキャンセルして青色で再注文」
- 暗黙のエンティティ: 「私のオフィスに発送してください」(どのオフィスか知っておく必要があります)
- あいまいさ: 「プランを変更する」(どのプランですか?いつから有効になりますか?)
実用的な修正
- 提供する 明確なプロンプト 必要なときだけ、過度な要求は避けてください。
- キャプチャ コンテキストの持ち越し (代名詞「その注文」「最後のもの」など)。
- フォールバックインテント ターゲットを絞った回復について:「計画のキャンセルや変更をお手伝いできます。どちらをご希望ですか?」
- モニター 意図的な健康 (混乱、衝突)そして弱いところにデータを追加する
音声アシスタントとウェイクワード:異なるデータ、類似のルール
既成データとカスタムデータをいつ(どのように)使用するか
- 既製品: 新しい地域での報道を迅速に開始し、混乱が残っている部分を測定します。
- カスタム額装: ドメイン言語 (ポリシー用語、製品名) と「ブランドの声」をキャプチャします。
- ブレンド: 広範囲から始めて、最も偏向または収益への影響が大きい意図について高精度のデータを追加します。
迅速な導入が必要な場合は、Shaipが多言語に対応した発話収集機能と既製の音声/チャットデータセットを提供します。多言語アシスタントの導入事例については、ケーススタディをご覧ください。
実装チェックリスト
- 例を使ってインテントとエンティティを定義し、 負 例
- 著者 多様でバランスの取れた 各意図の発話(最初は小さく、毎週大きくする)
- トレーニング前にバリデータ(言語、意味不明な文字列、重複、正規表現)を追加する
- セットアップ レビューループ 実際の交通から; 曖昧な項目をトレーニングに促進する
- トラック 意図的な健康 衝突; 新しい発話で修正
- チャネル/地域別に再評価して、早期に変化を捉える
Shaipがどのように役立つか
- カスタム発話収集とラベル付け (チャット + 音声) バリデーターを使用して、高い品質を維持します。
- すぐに使えるデータセット 迅速なブートストラップのために 150 以上の言語/バリエーションに対応しています。
- 進行中のレビュープログラム ライブ トラフィックを安全かつ確実に高信号トレーニング データに変換します (PII 制御)。