どのコンピュータビジョンチームも最終的には同じ壁にぶつかる。つまり、最も必要なデータが手に入らないということだ。交差点でのニアミス。1万個に1個しか発生しない欠陥。カメラで捉えるには危険すぎる、稀すぎる、あるいはプライベートすぎるシナリオ。
こうした場面で合成データが真価を発揮します。コンピュータで生成された画像やシーンは、現実世界のデータ収集ではカバーしきれないギャップを埋めてくれます。しかし、合成データはあくまでツールであり、近道ではありません。合成データを安易に利用するチームは、本番環境でその欠点に気づく傾向があります。ここでは、合成データが役立つ場面、裏目に出る場面、そして効果的な活用方法について、冷静に分析していきます。
必要に応じて合成データを使用する
合成データを利用することが常に正当化される状況が5つある。

稀なエッジケース。ニアミス、異常な物体相互作用、珍しいシナリオなど、安全性と堅牢性にとって最も重要なイベントは、実際のデータセットにはほとんど含まれていないものです。合成生成機能を使えば、たった2回しか見たことのないイベントの何千ものバリエーションを作り出すことができます。
制御されたカバレッジ。実写撮影では、偶然に捉えた照明、背景、遮蔽レベル、カメラアングルなどが得られます。合成パイプラインを使用すると、あらゆる太陽光の角度、あらゆる部分的な遮蔽、あらゆるレンズの高さなど、これらの変数を体系的に変化させることができるため、カバレッジは偶然ではなく、設計上の決定事項となります。
迅速な反復。本格的なデータ収集の前にモデルを初期段階で構築する場合、合成データを用いた最初のバージョンは数ヶ月ではなく数日で学習できます。データ収集予算を費やす前に、モデルがどのような課題を抱えているかを把握できます。
プライバシーとコンプライアンス上の制約。病院、学校、厳格なプライバシー規則のある職場など、実際の撮影が制限される機密性の高い環境では、合成シーンを使用することで、実際の顔や身元を一切使用せずにトレーニング信号を提供できます。
クラスバランスのサポート。一部のクラスが極端に過小評価されている場合、モデルの学習は不安定になり、少数派のクラスが無視されてしまいます。合成サンプルを用いることで、過小評価されているクラスの数を増やし、学習の安定性を回復させることができます。
注意すべき点:合成素材は、次のような場合に逆効果になる可能性がある
さて、正直に言うと、合成データは予測可能な形で失敗するが、注意深く観察すれば、それらの失敗はすべて回避できる。
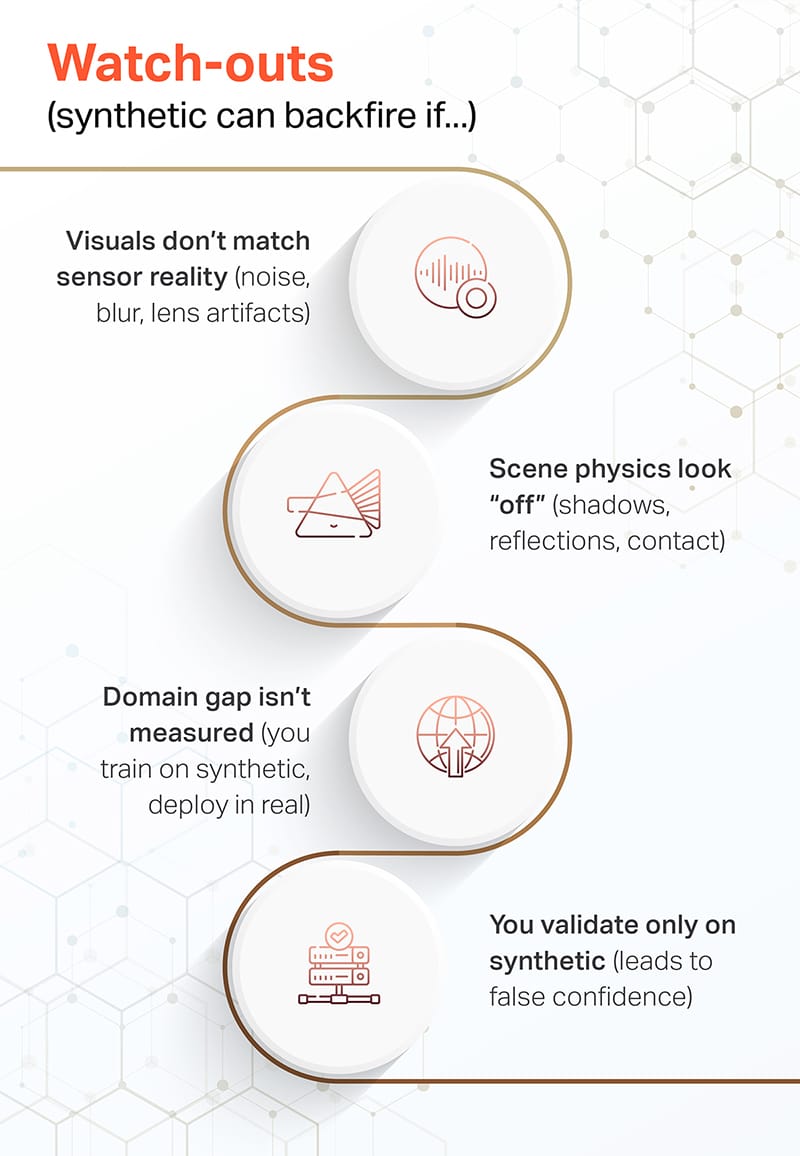
映像はセンサーの実際の画像と一致しません。配備されたカメラにはノイズ、ぼやけ、レンズのアーティファクトが存在します。合成画像がセンサーが生成する画像よりも鮮明であれば、モデルは存在しない世界を学習することになります。
シーンの物理法則が「おかしい」ように見える。影の落ち方が間違っていたり、反射が不自然だったり、物体が表面にきちんと接触していなかったりする。人間はこうした現象を気にしないが、モデルはそれらを現実の姿として受け入れてしまう。
ドメインギャップは測定されていません。典型的な失敗例:合成データで学習させ、実データに展開し、両者の違いを定量化しない。ドメインギャップを測定しなければ、推測に頼るしかない。
合成データのみで検証を行うのは最も危険な方法です。なぜなら、合成テストセットでは優れたスコアを出すモデルが、実際の入力データでは破綻するという誤った自信を生み出すからです。合成データによる検証では、モデルが学習したのはシミュレーターであって、実際の環境ではないことが分かります。
ベストプラクティスアプローチ
合成データを活用して成功を収めるチームは、同じ5つのステップからなるループに従っている。
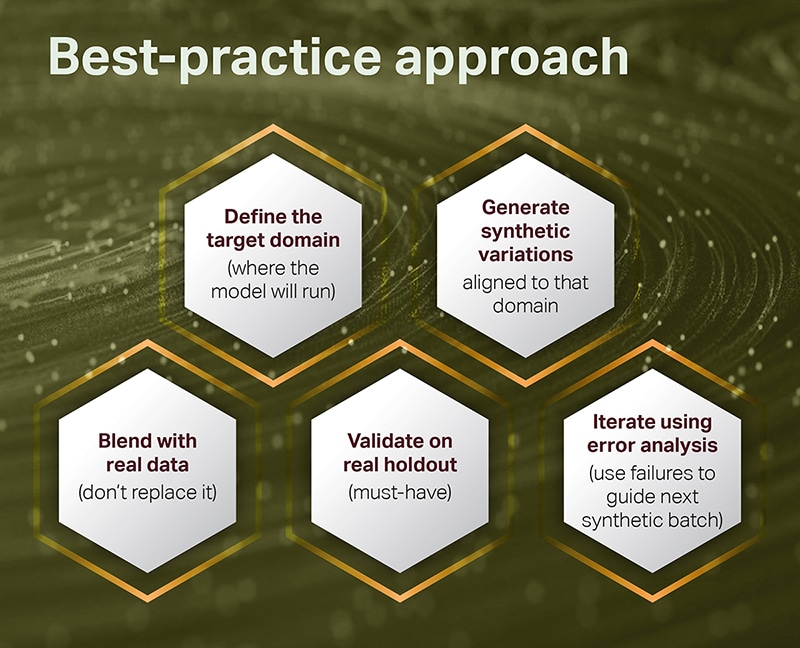
まず、ターゲットドメインを定義します。これは、センサー、環境、照明に至るまで、モデルが実際に実行される条件です。次に、そのドメインに合わせた合成バリエーションを生成します。これは、一般的な見栄えの良いレンダリングではありません。3つ目は、実データとブレンドすることです。合成データは実データキャプチャを補完するものであり、置き換えるものではありません。4つ目は、実際のホールドアウトセットで検証することです。これは必須事項です。ベンチマークは、モデルがこれまで見たことのない実データでなければなりません。そして5つ目は、エラー分析を使用して反復することです。モデルの実世界での失敗に基づいて、次の合成バッチに何を含めるべきかを判断します。
定義→生成→ブレンド→実測→反復。個々のステップよりも、このループ全体が重要である。
合成データを使うべきか?迅速な意思決定のためのフレームワーク
4つの質問でほとんどの議論は決着する。
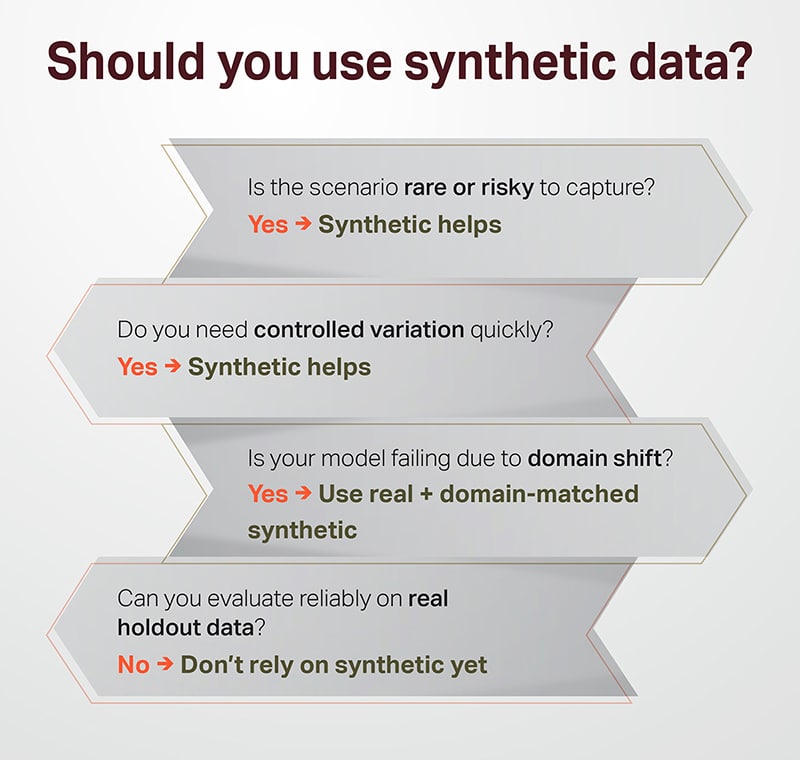
そのシナリオは稀なケースですか、それとも捉えるのが難しいですか?もしそうなら、合成データが役立ちます。制御された変動を迅速に必要としますか?もしそうなら、合成データが役立ちます。モデルがドメインシフトによって失敗していますか?もしそうなら、実データとドメインにマッチした合成データを使用してください。合成データだけでは、認識できないギャップを埋めることはできません。最後に、実際のホールドアウトデータで確実に評価できますか?もしできない場合は、まだ合成データに頼らないでください。まず実評価セットを構築してください。実評価セットがないと、合成データが役に立っているのか、それともひっそりと悪影響を与えているのか判断できないからです。
ボトムライン
合成データは、コンピュータビジョンツールキットの中で最も強力なツールの1つであり、エッジケースの検出、カバレッジ、速度、プライバシー、バランスといった点で非常に有用です。しかし同時に、誤用されやすいツールでもあります。なぜなら、その不具合は、導入当日まで見栄えの良い指標の陰に隠れてしまうからです。
成功しているチームは、これを工学的な規律として捉えています。つまり、実データを基盤とし、合成データを的を絞った補強として用い、実世界での検証を絶対的な審判として位置づけているのです。シャイプ氏がコンピュータビジョンチームで採用しているアプローチもまさにこれです。実データと合成データの適切な組み合わせを計画し、測定可能な品質保証と展開に焦点を当てた検証を行うことで、トレーニングで機能するモデルが実環境でも機能するようにしているのです。