データに基づく意思決定は、今日の企業の成功と卓越性の秘訣です。フィンテック、製造業、小売業、サプライ チェーンなど、あらゆる業界がビッグ データの波に乗り、高度な分析モデルとアルゴリズムを使用して統計に基づく意思決定を行っています。ヘルスケア分野では、これがさらに価値を高め、命を救うことになり、イノベーションと科学の進歩の基盤として機能します。
これほど大きな可能性を秘めている一方で、課題も山積している。医療データに対する需要が多様な目的で急増するにつれ、データ漏洩や機密情報の悪用といったリスクも高まっている。2023年の報告書によると、1億3300万件以上の医療記録やデータが盗まれ、医療分野におけるデータ漏洩件数の新記録を樹立した。
HIPAA規制の成立は、医療データのプライバシー保護を最適化する上で心強い動きであり、データ漏洩を単独で48%も大幅に削減した。また、報告によると、データ漏洩全体の61%は、この分野の従業員や専門家の過失によるものであることが明らかになっている。
こうした攻撃や脆弱性の大量暴露をさらに抑制するために、合成患者データが登場しました。「現代の問題には現代的な解決策が必要だ」と言われるように、合成データ医療の登場により、医療従事者は患者データを強化し、AIモデルを活用して新たなデータを生成することが可能になります。
この記事では、合成データ生成とは何か、そしてその無数の側面について深く掘り下げていきます。
合成患者データとは?
合成とは、既存の要素を組み合わせて新しいものを作成するプロセスです。同様に、合成患者データとは、既存の実際の患者データから人工的に生成されたデータを指します。
このプロセスでは、統計モデルとアルゴリズムが大量の患者データを調査し、パターンと特性を観察し、実際のデータをエミュレートするデータセットを生成します。人工患者データを生成する際に使用される一般的な手法には、次のものがあります。
- 生成的敵対ネットワーク (GNN)
- 統計モデル
- データの匿名化方法など
合成データは、再識別可能な患者情報が漏洩する可能性に関するプライバシーの懸念を払拭する優れた完璧な手法です。このようなデータの利点を理解するために、最も顕著な使用例をいくつか見てみましょう。
合成データの使用例
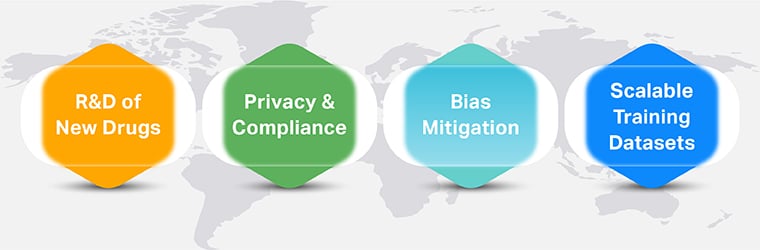
新薬・医薬品の研究開発
臨床試験データの生成は秘密裏に行われ、組織は重要な情報を隠蔽することがよくあります。しかし、研究開発においては、データの相互運用性が画期的な成果を生み出す鍵となります。合成データを生成することで、研究者は追跡可能な重要な情報を隠蔽し、データのサイロ化を解消して、薬物反応や副作用、製剤、相関関係、結果などを共同で研究することが可能になります。
プライバシーと規制遵守
集中型クラウドベースの EHR システムの必要性について議論が交わされている一方で、プライバシーと安全性に関する規制上の課題もあります。データの相互運用性は避けられませんが、医療分野全体の関係者は患者データの共有について細心の注意を払う必要があります。合成データは、重要なタッチポイントを維持しながら機密事項を隠し、理想的な代表データセットとして機能します。
医療における偏見の緩和
医療では、偏見の導入は本質的かつ不可避です。たとえば、ある地域で 35 歳から 50 歳の男性に影響を及ぼす伝染病が発生した場合、この特定のペルソナに対してはデフォルトで偏見が導入されます。女性と子供は依然としてこの流行の影響を受けやすいため、研究者は調査結果を実証するための客観的な根拠を必要とします。合成データは、偏見を排除し、バランスの取れた表現を提供するのに役立ちます。
スケーラブルなヘルスケアトレーニングデータセット
GDPR、HIPAA などの規制により、高度な医療ネイティブ機械学習モデルをトレーニングするためのデータセットの可用性は依然として不十分です。人工知能 (AI) システムと機械学習モデルでは、正確な結果を一貫して提供するために、膨大な量のトレーニング データが必要です。
合成データ生成はこの分野において非常に有益であり、組織が自社のデータ量、仕様、成果に合わせて人工データを生成できるだけでなく、倫理的な合成データ利用を促進することも可能にする。
合成ヘルスケアデータの欠点と落とし穴
既存のデータセットから患者や医療データを人工的に生成するシステムやモジュールが存在するという事実は安心できます。しかし、この技術にも欠点がないわけではありません。その欠点を理解しましょう。