
組織では毎日、膨大な量のテキストデータが生成されます。サポートチケット、契約書、診療記録、顧客レビュー、メール、通話記録など。企業データの約80%は、このような非構造化テキストとして存在しており、つい最近まで、そのほとんどは大規模に分析することができませんでした。データはただそこに眠っていたのです。
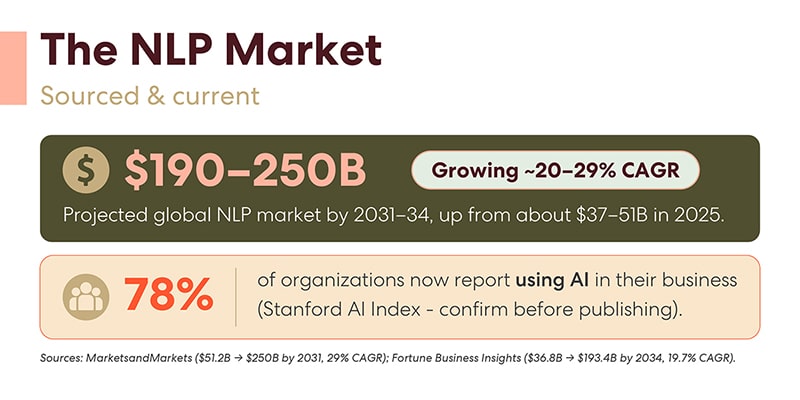
自然言語処理(NLP)は状況を変えました。そして2026年には、大規模な言語モデルが処理の大部分を担うようになり、NLPはニッチな研究分野から、私たちが触れるほぼすべてのAI製品の基盤となるエンジンへと進化しました。市場もそれを反映しており、アナリストはNLP市場が2025年の約37億~51億ドルから2030年代初頭には190億~250億ドルに成長すると予測しています。また、すでに78%の組織がビジネスにAIを活用していると報告しています。
では、今日のNLPとは一体何なのか、実際にどのように機能するのか、そして今後どのような方向へ向かうのか?詳しく見ていきましょう。
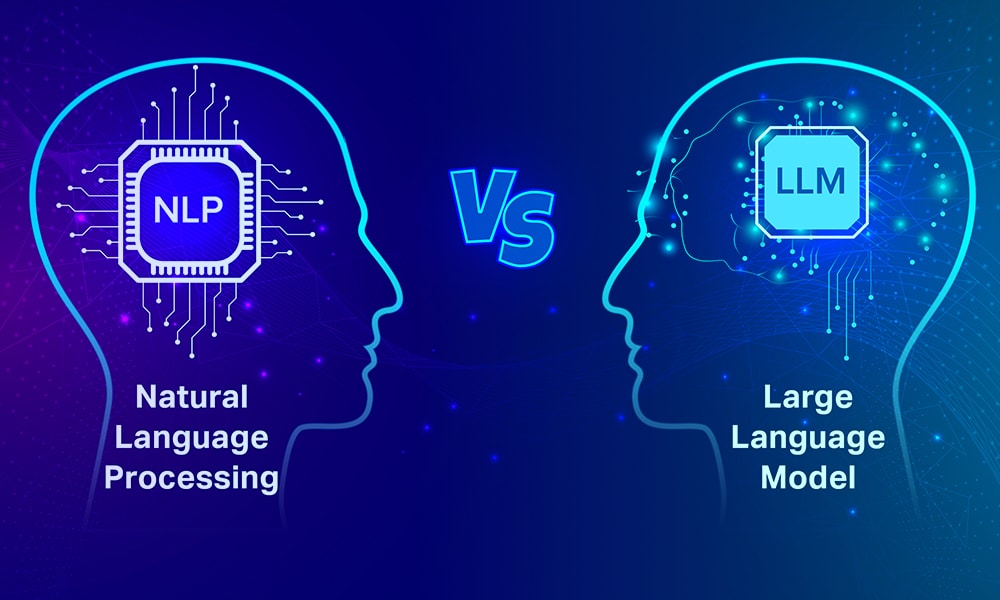
まず、最大の誤解を解消しましょう。NLPとLLMの違いです。
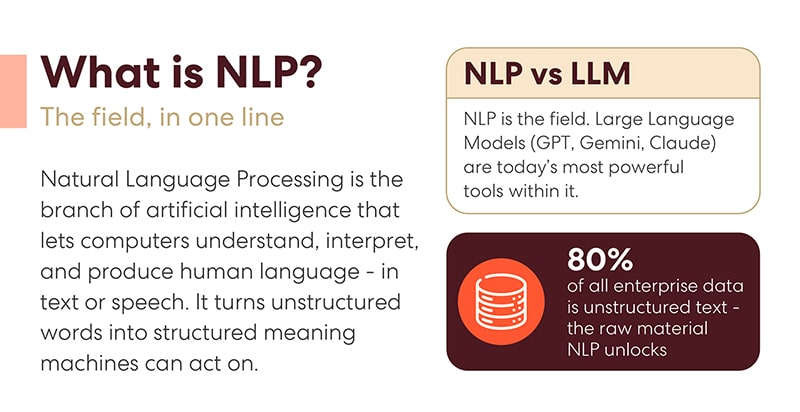
10人にNLPとLLMの違いを尋ねれば、10人とも曖昧な答えが返ってくるでしょう。では、明確に説明しましょう。NLPとは、機械が人間の言語を理解、解釈、生成することを扱うAI分野全体のことです。GPT、Gemini、Claudeといった大規模言語モデルは、その分野におけるツールです。これらはNLPが生み出した最も強力なツールであるため、この2つの用語が混同されがちです。
医学とMRI装置の関係を考えてみてください。MRIは医学を変革しましたが、医学そのものがMRIだと言う人はいません。それと同じ関係です。すべてのLLMはNLPシステムであり、NLPは単一のモデルよりもはるかに大きなものです。
この区別は実務上も重要です。サポートチケットのルーティング、契約条項の特定、レビューにおける感情分析など、多くのビジネス上の問題は最先端のLLMを必要としません。必要なのは適切なNLPアプローチであり、多くの場合、より小規模で、安価で、迅速な処理が可能です。
現代の自然言語処理は実際にはどのように機能するのか
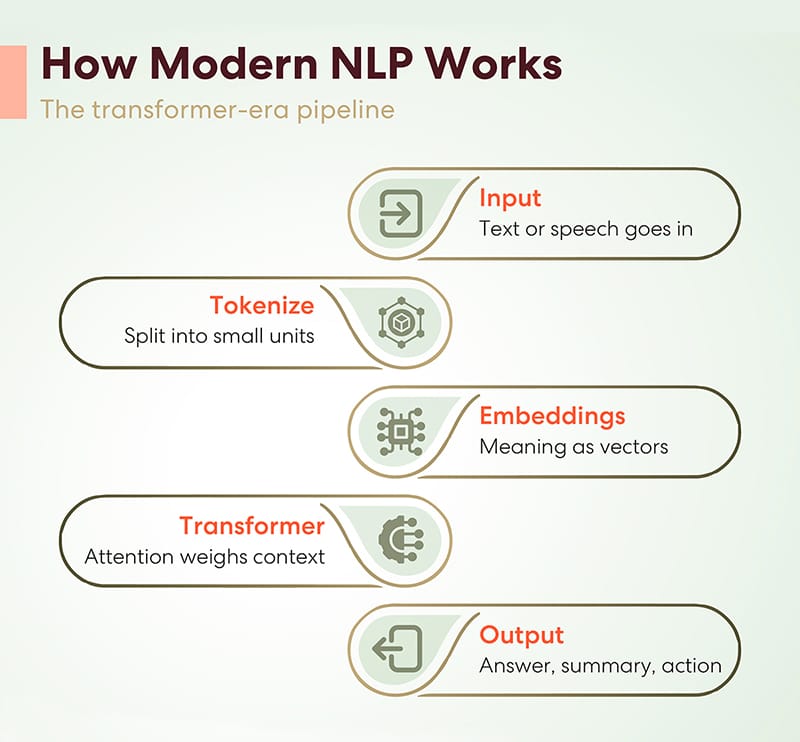
誇張表現を取り除けば、現代の自然言語処理システムのほぼすべてが、同じ5段階のパイプラインに基づいて動作している。
テキストまたは音声が入力されると、システムはそれをトークン化し、モデルが処理できる小さな単位に言語を分割します。これらのトークンは埋め込み、つまり意味を符号化する数値ベクトルとなり、「physician」と「doctor」が数学空間で近い位置に配置されます。次に、すべてを変える部分、トランスフォーマーが登場します。このトランスフォーマーのアテンションメカニズムは、すべてのトークンを他のすべてのトークンと比較し、文脈の中で実際に何が重要なのかを判断します。「銀行が融資を承認した」という文で、川の話をしているのではないことモデルがわかるのは、この仕組みのおかげです。最後に、モデルは出力、つまり回答、要約、翻訳、アクションを生成します。
以上です。入力 → トークン化 → 埋め込み → 応答 → 出力。わずか10年足らず前に導入されたトランスフォーマーアーキテクチャは、現在、実稼働中のほぼすべての言語AIシステムの基盤となっています。「LLM時代」という言葉が使われるとき、実際には大規模なトランスフォーマー時代を指しているのです。
自然言語処理で何ができるのか、そして仕事内容はどのように変化したのか
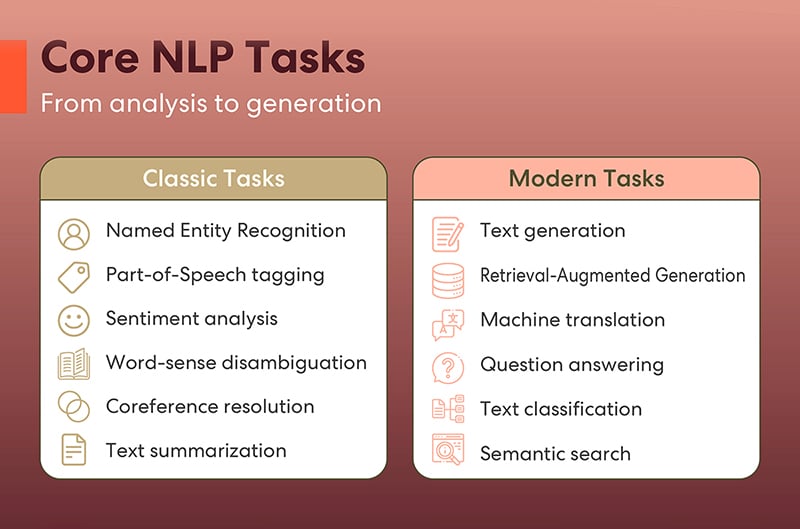
NLPのタスクリストは、この分野の進化の歴史を物語っている。
従来のタスクは分析に関するものでした。テキストから名前、会社名、日付を抽出する(固有表現認識)、品詞をタグ付けする、感情を検出する、文脈に応じて単語のどの意味が適用されるかを判断する(語義曖昧性解消)、どの「it」が何を指しているかを特定する(共参照解決)、長い文書を要約にまとめる、といったものです。これらは今でも重要な役割を担っており、コンプライアンスシステム、検索エンジン、文書処理パイプラインなど、あらゆる場所で静かにその機能を支えています。
しかし、現代ではそこに生成機能が加わりました。今日のシステムは言語を読み取るだけでなく、生成も行います。テキストの作成、質問への回答、言語間の翻訳、大規模な文書分類、キーワードではなく意図に合致するセマンティック検索の実行、そして検索強化型生成などです。後者については、注目を集めているため、後ほど詳しく説明します。
分析から生成への移行は、自然言語処理の歴史において最大の変化である。機械はエッセイの採点から、エッセイの作成へと移行したのだ。
現在NLPを推進している7つのアイデア
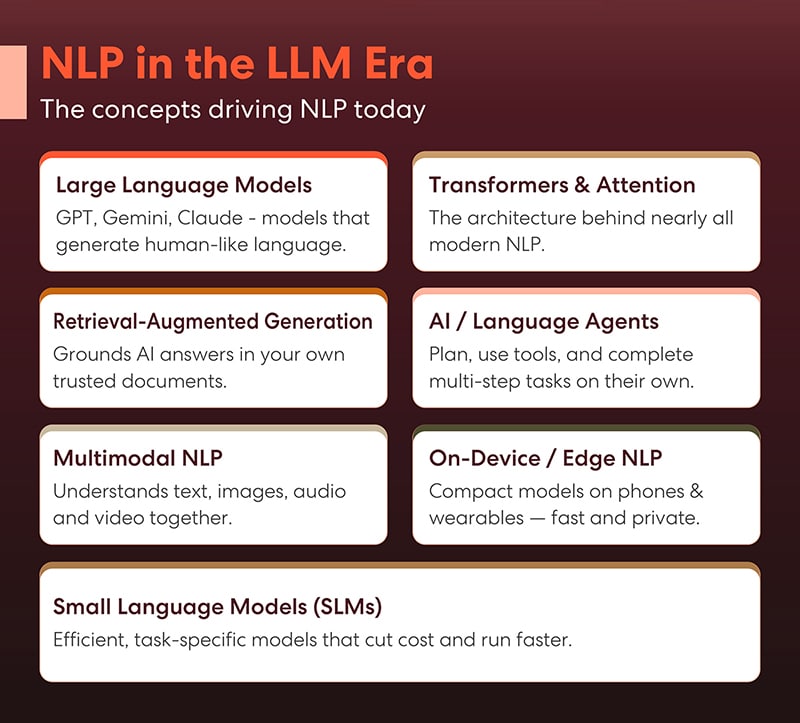
現在の状況を定義する7つの概念があり、それらを理解することで、2026年にAIベンダーが行うあらゆるプレゼンテーションを分析するのに役立つだろう。
大規模言語モデル(LLM)こそが主役だ。GPT、Gemini、Claudeといったモデルは、数年前には不可能と思われたほど流暢な、人間のような言語を生成する。これらのモデルのおかげで、自然言語処理はバックオフィス業務から役員会議での会話へと発展したのだ。
トランスフォーマーとアテンション機構は、その基盤となる仕組みです。最先端のLLMからスマートフォンのオートコンプリート機能まで、現代のほぼすべての自然言語処理システムは、このアーキテクチャに基づいて構築されており、モデルが文書全体にわたる文脈を一度に考慮できるようになっています。
検索拡張型生成(RAG)は、7つの手法の中で企業に最も好まれている。なぜなら、AIの回答を自社の信頼できる文書に基づいて構築できるからだ。モデルの記憶に頼るのではなく、検証済みの知識ベースを参照させることで、誤った回答が大幅に減少する。
AIと言語エージェントは、質問への回答から作業の完了まで、モデルを進化させていきます。つまり、手順の計画、ツールの呼び出し、最小限の監視による複数ステップのタスクの実行までを担います。2024年がチャットボットの年だったとすれば、2026年はエージェントの年になりそうです。
マルチモーダル自然言語処理は、テキストとそれ以外の要素との境界をなくします。最新のシステムは、テキスト、画像、音声、動画をまとめて処理し、グラフの読み取り、通話内容の聴取、そしてそれらの要約を一度に行います。
オンデバイス/エッジNLPは、コンパクトなモデルをスマートフォンやウェアラブル端末に搭載し、そこで推論処理をローカルで行います。そのメリットは、処理速度とプライバシー保護です。データはデバイスから外部に持ち出されることはありません。
小型言語モデル(SLM)は、「大きいほど良い」というトレンドとは逆行するものであり、最先端の言語モデル(LLM)の数分の1のコストで済み、かつ高速に動作する、効率的でタスクに特化したモデルです。明確に定義されたタスクにおいては、多くの場合、より賢明な選択肢となります。
NLPがその真価を発揮する場所
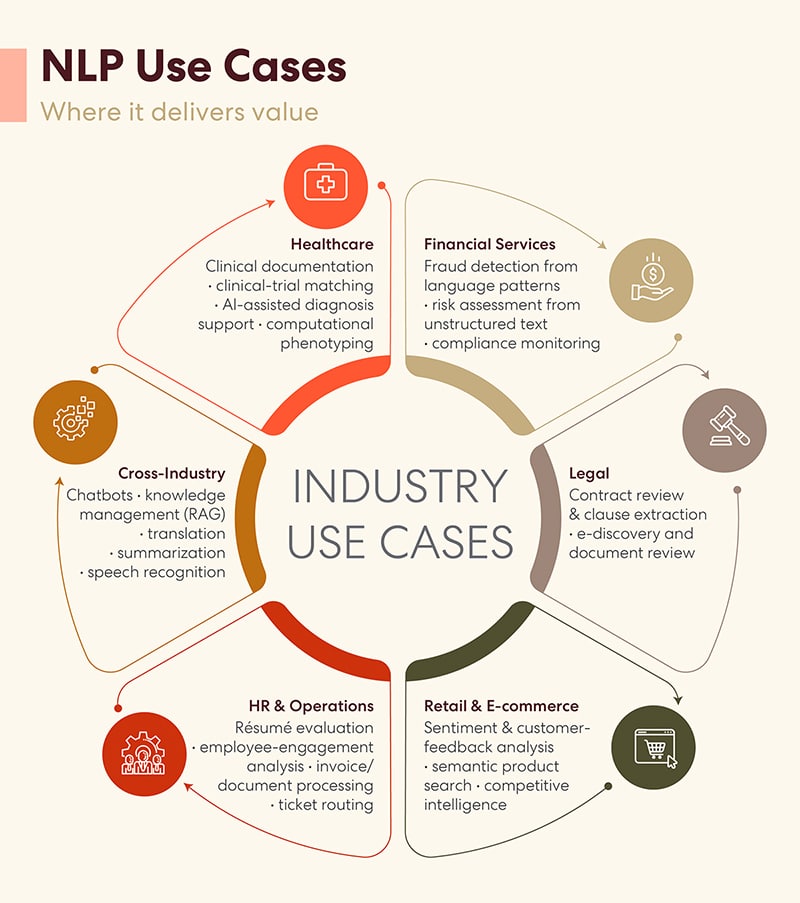
これらのユースケースはもはや憶測の域を超え、あらゆる業界の予算項目に計上されている。
医療分野では、自然言語処理(NLP)が臨床文書の作成(医師の週あたりの作業時間を大幅に削減)、患者と臨床試験のマッチング、そして人間が大規模に読み解くことは不可能なメモの分析による診断支援に役立っています。金融サービス分野では、言語パターンによる不正行為の検出や、コンプライアンス遵守のためのコミュニケーション監視に活用されています。かつては膨大な数のレビュー担当者が必要だった業務です。法務チームは、契約書のレビュー、条項の抽出、電子情報開示にNLPを使用し、数週間かかっていた文書レビューを数日に短縮しています。小売業では、顧客からのフィードバックを分析して感情を抽出し、キーワードだけでなく意図を理解するセマンティック検索を実現しています。人事・業務チームは、履歴書の選考、エンゲージメント分析、請求書処理、チケットのルーティングなどにNLPを活用しています。
そして、あらゆる業界に共通する技術として、チャットボット、RAG(ランダムアクセスグループ)によるナレッジマネジメント、翻訳、要約、音声認識などが挙げられます。共通点は常に同じで、これまで利用できなかったテキストが、活用可能なデータへと生まれ変わるということです。
正直な事実:メリットと、それでもなお問題となる点
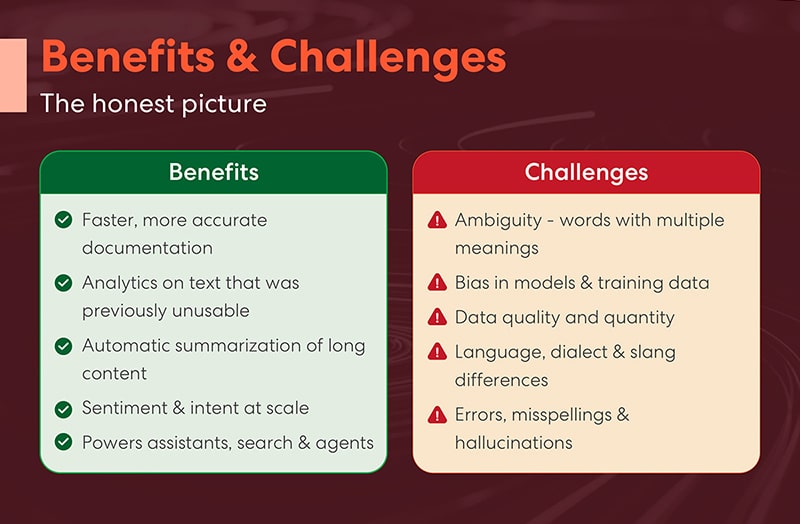
これらすべてがもたらすメリットは明白です。ドキュメントはより迅速かつ正確に作成され、これまで利用できなかったテキストは分析可能なデータになります。長文コンテンツは自動的に要約され、数百万件ものやり取りを通して感情や意図を大規模に読み取ることができます。さらに、このシステム全体が、チームが既に利用しているアシスタント、検索エンジン、エージェントの基盤となります。
しかし、そこでツアーを終えるのは不誠実だろう。なぜなら、2026年のNLPには依然として深刻な問題が残っているからだ。
言語は曖昧で、単語には複数の意味があり、モデルは人間なら理解できるような文脈でつまずくことがあります。モデルは学習データからバイアスを受け継ぎ、採用ツール、信用判断、コンテンツモデレーションなどに密かに悪影響を及ぼす可能性があります。データ品質は依然として地味なボトルネックです。モデルの性能は学習データに依存しますが、高品質で適切に注釈が付けられた学習データは希少で高価です。方言、スラング、リソースの少ない言語は、標準英語よりも性能が劣ります。そして、自信満々で流暢だが誤った出力という誤認識は、企業での導入を慎重にさせる最大の障害となっています。
これらはどれも、参加を見送る理由にはなりません。むしろ、慎重に展開すべき理由です。検証済みのデータに基づいてモデルを構築し、自社の言語とユーザーで評価し、エラーによる損失が大きい箇所では人間が関与し続ける必要があります。特に、これらの課題のほとんどは、モデルの学習と評価に使用されるデータという同じ根本原因に起因しています。だからこそ、データ品質は単なるチェック項目ではなく、競争上の差別化要因となっているのです。
今後の展望:2026年まで注目すべき5つのトレンド
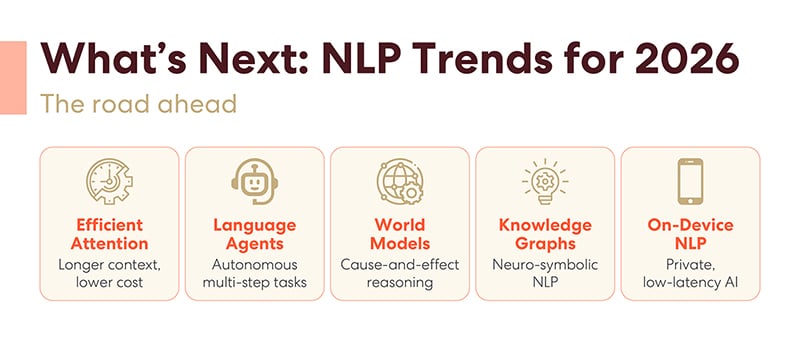
今後、この分野の次の段階を決定づける5つの進展が見込まれます。効率的なアテンションメカニズムは、コンテキストウィンドウを拡張しつつコストを削減し、モデルがコードベース全体やケースファイル全体を一度に推論できるようにします。言語エージェントはデモから実運用へと移行し、複数ステップのワークフローを自律的に処理します。ワールドモデルは、パターンマッチングではなく、AIに真の因果推論能力を与えることを目指しています。知識グラフはニューラルアプローチ(ニューロシンボリックNLP)と融合し、モデルの出力をより事実に基づいた、監査可能なものにします。そして、デバイス上でのNLPは、高性能モデルを小型化し続け、最終的にはプライベートで低遅延のAIがポケットに収まるようになるでしょう。
5つの製品すべてに共通するパターンは、力任せではなく、より精密な設計である。より安価で、より速く、より地に足の着いた、よりユーザーに近い製品となっている。
ボトムライン
2026年における自然言語処理(NLP)は、もはや新興技術ではなく、データベースと同様に、当たり前で不可欠なインフラとなるだろう。NLPの導入を先取りする組織は、NLPを使うべきかどうかを問うのではなく、どのタスクを最初に自動化すべきか、自社のデータに基づいてモデルを構築するにはどうすればよいか、そして、その基盤となるトレーニングデータが学習に値するものであることをどのように保証するかを問う組織となる。