最後に医師の診察を受けた時のことを思い出してみてください。あらゆる診断、処方、推奨事項の背後には、あなたのバイタルサイン、検査結果、病歴といったデータがあります。それを何百万人もの患者に当てはめて考えてみてください。この膨大な情報こそが、医療分野におけるAIの原動力なのです。
しかし、真実はこうです。AIモデルは、病気を検出したり治療法を推奨したりする方法を自動的に知るわけではありません。医学生のように、症例研究や患者回診、教科書から学ぶのと同じように、データから学習するのです。AIにおけるこの学習は、私たちが「医療トレーニングデータ」と呼ぶものから得られます。
データが高品質で多様性があり、正確であれば、AIシステムはより賢くなり、信頼性が高まります。データが不完全であったり、偏っていたり、ラベル付けが不十分だったりすると、AIはミスを犯します。医療においては、そのミスは文字通り命を奪う可能性があります。
ヘルスケアトレーニングデータとは何ですか?
簡単に言えば、ヘルスケアトレーニングデータとは、AIや機械学習モデルに学習させるために使用される医療情報のことです。これには、血圧値や服薬リストなどの構造化されたフィールドから、手書きの医師のメモ、放射線スキャン、さらには医師と患者の会話の音声録音などの非構造化コンテンツまで、あらゆるものが含まれます。
なぜそれが重要なのか?それは、AIがこのデータ内のパターンを識別することで学習するからです。例えば:
- AI に何千枚もの注釈付き胸部 X 線写真を入力すれば、肺炎を見つける方法を学習できます。
- 医師の口述記録を学習させることで、正確な臨床記録を生成できます。
ヘルスケアのトレーニングデータは基盤です。それがなければ、AIは教科書のない学生のようなものです。学ぶべきものがないのです。
ヘルスケアトレーニングデータの種類
ヘルスケアは複雑であり、データも同様です。分かりやすいカテゴリーに分けて考えてみましょう。
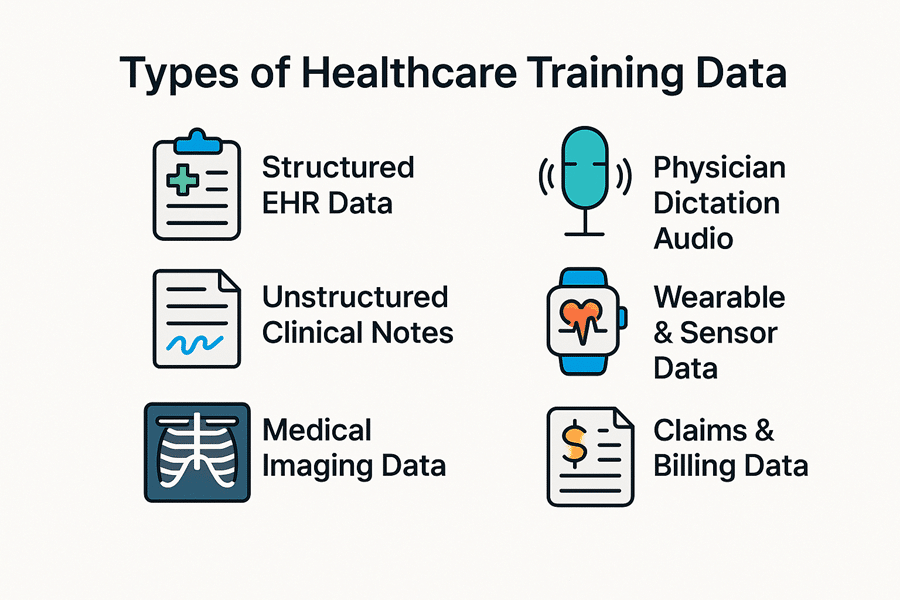
- 構造化されたEHRデータ: これは患者の人口統計情報、診断コード、検査結果などが整理された部分です。医療データの「スプレッドシート」版と考えてください。
- 非構造化臨床ノート医師の自由記述メモ、退院サマリー、症状の説明など。これらは文脈が豊富ですが、機械が処理するのは困難です。
- 医療画像データX線、CTスキャン、MRI、病理スライドなど。注釈付き画像は、AIが放射線科医のように「見る」ことを学習するのに役立ちます。
- 医師のディクテーションオーディオ医師はしばしば口述筆記を行います。これらの音声ファイルと書き起こしを使ってAIをトレーニングすることで、医療音声を理解し、書き起こす能力を身につけることができます。
- ウェアラブルとセンサーデータFitbitや血糖値モニターなどのデバイスは、健康指標を常に記録します。このリアルタイムデータは、予測的な健康モニタリングに役立ちます。
- 請求および請求データ保険金請求や請求コードは面白みがないかもしれませんが、ワークフローを自動化し、不正行為を検出するために不可欠です。
これらを組み合わせることで、マルチモーダル医療データセットが得られます。これは、単一のデータタイプよりもはるかに強力な、患者の全体像を把握できるものです。
AIモデル開発においてヘルスケアトレーニングデータが重要な理由
- モデル学習AI モデルでは、病気を認識し、スキャンを解釈し、医師のメモを書き写し、治療法を推奨するために、コンテキストに応じたラベル付きのデータ (ヘルスケアにおける AI トレーニング データセット) が必要です。
- 自動化と節約: 適切にトレーニングされたモデルは管理タスクを自動化し、運用コストを最大 30% 削減できます。
- より迅速な診断AI を活用したシステムは、従来の人間のワークフローに比べて最大 3 倍の速度で 1,000D スキャンと健康記録を分析します。
- パーソナライズされたケアデータに基づく意思決定を通じて、パーソナライズされた治療と効率的な健康モニタリングを可能にします。
つまり、質の高いデータは、医師、病院、そして患者にとって、より良い結果をもたらす原動力となる。
ヘルスケアトレーニングデータセットの品質確保
すべてのデータが同じように作られているわけではありません。ヘルスケアAIが効果を発揮するには、データは以下のような条件を満たしている必要があります。
- 正確な: ラベルとアノテーションは正しくなければなりません。ラベルが誤って付けられた画像は、AIに誤診を学習させる可能性があります。
- 雑多: 偏りを避けるために、データはさまざまな年齢、性別、民族、地域を代表する必要があります。
- 完全: 情報が不足すると学習が不完全になります。
- タイムリーな: データは時代遅れの慣行ではなく、最新の治療法とプロトコルを反映する必要があります。
- 専門家による注釈: 訓練を受けた医療専門家だけが臨床データに適切に注釈を付けることができます。
こう考えてみてください。質の低いデータでAIを訓練するのは、時代遅れで間違いだらけの教科書を使って医学生を教えるようなものです。結果は予想通り、誤った判断を下すことになります。
規制とプライバシーに関する考慮事項
医療データは単に機密性が高いだけでなく、神聖なものです。患者は最もプライベートな情報を医療提供者に託すため、その保護は譲れないものです。
- HIPAA(米国) (NAIST) と GDPR(ヨーロッパ) データの使用方法について厳格な基準を設定します。
- 匿名化と非識別化 個人情報(名前、住所など)を削除して、プライバシーを損なうことなくデータセットを安全に使用できるようにします。
- セーフハーバー基準 削除する必要がある識別子を正確に定義します。
AIプロジェクトにおいては、匿名化された医療データを使用することで、法令遵守を確保しつつ、イノベーションを促進することができる。
最新の AI フレームワークの活用
ヘルスケアトレーニングデータの役割は、現代の AI 技術によって進化しました。
- 生成AIとLLM(ChatGPTなど): 医療データに関するトレーニングを行うことで、患者の概要を書いたり、退院指示書を作成したり、患者の質問に答えたりできるようになります。
- 検索拡張生成 (RAG): 言語モデルと構造化された医療データベースを組み合わせて、出力が正確かつ最新であることを保証します。
- 微調整と迅速なエンジニアリング: 汎用モデルは、ドメイン データセットを使用してトレーニングすると、医療に特化したものになります。
マルチモーダル医療データセットの力
多様なデータタイプを組み合わせることで、AIモデルの精度、一般化可能性、堅牢性が向上します。現代のヘルスケアAIは以下を活用しています。
- より豊富な診断コンテキストのためのテキスト + 画像。
- 自動チャート作成と遠隔医療のためのオーディオ + EHR。
- リアルタイムの患者モニタリングのためのセンサー + 画像データ。