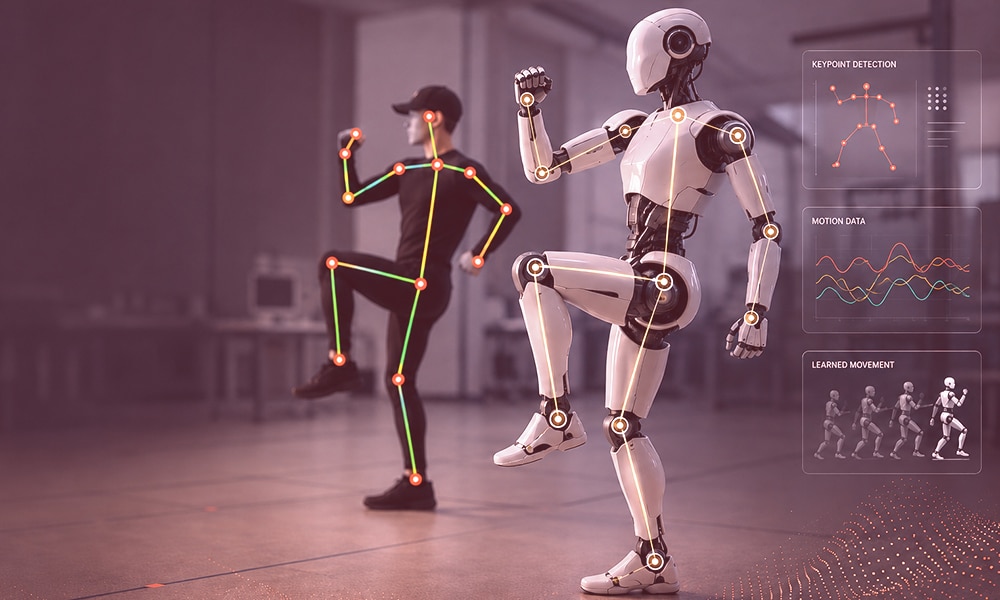
一人称視点データセットとは、頭部、胸部、または手首に装着したカメラで撮影された、一人称視点のビデオ映像とセンサー記録を構造化して収集したもので、ロボット工学や身体化されたAIシステムに、人がどのように見て、動き、行動するかを学習させるために使用されます。これは、ロボットのオンボードカメラが動作中に捉える映像に最も近いものであり、そのため、視覚・言語・行動(VLA)モデルの学習において基礎となるものとなっています。
実験室の映像だけで訓練されたロボットは、実験室を出た初日に故障することが多い。その原因はモデルにあることはほとんどなく、データにあるのだ。
ほとんどのトレーニングビデオは三脚や天井カメラで撮影されています。こうした映像には部屋の様子は映りますが、作業そのものは映りません。手も、対象物も、ロボットが実際にカップを持ち上げたり引き出しを開けたりする際に、搭載カメラが捉える正確な角度も捉えられていません。自己中心的なデータセットは、まさにこのギャップを埋めるために構築されたものです。
このガイドでは、自己中心型データセットとは何か、なぜ一人称データが現代のロボット工学や具現化されたAIの基盤となっているのか、良質なデータとは実際にどのようなものか、そしてライセンスを取得したり委託したりする前にチームが確認すべき点について解説します。
自己中心データセットとは何ですか?
自己中心型データセットとは、一人称視点で撮影されたビデオデータとセンサーデータを構造化して収集したものです。カメラは、作業を行う人物の頭、胸、手首などに取り付けられ、場合によってはロボット自体にも取り付けられるため、記録された映像は、作業者が見ている世界をそのまま映し出します。
「自己中心的」とは、単純に自分自身の視点という意味です。三人称視点のカメラは部屋の中で何が起こっているかを映し出します。一方、自己中心視点のカメラは、その出来事が起こっている最中に、俳優の手、目、そして道具が何をしているかを映し出します。この違いは些細なものに聞こえるかもしれませんが、ロボットチームにとっては、すべてを左右するほど重要なのです。
現代のほとんどの自己中心型データセットは、ビデオに加えて、深度、動き、音声、場合によっては視線や手の追跡といった付加的な信号を組み合わせることで、一つの瞬間を複数の角度から同時に分析できるようにしている。
[関連記事:ロボットのトレーニングデータ戦略]
自己中心的なデータがロボット工学と具現化されたAIにとって重要な理由
ロボットが現実世界で失敗する理由はいくつかあるが、その中でも誤った視点は上位に位置する。

一人称視点データで学習することで、変換ステップが不要になります。モデルは、後で使用するのと同じ視点から学習します。最近のロボット学習の研究では、一人称視点データで学習したポリシーは、タスクの種類にもよりますが、操作タスクにおいて三人称視点データで学習したポリシーよりも15~30%優れた性能を発揮することが示されています。その効果は、作業そのものにも表れています。より正確な把持、より優れた手と目のタイミング、雑然とした状況や部分的な視界に対するより賢明な対応などです。
これが、一人称データが物理AIシステムや、視覚入力と音声または文字による指示を受け取り、物理世界で実際の動作を出力する新しい波のビジョン・ランゲージ・アクションモデルの中心にある理由でもある。
高品質な自己中心データセットの内部
生の動画だけでは不十分です。高品質の一人称データ収集では、一人称視点の動画と他のいくつかの信号を組み合わせて使用します。
- 同期ビデオ 高解像度で、多くの場合、複数の角度(頭部、胸部、手首など)から撮影されている。
- 深度データ これは、モデルがオブジェクトがフレーム内のどこに見えるかだけでなく、どれだけ遠くにあるかを理解するのに役立ちます。
- モーションセンサー(IMU)データ 頭と体の動きをフレームごとに追跡する
- オーディオ ― まな板の上のナイフや近くで話している人など、驚くほど多くの文脈情報が含まれている
- 手の動きや視線の動きを追跡する 注意力と握力が重要な作業
問題は、これらすべてがミリ秒単位で正確に同期する必要があることです。深度ストリームがビデオから0.25秒でも遅れると、モデルは誤った因果関係を学習してしまいます。適切に調整されたキャプチャの上に、しっかりとした自己中心的データ注釈を付けることで、生の録画データがトレーニング可能なデータへと変わります。
実験室での映像と実世界での撮影映像の比較
別の種類のトレーニング問題をイメージしてみると良いでしょう。
ドローンで上空から撮影した映像だけを見せて、誰かに自転車の乗り方を教えるところを想像してみてください。自転車、道路、そして道は見えるでしょう。しかし、ハンドルの揺れや、カーブで視線を前方に向ける様子、曲がる前に体をどのように動かすかといったことは分かりません。技術的には自転車に乗っている様子は分かるかもしれませんが、実際に乗りこなす方法は全く分からないでしょう。
実験室のデータも、規模が大きくなると同様の問題を抱えています。照明はきれいで、テーブルの上には一つの物体が置かれ、クリップごとに一つの作業が行われる――整然としていますが、ロボットが実際に運用される世界とは異なります。実験室の映像で訓練されたモデルは、初日はうまく機能するものの、照明がちらついたり、二人の人がすれ違ったり、同じ棚に3つの商品が並んだりすると、30日目には機能しなくなることがよくあります。
現実世界における自己中心的な視点からの把握は、ノイズを再び取り込む。そのノイズこそが、モデルが展開後も有効性を維持する要因となる。
[関連記事:VLAモデルは自己中心的動画をどのように活用しているか]
自己中心的データセットスタックの4つの層
異なる問題には異なるデータレイヤーが必要です。あるタスクのために構築されたデータセットが、別のタスクを十分にカバーできることはほとんどありません。物理AIチームが完全な具現化AIデータセットを構築するために積み重ねるレイヤーについて、簡単に考えてみましょう。
ほとんどの制作チームは複数のレイヤーから情報を得ています。例えば、食器洗い機に食器を入れる必要があるヒューマノイドロボットは、少なくとも3つのレイヤー、つまり人間のデモンストレーション、精密な操作、そして段階的な作業構造から情報を得ています。
自己中心的なデータが真の需要を牽引する

こうしたギャップは様々な業界で見られ、それが一部の地域で一人称視点トレーニングデータの需要が高まっている理由です。
- 人型ロボットと家庭用ロボット。 料理、掃除、食料品の片付け。ロボットがやってみるまでは簡単そうに見える作業だ。
- 自律移動。 運転、車内での行動、ラストマイル配送。一人称視点キャプチャにより、シミュレーションと実際の道路とのギャップが縮まります。
- 産業界における自己中心的なデータセット。 工場現場、組立ライン、石油・ガス採掘現場などは、安全検知、人間工学に基づいた追跡、作業支援ロボットの訓練に利用されている。
- 手術中の1人称視点ビデオデータ。 外科医が装着するヘッドマウントカメラで撮影した手術手順の映像は、支援モデルや医療用ARシステムのトレーニングに使用される。
- 小売業における消費者行動に関する自己中心的なデータ。 実際の店舗で買い物客を撮影したウェアラブル端末の映像は、棚での注意の向け方、移動の仕方、意思決定などを研究するために使用される。
業界は違えど、根本的なニーズは同じだ。それは、実験室ではなく、実際の作業現場のようなデータが必要だということだ。
自己中心的なデータセットをモデル化に適した状態にするには何が必要か?
社内で構築する場合でも、自己中心的なデータプロバイダーを評価する場合でも、研究レベルのデータと実運用に耐えうるデータを区別する5つの要素は次のとおりです。

- 自己中心的なデータ注釈の深さ。 境界ボックスだけではありません。手のポーズ、物体の状態、動作手順、そして意図――すべてが適切なフレームに揃っています。
- センサーの校正。 映像、深度、音声、動きを時間的に同期させることで、モデルは5つのばらばらなストリームではなく、1つのまとまった瞬間を認識できるようになります。
- エッジケースへの対応。 低照度、遮蔽物、混雑したシーン、稀な事象。これらは、ラボデータでは見落とされがちなケースです。業界のバイヤー調査では、データパートナーを評価する際の基準として、アノテーションの品質とエッジケースの網羅性が常に上位2位に挙げられています。
- 同意と遵守。 一人称視点の動画は、定義上、機密性の高い情報を含みます。データセットには、参加者の同意書、必要に応じた顔の匿名化、GDPRやHIPAAなどのフレームワークへの準拠が必要です。ISO 27001やSOC 2 Type IIといったベンダー管理基準は、企業法務チームが求める手続き上の要件を満たします。
- シミュレーションから実戦への移行準備。 実世界の映像と合成データがうまく組み合わせられるため、チームはモデルの信頼性を支える基礎を失うことなく、トレーニングを拡張できる。
質の高いデータ収集は、後から修正するのが最も難しい部分です。最初から正しくデータ収集を行えば、その後の処理ははるかに簡単になります。
主要な取り組み
- 一人称視点データセットとは、一人称視点のビデオとセンサーデータのことである。 俳優自身の視点から撮影された映像は、ロボットや身体を持つAIモデルが実際に配備された際に世界をどのように認識するかを訓練するために使用される。
- 一人称データは、認識と行動のギャップを埋める。 そのため、実験室で訓練されたロボットが実際の勤務シフトで失敗する原因となる。
- 質の高い自己中心的データはマルチモーダルである 映像、深度、音声、動き、トラッキングといった要素がミリ秒単位で同期される。
- 本番環境対応とは、注釈以上のものを意味する。 つまり、エッジケースへの対応、実環境への対応、シミュレーションから実環境への移行準備、そして文書化されたコンプライアンス履歴を意味します。
Shaipがどのように役立つか
もしあなたのチームが「自己中心的なデータが必要かどうか」という段階を過ぎ、「実際にどうやってデータを入手するか」という段階に入っているなら、Shaipはまさにうってつけのツールです。
当社は、物理AIプログラムの背後にあるデータパイプライン全体(実環境での一人称視点キャプチャ、VLAグレードのアノテーション、合成データ、RLHF、評価ベンチマーク)を単一の契約で運用しています。具体的な内容は以下のとおりです。
- 実験室での映像ではなく、実際の現場で撮影された映像です。 キッチン、倉庫、工場、医療施設、店舗など、あらゆる場所で、ヘッドマウントカメラ、スマートグラス、ウェアラブル端末が活用されている。
- マルチセンサー同期。 映像、IMU、LiDAR、音声、深度データはすべて、ミリ秒単位で較正され、時間的に同期されている。
- VLA訓練用に作成された注釈。 物体、動作、手と物体の相互作用、意図、および空間的文脈。
- シミュレーションと現実世界との連携をサポート。 現実世界との整合性を損なうことなく、対象範囲を拡大する合成生成およびReal2Simパイプライン。
- 初日から法令遵守。 ISO 27001、SOC 2 Type II、HIPAA対応、GDPRに準拠。同意を最優先としたデータ収集と、監査対応のデータ来歴管理を実現。
もしそれが貴社の物理AIプログラムの方向性と合致するのであれば、パイロットプロジェクトの範囲を検討させていただければ幸いです。
結論
自己中心データセットとは、単なる一人称視点の動画のことではありません。それは、機械に人間のように見て行動することを教えるための構造化された方法です。ロボット工学や身体化されたAIチームにとって、それはデモでうまく機能するモデルと実際に製品化できるモデルの違いを生むものです。ヒューマノイド、自律システム、スマートファクトリーなど、目標が何であれ、ロボット工学やAI開発における自己中心データは、あらゆる本格的な身体化されたAIデータセット戦略の中核となるレイヤーになりつつあり、オプションではありません。これを正しく理解しているチームは、データの収集、注釈付け、検証、コンプライアンスをシステムの中核部分として扱い、システムの前段階として捉えていないチームです。