音声認識は、声の固有の特徴に基づいて人物を識別および認証する技術であり、その近縁技術である音声認識は、話された言葉をテキストまたはコマンドに変換します。これら2つの技術は、スマートスピーカーや車載制御から銀行のセキュリティ、臨床文書作成まで、あらゆるものを支えています。世界の音声認識および音声認識市場は、2023年に202億5000万ドルと評価され、2030年までに536億7000万ドルに達すると予測されており、年平均成長率(CAGR)は14.6%です(Grand View Research、2024年)。そして、その中でも音声認識は最も急速に成長している機能セグメントです(Grand View Research、2024年)。
このガイドでは、音声認識の仕組み、その用途、利点と限界、そして2026年にこの分野を再構築するであろう変化について解説します。
主要なポイント(要点)
- 音声認識は誰が話しているかを識別し、音声認識は話された内容を理解する。
- システムは、音高、周波数、アクセント、抑揚を分析して、独自の音声パターンを作成します。
- 主な用途:セキュリティおよび生体認証、音声起動デバイス、カスタマーサービス、ヘルスケア、自動車。
- 精度は、アクセントや言語を問わず、多様で適切にラベル付けされたトレーニングデータに大きく依存します。それを大規模に調達することが、すぐに使えるソリューションの鍵となります。 音声データセット チームの収集作業を数ヶ月分節約できる。
- 2026年のトレンドには、音声認識AIモデル、デバイス上での処理、音声ディープフェイク対策などが含まれる。
市場規模:音声認識技術は20年足らずで驚異的な成長を遂げました。では、将来はどうなるのでしょうか?2020年の世界の音声認識技術市場規模は約10.7億ドルでした。2021年から2026年にかけて年平均成長率(CAGR)16.8%で成長し、2026年には271億6000万ドルにまで急成長すると予測されています。
音声認識技術とは何ですか?
この分野の起源は、1950年代に数桁の数字しか認識できなかったシステムに遡ります。統計モデル、そして後にディープラーニングによって、これらの初期の実験は、今日数十億人が利用する常時音声認識アシスタントや安全な音声認証システムへと進化しました。
音声認識 – 利点と欠点
音声認識はどのように機能しますか?
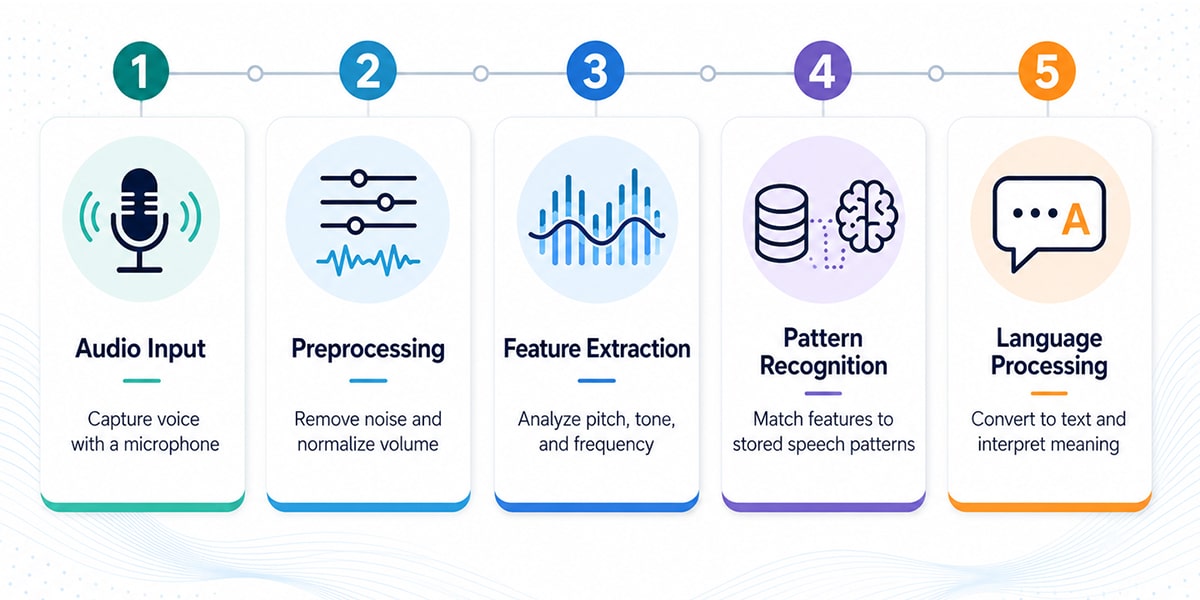
音声入力:このプロセスは、マイクを使用して音声入力を取得することから始まります。
前処理:音声信号からノイズを除去し、音量を正規化することで、音声信号をクリーンアップします。
特徴抽出:システムは音声を分析し、ピッチ、トーン、周波数などの主要な特徴を抽出します。
パターン認識:抽出された特徴は、データベースに保存されている既知の音声パターンと比較されます。
言語処理:認識されたパターンはテキストに変換され、自然言語処理(NLP)アルゴリズムによって意味が解釈されます。
音声認識のユースケース
音声認識技術は、さまざまな分野で幅広く応用されています。主な使用例をいくつかご紹介します。
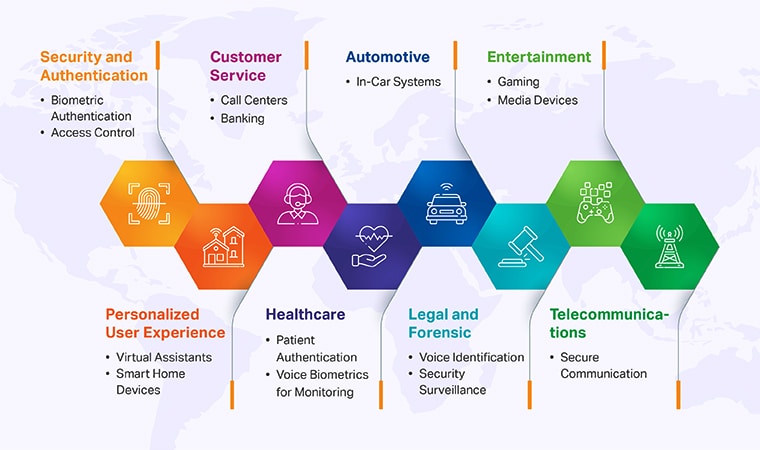
- セキュリティと認証:
- 生体認証: スマートフォンなどのデバイスで画面のロックを解除したり、ユーザーの身元を確認するために使用されます。
- アクセス制御: 権限のある人物を認識して、建物、保護されたエリア、機密情報へのアクセスを保護します。
- 音声認識製品例としては、ハンズフリー制御やセキュリティ強化のために音声認識を使用するスマートホームデバイスやセキュリティシステムなどがあります。
- パーソナライズされたユーザーエクスペリエンス:
- バーチャルアシスタント: ユーザーの声に基づいて応答とアクションをカスタマイズし、よりパーソナライズされたインタラクションを提供します。
- スマートホームデバイス家族それぞれの声を認識し、設定や好みに合わせてカスタマイズします。これらのハンズフリーデバイスはそれぞれウェイクワードで起動しますが、製品に合わせた正確なブランド固有のウェイクワードを作成するには、カスタマイズが必要です。 ウェイクワードトレーニングデータ.
- 音声入力: データ入力と自動化の生産性ツールとして使用され、さまざまな環境で効率と精度が向上します。
- 顧客サービス:
- コールセンター: 音声で顧客を識別し、パーソナライズされたサービスを可能にし、繰り返しの本人確認の必要性を減らします。
- バンキング: 安全で効率的なサービスのために、電話バンキング取引中に顧客を確認します。
- 音声テキスト変換ソフトウェア: 話し言葉をテキストに変換し、効率、顧客サービス、コミュニケーションの正確性を向上させます。
- 健康:
- 患者認証: 遠隔医療サービスおよび電子健康記録で患者の身元を確認します。
- モニタリングのための音声バイオメトリクス: 音声パターンの変化を分析して、うつ病などの症状を持つ患者を監視します。
- 医師の仮想アシスタント: 医師の音声をテキストメモに変換することで、医師は一日のうちにより多くの患者を診察し、分析できるようになります。
- サードパーティ アプリケーション: 医療アシスタントとヘルスケア ツールは音声認識を統合し、機能性を強化します。
- 自動車:
- 車載システム: ドライバーの音声を認識し、手動入力なしで設定を調整したり、ナビゲーションにアクセスしたり、インフォテインメント システムを制御したりします。
- ハンズフリー体験: ハンドルから手を離さずに、電話に出たり、曲を変えたり、メッセージに返信したり、道順を確認したりすることができます。これにより、道路上の安全性が向上するだけでなく、運転体験も向上します。
- 法医学および法廷:
- 音声識別: 音声録音の話し手を特定するために法的調査で使用されます。
- セキュリティ監視監視システムにおいて音声による個人識別を行うことでセキュリティ対策を強化します。
- 裁判所の報告: 高度な音声認識は、法廷審問や証言録取中の正確な法廷記録に使用され、従来の法廷報告方法に比べて効率と正確性が向上します。
- リテール・エンターテインメント:
- ゲーム業界: プレイヤーの声を認識してゲーム体験をパーソナライズします。
- メディアデバイス: ユーザーを識別して、ストリーミング デバイス上のコンテンツの推奨事項とプロファイルをカスタマイズします。
- 電気通信:
- 安全なコミュニケーション: 機密通話の参加者の身元を確認することで、安全な通信チャネルを確保します。
- 音声インターフェース: 生成 AI とスマート デバイスでの自然な会話型のインタラクションを可能にし、ユーザー エクスペリエンスをより直感的にします。
- 複数のデバイスとモバイルデバイス: 音声認識テクノロジーは、モバイル デバイスや Android スマートフォンなど複数のデバイス間でシームレスに機能し、外出先での生産性とユーザー エクスペリエンスをサポートします。
- 認識ソフトウェア作業: 最新の認識ソフトウェアは、さまざまな言語をサポートし、多言語サポートを提供し、モバイル デバイスや音声制御用のさまざまなプラットフォームとの互換性を提供することで機能します。
- 音声認識ソフトウェアの作業: 音声認識ソフトウェアはさまざまなプラットフォームで動作し、複数の言語をサポートし、サードパーティのアプリケーションと統合して機能を強化できます。
- さまざまな言語のサポート現代の音声認識システムは、さまざまな言語、方言、アクセントを切り替えることができるため、世界中で幅広く使用できます。
音声認識技術の例
- Apple Siri: 機知に富んだ知識豊富な友人がポケットの中にいて、いつでも助けてくれると想像してみてください。それが Siri です。会議に急いでいて、すぐにテキストを送信する必要がある場合でも、クッキー生地に肘まで浸かっていてタイマーをセットする必要がある場合でも、Siri があなたの声を認識し、個性的な応答をします。まるで、あなたのことをよく知っていて、あなたの文章をほぼ言い終えてくれるパーソナル アシスタントがいるかのようです。
- アマゾンアレクサ: 長い一日を終えて家に帰り、「アレクサ、ただいま」と言うところを想像してみてください。突然、お気に入りのリラックス プレイリストが流れ始め、照明が暗くなり、好みの夜の設定になり、アレクサがずっと観ようと思っていた番組を思い出させてくれます。まるで、家に帰るたびに、家があなたを包み、心地よく抱きしめてくれるかのようです。
- Googleアシスタント: Google アシスタントは、何でも知っているあなたの相棒です。天気が気になるとき、友好的な議論を解決したいとき、スマートホームをコントロールしたいときなど、いつでもあなたの声を認識し、あなたにぴったりの応答をしてくれます。いつでも喜んで助けてくれて、あなたの質問に飽きることのない、とても賢い友達がいるようなものです。
- Nuance Dragon NaturallySpeaking: 考えを話すのと同じ速さで紙に書き出せると想像してみてください。それが Dragon NaturallySpeaking の魔法です。次のベストセラーを執筆中の小説家や患者の記録を更新する医師にとって、それはあなたの声のあらゆる単語、アクセント、ニュアンスを理解する、非常に効率的で疲れない筆記者がいるようなものです。それは単に入力するだけではなく、あなたの考えを解放するのです。
- マイクロソフト コルタナ: Cortana は、常に一歩先を行くパーソナル オーガナイザーのようなものです。忙しい月曜日の朝に、Cortana が「声から判断すると、少しストレスがたまっているようですね。それほど緊急ではない会議を今週後半に変更しましょうか?」と声をかけてくれるところを想像してみてください。これは単にスケジュールを管理するだけではありません。声のニュアンスを理解し、1 日をスムーズにするのに役立つデジタル アライアンスを持つことです。