構造化データを分析すると、より適切な診断と患者ケアが可能になります。一方、非構造化データを分析すると、画期的な医学的進歩や発見につながる可能性があります。
これが、今日お話しするトピックの要点です。ヘルスケア テクノロジーの分野でこれほど多くの革新的な進歩が、使用可能なヘルスケア データのわずか 10 ~ 20% で実現されたことは、非常に興味深いことです。
統計によると、このスペクトルのデータの 90% 以上は非構造化されており、使い勝手が悪く、理解、解釈、適用が難しいデータとなっています。医師の処方箋などのアナログ データから、医療用画像やオーディオビジュアル データなどのデジタル データまで、非構造化データにはさまざまな種類があります。
このような膨大な非構造化データには、医療の進歩を数十年早めることができる素晴らしい洞察が詰まっています。生命に関わる重大な自己免疫疾患に対する新薬の発見に役立てることから、医療保険会社のリスク評価に役立つデータまで、非構造化データは未知の可能性への道を切り開くことができます。
こうした目標が掲げられる場合、医療データの解釈可能性と相互運用性が極めて重要となる。GDPRやHIPAAといった厳格なガイドラインと規制遵守の徹底が求められる状況下では、医療データの匿名化は避けられないものとなる。
構造化医療データと非構造化医療データの解説については、既に詳細な記事を掲載しています。また、医療データの匿名化についても、専用の(つまり詳細な)記事があります。非構造化データの匿名化に関する特別記事も掲載予定ですので、包括的な情報を得るために、ぜひこれらの記事をお読みいただくことをお勧めします。
非構造化データの匿名化における課題
その名の通り、非構造化データは整理されていません。フォーマット、ファイルの種類、サイズ、コンテキストなど、さまざまな点でばらばらです。音声、テキスト、医用画像、アナログデータなど、非構造化データが多様な形式で存在するという事実だけでも、非構造化データの匿名化に不可欠な個人情報識別子(PII)を理解することがさらに困難になります。
基本的な課題を一目で理解していただくために、以下に簡単なリストを示します。

- 文脈理解 – AI の利害関係者にとって、非構造化データの特定の部分または側面の背後にある特定のコンテキストを理解することが難しい場合。たとえば、名前が会社名なのか、人の名前なのか、製品名なのかを理解すると、匿名化する必要があるかどうかというジレンマが生じる可能性があります。
- 非テキストデータ – 名前や個人情報の聴覚的または視覚的な手がかりを識別することは、関係者が重要な側面を匿名化するために何時間もの映像や録音をじっと見なければならない可能性があるため、困難な作業になる可能性があります。
- 曖昧さ これは、医師の処方箋や病院の記録などのアナログ データのコンテキストで特に当てはまります。手書きから自然言語での表現の制限まで、データの匿名化は複雑な作業になる可能性があります。
非構造化データの匿名化のベストプラクティス
非構造化データから個人情報(PII)を削除するプロセスは、構造化データの匿名化とは大きく異なりますが、不可能ではありません。体系的かつ文脈に即したアプローチを用いることで、非構造化データの可能性をシームレスに活用できます。では、その実現方法について見ていきましょう。
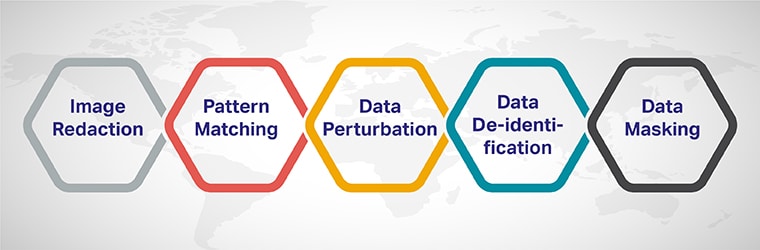
画像編集:これは医療画像データに関するもので、患者識別情報の削除、解剖学的参照情報や画像の一部をぼかす処理を含みます。これらの情報は特殊文字に置き換えられ、画像データの診断機能と有用性が維持されます。
パターンマッチング:氏名、連絡先、住所など、最も一般的な個人情報の一部は、事前に定義されたパターンを分析する手法を用いて検出および削除することができます。
差分プライバシーまたはデータ摂動: 個人にまで遡ることができるデータや属性を隠すために、制御されたノイズを含めることが含まれます。この理想的な方法は、データの匿名化を保証するだけでなく、分析のためにデータセットの統計的特性も保持します。
データ匿名化:これは、非構造化データから個人識別情報(PII)を削除するための最も信頼性が高く効果的な方法の1つです。これは、次の2つの方法のいずれかで実装できます。
- 教師あり学習 – テキストやデータをPIIか非PIIかに分類するようにモデルをトレーニングする場合
- 教師なし学習 – 個人情報を識別する際にパターンを検出する方法を自律的に学習するようにモデルをトレーニングする
この方法は、患者のプライバシーを保護しつつ、作業の中で最も冗長な部分については人間の介入を維持することを保証します。機械学習技術を用いて非構造化データを匿名化する関係者や医療データ提供者は、公平性、関連性、および結果の正確性を確保するために、人間が関与する品質保証プロセスを導入するだけで済みます。
データマスキング:データマスキングとは、医療データを匿名化するためのデジタル用語であり、特定の識別子を、次のような特殊な技術を用いて一般化または曖昧化します。
- トークン化 – 個人情報を文字やトークンに置き換えることを含む
- 一般化 – 特定のPII値を一般的な/曖昧な値に置き換える
- シャッフル – 個人情報を混同して曖昧にする
しかし、この方法には、洗練されたモデルやアプローチによって、データを再識別可能にすることができるという制限がある。
市場プレーヤーへのアウトソーシング
非構造化データの匿名化プロセスが完璧で、HIPAAガイドラインに準拠していることを保証する唯一の正しい方法は、 Shaipのような信頼できるサービスプロバイダーに業務をアウトソーシングすることです。最先端のモデルと厳格な品質保証プロトコルにより、データプライバシーにおける人的監視を常に最小限に抑えます。
長年にわたり市場をリードしてきた当社は、お客様のプロジェクトの重要性を理解しています。Shaip が匿名化したヘルスケア データを使用して、ヘルスケアの目標を最適化するために、今すぐ当社にご連絡ください。