
物理AIにおいては、モデルがボトルネックになることはほとんどなく、データこそがボトルネックとなる。デモでは完璧に動作したロボットポリシーが、実際の倉庫で停止してしまう場合、その原因はほぼ間違いなく、アーキテクチャではなく、これまで見たことのないデータにある。そのため、すべてのロボット開発チームは予算に関する課題に直面する。ロボット開発に合成データと実世界のデータを使用するかどうかを決める際、どちらを購入すべきか?どちらにもそれぞれ強みとコストがあり、最適な答えはプロジェクトの現状によって異なる。
主要なポイント(要点)
- 合成データは、安価で拡張性が高く、大量のエッジケースを生成するのに安全です。
- 実世界のデータは、シミュレーションでは捉えきれないセンサーノイズやロングテール変動を捉えている。
- シミュレーションと現実とのギャップこそが、合成データのみを用いたモデルが実用化において失敗する主な理由である。
- 実世界のデータ収集コストは収集時間に比例して増加するが、合成データは一度構築してしまえば低コストで拡張できる。
- 合成データは不足部分を補い、実世界データはトレーニングの基盤となる。2026年にはハイブリッド方式が勝利を収めるだろう。
- 合成データは早めに購入し、微調整や展開の前に実世界のデータを購入する。
ロボット工学における合成データとは何ですか?

ロボット工学における合成データとは、現実世界の物理的なロボットから取得されたデータではなく、シミュレーションで人工的に生成された訓練データのことです。物理エンジンまたはワールドモデルがシーン、動き、センサーの読み取り値をレンダリングし、すべてのフレームに完璧な正解データを自動的にラベル付けします。
シミュレーターはすべてのオブジェクトの正確な位置、質量、および動きを把握しているため、手動パイプラインでは到底及ばない速度で完璧なラベルを生成します。合成データは、視覚(セグメント化された画像、さまざまな照明)、3Dおよび深度(点群、ナビゲーションマップ)、動き(軌跡、関節角度、速度)、および相互作用(把持、接触、衝突)の4つの主要なタイプを網羅しています。ドメインランダム化(色、テクスチャ、照明を現実的な範囲を超えて意図的に変化させること)により、モデルはタスクに関連する特徴に焦点を当てるようになります。
ドメインランダム化:シミュレーションの外観を現実的な限界を超えて変化させることで、モデルが明示的に示されたことのない現実の状況にも一般化できるようにする手法。
[関連記事:物理AIデータセットスタック]
ロボット工学における実世界データとは何ですか?
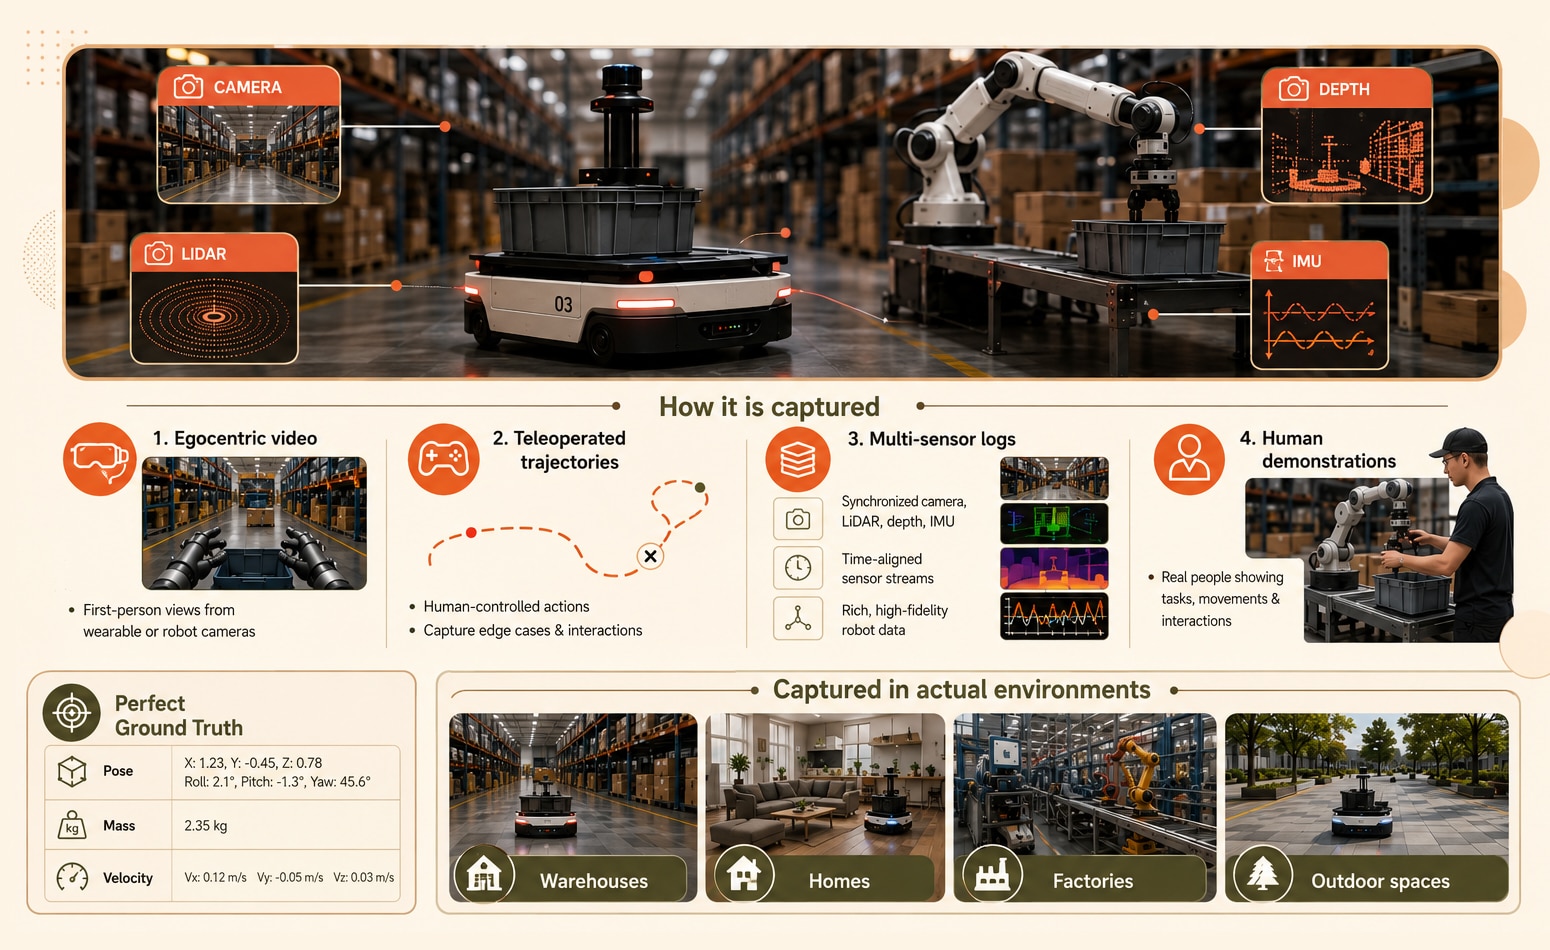
ロボット工学における実世界データとは、物理センサー、遠隔操作、または実際の環境における人間のデモンストレーションから取得されたトレーニングデータのことです。そこには、ロボットが研究室を出た瞬間に直面する、実際のノイズ、照明の変化、そして予測不可能な変動性が含まれています。
これは、モデルを現実世界に根付かせるためのデータです。これには、一人称視点のビデオ、遠隔操作による操作軌跡、カメラ、LiDAR、深度、IMUのストリームを組み合わせたマルチセンサーログ、そして人間のデモンストレーション録画が含まれます。Shaipの実世界データ収集は、多様なグローバル環境における一人称視点のビデオ、遠隔操作、操作キャプチャを網羅しており、まさにシミュレーションでは再現が難しい高変動シナリオを網羅しています。
自己中心的データ:頭部、胸部、または手首に取り付けられたカメラから取得された、ロボットが作業中に見ているものを反映した一人称視点のビデオおよびセンサー記録。
合成データと実世界のデータ:両者を比較するとどう違うのか?
合成データと実世界データは、それぞれ正反対の課題を解決するものです。合成データはコスト、規模、エッジケースの網羅性において優れており、実世界データはリアリティ、センサーの精度、導入時の信頼性において優れています。以下の表は、購入者が最も重視するトレードオフを示しています。
シミュレーションと現実のギャップとは何か?そして、なぜそれが重要なのか?
シミュレーションと実世界のギャップとは、シミュレーションで訓練されたモデルが、訓練では再現されなかった実世界の状況に直面した際に発生する性能低下のことです。これは、合成データのみで構築されたロボットモデルが実運用で不具合を起こす最大の理由です。
シミュレーターでしか操縦経験のないパイロットを想像してみてください。彼らはあらゆるシナリオを完璧にこなすことができますが、シミュレーターでは滑らかに処理されていたような実際の乱気流に初めて遭遇すると、訓練の限界が露呈します。ロボットも同様です。仮想倉庫のクリーンな環境を完璧にこなせるシステムでも、想定外の角度から実際のフォークリフトが現れたり、レンダリングでは捉えきれないような太陽光がセンサーに降り注いだりすると、フリーズしてしまう可能性があります。
シミュレーションは単純化された物理仮定に基づいており、センサーのアーティファクト、材料の特殊なケース、あるいは真に過酷な状況をモデル化することは稀である。実世界のデータは、物理的なデータ取得によってのみ得られる変動の長い裾野をモデルに反映させることで、このギャップを埋める。
[関連記事:VLAモデルがトレーニングデータから必要とするもの]
合成データと実世界のデータのコストを比較するとどうでしょうか?
合成データと実世界のデータのコスト差は、単なる価格の問題ではなく、構造的なものです。合成データの場合、生成パイプラインを構築するための初期費用が高額になりますが、その後はフレームごとの追加コストは計算処理のみに近づきます。一方、実世界のデータは正反対で、コストは物理的なキャプチャ時間とラベル付けされたシーケンスの数にほぼ比例して増加します。
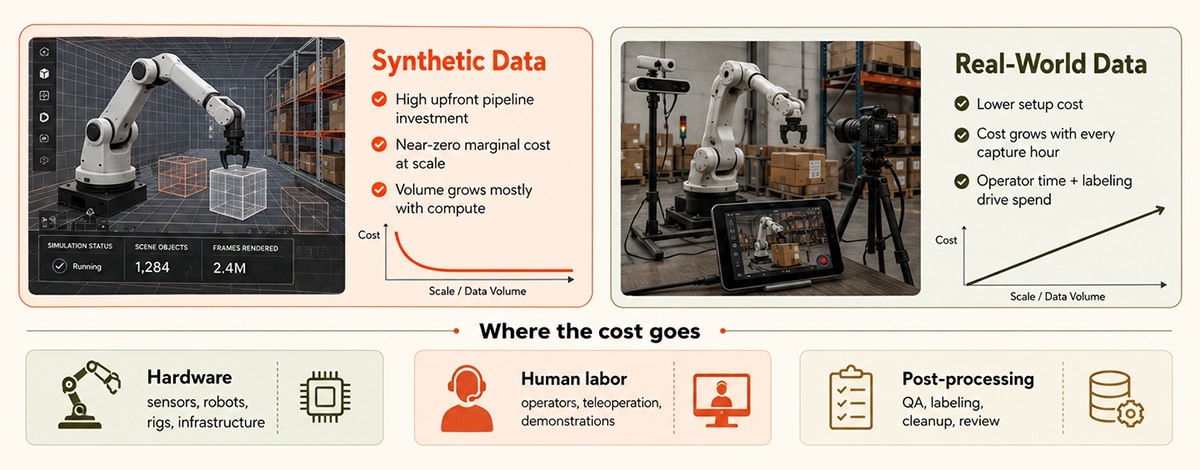
ロボットのトレーニングデータにかかるコストは、ハードウェア、人件費、後処理の3つの要素に分けられ、それらのバランスはアプローチによって異なります。
- 合成:初期段階でのパイプライン投資は高額だが、生産量を拡大する際の限界費用はほぼゼロ。
- 実際の運用面では、初期設定費用は低いものの、撮影時間、オペレーターの作業時間、ラベル付けにかかる費用が時間とともに増加する。
- ハイブリッド:合成素材が大量の負荷を吸収し、実世界の支出は現実性が最も重要な部分に集中する。
この非対称性こそが、購入決定の核心です。合成データは、パイプラインが確立されれば低コストで拡張できる一方、実世界データは、導入が近づくにつれて予算が集中する部分です。しかし、コストが低いことはリスクが低いことと同じではありません。そこに、意思決定の微妙な違いが生じるのです。
物理AIプロジェクトにはどちらを購入すべきでしょうか?
開発初期段階で規模、安全性、スピードが必要な場合は合成データを購入し、微調整や展開の前にシミュレーションと実世界のギャップを埋める必要がある場合は実世界データを購入してください。どちらを選ぶかは、イデオロギーではなく、プロジェクトの段階によって決めるべきです。
中規模の物流会社が、新しいフルフィルメントセンター向けに自律移動ロボットを開発している場面を想像してみてください。初期段階では、現場にハードウェアがないため、ほぼ完全に合成データに頼っています。何千もの仮想通路レイアウト、こぼれた液体、フォークリフトとのニアミスなどを生成し、知覚とナビゲーションを安全に事前学習させます。最初の実機が到着すると、状況は一変します。シミュレーターでは予測できなかった、反射する床、午後4時の荷積みドックの眩しさ、特殊なフィルムで包まれたパレットなど、実際の施設の状況をリアルにキャプチャして動作を微調整します。合成データでロボットを動かし、実機データで実用化を実現したのです。
実用的な意思決定フレームワーク:
- ハードウェア開発前または初期の研究開発段階 → 事前学習とストレステストのために合成データに重点を置く。
- 稀な、危険な、またはプライバシーに関わるシナリオ → それらを安全に大量生成するために合成データを使用する。
- 特定の環境に合わせて微調整する → その環境からの実世界データ。
- 検証と安全認証 → 毎回、実世界のデータに基づきます。
ハイブリッドロボティクスデータ戦略が2026年に勝利する理由
ハイブリッド型ロボットデータ戦略では、合成データを用いて特定のギャップを埋めつつ、実世界のデータに基づいてトレーニングを行うことで、モデルに真の変動性を持たせます。これは、合成データのみを用いたパイロットテストがシミュレーションから実世界への移行の壁にぶつかった際に、開発チームが最終的に採用するアプローチです。
理由は単純明快です。合成データはデータ量とエッジケースを提供し、実世界データは現実性と信頼性を提供します。Shaipは、実世界のデモンストレーションデータと自己中心的データに基づいて物理AIプログラムを支えつつ、ロングテールデータのための合成生成もサポートします。これにより、チームはロボットを安全に現場で稼働させるための基盤を損なうことなく、規模を拡大できます。すぐに使えるデータセットが必要なチームには、厳選された既製データライセンスを利用することで、さらに時間を短縮できます。
ロボットデータパートナーをどのように評価しますか?
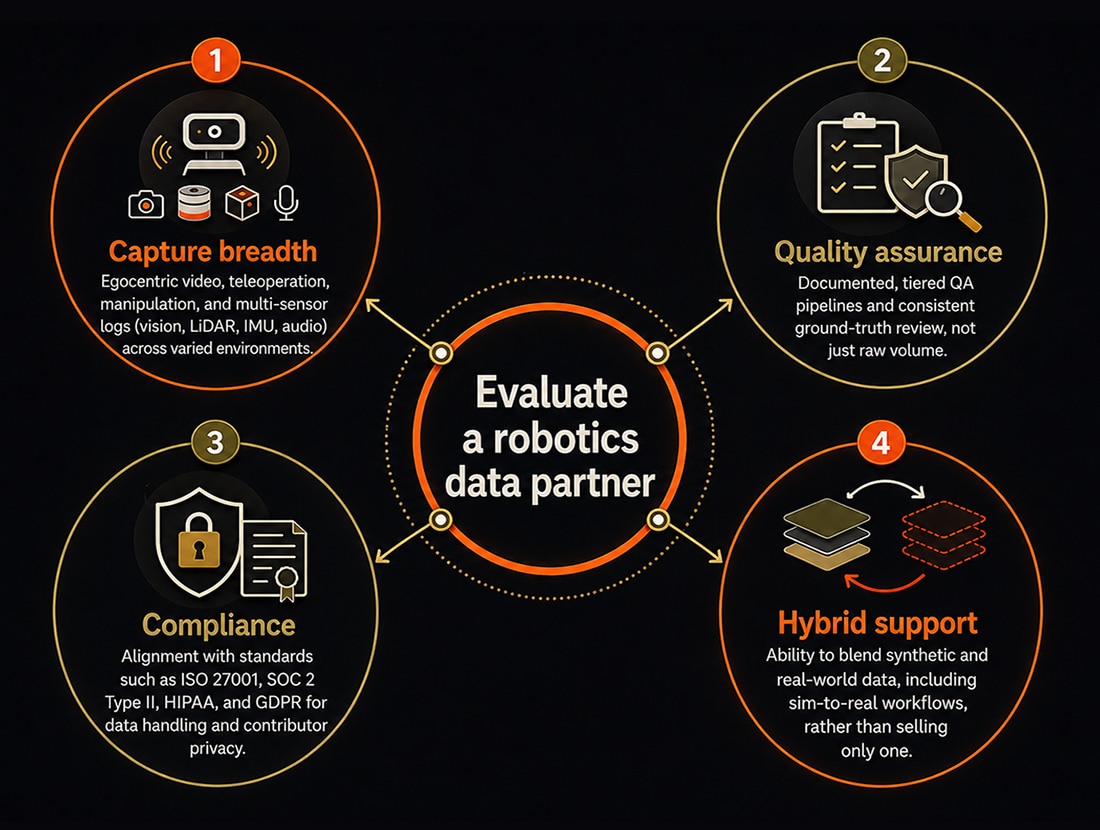
ロボットデータパートナーを評価する際は、価格だけでなく、実世界でのデータ取得能力、対象範囲、品質保証、コンプライアンスといった点も考慮する必要があります。実世界でのデータ収集は、機密性の高い環境や人間の協力者に関わるため、セキュリティとガバナンスはラベルの正確性と同じくらい重要です。
- 多様な環境における、一人称視点ビデオ、遠隔操作、マニピュレーション、およびマルチセンサーログ(画像、LiDAR、IMU、音声)の取得範囲の広さ。
- 品質保証:単なるデータ量ではなく、文書化された階層的な品質保証パイプラインと一貫した現場検証。
- コンプライアンス:データ処理および貢献者のプライバシーに関して、ISO 27001、SOC 2 Type II、HIPAA、GDPRなどの規格に準拠していること。
- ハイブリッドサポート:合成データと実世界のデータを組み合わせる機能(シミュレーションから実世界へのワークフローを含む)を提供し、どちらか一方だけを販売するわけではない。
これらの基準のすべてにおいて、Shaipの物理AIデータサービスは、ロボット工学および具現化AIチーム向けのエンドツーエンドのパートナーとして構築されています。マルチモーダルなデータ収集、複雑なVLAおよびアクション注釈、合成データ生成、RLHF、評価までを1つの契約で提供します。Shaipは、オープンなクラウドソーシングではなく、管理されたグローバルコレクターネットワークを通じて、モデルが実際に動作するキッチン、倉庫、工場、街路、医療施設などの実環境からデータを収集します。ISO 27001、SOC 2 Type II、HIPAA対応、GDPR準拠のコントロールを備えています。
その経験は大規模なプロジェクトにも活かされています。あるヒューマノイドロボット開発プログラムにおいて、ShaipはQRコードによるシーン設定、5つのセンサーによるトラッキング、モデレーターによるリハーサル、モデル準備完了の品質保証といったデータ運用基盤全体を構築し、わずか30日間で約4,000人の参加者と100のタスクにわたる10,000時間分の自己中心型VRモーションデータを生成しました。プログラムがセットアップから展開準備完了までのどの段階で構築されたのか、詳細なケーススタディをご覧ください。





