人工知能(AI)と機械学習(ML)の進化する世界において、データはイノベーションを推進する原動力となっています。しかし、質の高い実世界データを取得するには、時間と費用がかかり、プライバシーに関する懸念も伴うことが少なくありません。そこで登場するのが合成データです。これは、これらの課題を克服し、AI開発における新たな可能性を切り開く革新的なアプローチです。本ブログでは、2つの主要な視点から得られた知見を統合し、合成データの利点、ユースケース、リスク、そしてAIの未来をどのように形作っていくのかを探ります。
合成データとは何ですか?
合成データとは、コンピュータアルゴリズムやシミュレーションによって人工的に生成されたデータのことです。出来事、人、物などから収集される実世界のデータとは異なり、合成データは実世界のデータと直接結びつくことなく、その統計的特性や行動特性を模倣します。実データの代替手段として、効率的で拡張性が高く、プライバシーにも配慮した手法として、ますます広く採用されています。
ガートナーによると、AIプロジェクトで使用されるデータのうち、合成データが占める割合は2024年までに60%に達すると予測されており、これは現在の1%未満から大幅な増加となる。この変化は、実世界のデータの限界に対処する上で、合成データの重要性が高まっていることを示している。
実際のデータではなく合成データを使用する理由
1. 合成データの主な利点
- 費用対効果: 現実世界のデータを取得してラベル付けするには、コストと時間がかかります。合成データはより迅速かつ低コストで生成できます。
- プライバシーとセキュリティ 合成データは実際の個人や出来事に結び付けられていないため、プライバシーに関する懸念がなくなります。
- エッジケースカバレッジ: 合成データを使用すると、自動運転車のテストにおける自動車事故など、まれなシナリオや危険なシナリオをシミュレートできます。
- スケーラビリティ: 合成データは無制限に生成でき、堅牢な AI モデルの開発をサポートします。
- 自動注釈データ: 実際のデータとは異なり、合成データセットは事前にラベル付けされているため、時間を節約し、手動での注釈付けのコストを削減できます。
2. 実際のデータが不十分な場合
- まれなイベント: 現実世界のデータには、まれなイベントの例が十分に含まれていない可能性があります。合成データは、これらのシナリオをシミュレートすることで、このギャップを埋めることができます。
- データのプライバシー: 医療や金融などの業界では、プライバシーに関する懸念から、現実世界のデータへのアクセスが制限されることがよくあります。合成データは、統計的な正確性を維持しながら、これらの制限を回避します。
- 観測不可能なデータ: 赤外線画像やレーダー画像などの特定の種類の視覚データは、人間が簡単に注釈を付けることができません。合成データは、このような目に見えないデータを生成してラベル付けすることで、このギャップを埋めます。
合成データの使用例
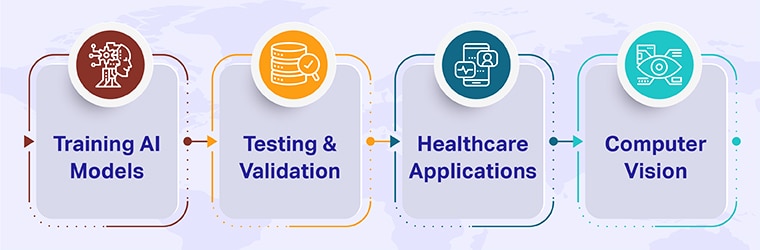
AIモデルのトレーニング
合成データは、実世界のデータが不十分または入手できない場合に、機械学習モデルのトレーニングに広く用いられています。例えば、自動運転においては、合成データセットを用いて多様な運転状況、障害物、および特殊なケースをシミュレートすることで、モデルの精度向上を図っています。
テストと検証
合成データを使用すると、開発者は AI モデルを現実世界のデータセットには存在しない可能性のあるまれなシナリオや極端なシナリオにさらすことで、AI モデルのストレス テストを行うことができます。たとえば、金融機関は合成データを使用して市場の変動をシミュレートし、不正行為を検出します。
ヘルスケア アプリケーション
医療分野では、合成データを用いることで、電子カルテ(EHR)や医用画像データなど、プライバシーに配慮したデータセットを作成することが可能になり、患者の機密性を尊重しながらAIモデルのトレーニングに利用することができる。
Computer Vision
合成データは、顔認識や物体検出などのコンピューター ビジョン アプリケーションに役立ちます。たとえば、さまざまな照明条件、角度、遮蔽をシミュレートして、ビジョンベースの AI システムのパフォーマンスを向上させることができます。
合成データの生成方法
合成データを作成するために、データ サイエンティストは、現実世界のデータセットの統計特性を再現する高度なアルゴリズムとニューラル ネットワークを使用します。
変分オートエンコーダ(VAE)
VAE は、現実世界のデータの構造を学習し、データ分布をエンコードおよびデコードすることで合成データ ポイントを生成する教師なしモデルです。
生成的敵対的ネットワーク(GAN)
GAN(敵対的生成ネットワーク)は、ジェネレーターとディスクリミネーターという2つのニューラルネットワークが連携して、非常にリアルな合成データを生成する教師あり学習モデルです。GANは、画像や動画などの非構造化データを生成するのに特に効果的です。
神経放射場(NeRF)
NeRF は、焦点を分析し、欠落している詳細を補間することで、3D 画像から合成 2D ビューを作成します。この方法は、拡張現実 (AR) や 3D モデリングなどのアプリケーションに役立ちます。
合成データのリスクと課題
合成データには数多くの利点がありますが、課題がないわけではありません。
品質への懸念
合成データの品質は、基礎となるモデルとシード データによって決まります。シード データが偏っていたり不完全だったりすると、合成データにもその欠点が反映されます。
外れ値の欠如
現実世界のデータには、モデルの堅牢性に寄与する外れ値が含まれることがよくあります。合成データは設計上、こうした異常が欠落している可能性があり、モデルの精度が低下する可能性があります。
プライバシーリスク
合成データが現実世界のデータから非常に近い形で生成されると、識別可能な特徴が不注意に保持され、プライバシーに関する懸念が生じる可能性があります。
バイアス再生
合成データは現実世界のデータに存在する過去のバイアスを再現する可能性があり、AI モデルの公平性の問題につながる可能性があります。
合成データと実データの比較
| 側面 | 合成データ | 実際のデータ |
|---|---|---|
| 費用 | コスト効率が高く拡張性が高い | 収集と注釈付けに費用がかかる |
| プライバシー | プライバシーの心配なし | 匿名化が必要 |
| エッジケース | 稀で極端なシナリオをシミュレートする | まれなイベントの報道が不足している可能性がある |
| アノテーション | 自動的にラベル付け | 手動でラベル付けが必要 |
| バイアス | シードデータからバイアスを継承する可能性がある | 歴史的偏見が含まれている可能性がある |
AIにおける合成データの未来
合成データは、一時的な解決策にとどまらず、AI イノベーションに不可欠なツールになりつつあります。合成データは、より高速で安全、かつコスト効率の高いデータ生成を可能にすることで、組織が現実世界のデータの限界を克服するのに役立ちます。
自動運転車から医療AIまで、合成データはよりスマートで信頼性の高いシステムの構築に活用されています。技術の進歩に伴い、合成データは市場動向の予測、モデルのストレステスト、未知のシナリオの探求など、新たな可能性を切り開き続けるでしょう。
結論として、合成データは AI モデルのトレーニング、テスト、展開の方法を再定義する準備ができています。合成データと実世界のデータの両方の長所を組み合わせることで、企業は正確で効率的、そして将来に備えた強力な AI システムを作成できます。