姿勢推定とは、コンピュータビジョンにおいて、身体のキーポイント(関節や顔のランドマークなど)を特定し、それらを繋ぎ合わせて、人や物体の位置や動きを記述する骨格を構築するタスクです。物理AIにとって、この骨格の動きデータは、観察された人間の動きをロボットが模倣・実行できる動作へと変換する架け橋となります。
最後の文こそ、業界の注目が静かに移ってきた点です。10年間、姿勢推定はフィットネスアプリやスポーツ中継で活用されてきました。便利ではありましたが、限界がありました。しかし今や、同じキーポイントや骨格が、ヒューマノイドロボット、自律システム、そして視覚・言語・動作モデルの中核となるトレーニング信号となっています。ロボットが物を注いだり、積み重ねたり、仕分けたり、人に手渡したりすることを学習する際、その多くは人間が最初にどのように行うかを観察することによって得られたものであり、その観察こそが姿勢データなのです。
姿勢推定が実際に捉えているもの
姿勢推定の核心は、肩、肘、手首、腰、膝、足首といった解剖学的ランドマークに加え、目、鼻、耳といった顔のポイントなど、一連のキーポイントを検出し、それらをリンクさせて姿勢と動きを表す骨格を構築することです。この骨格をフレーム間で追跡することで、身体が時間とともにどのように動くかを簡潔かつ機械可読な形で記述することができます。
この分野は、いくつかのよく知られた線に沿って分かれています。人間の姿勢推定は人間を対象としていますが、同じ技術は動物や物体にも応用できます。検出は2D(キーポイントをx、yピクセル座標として特定)または3D(深度zを追加して真の空間骨格を表現)で行うことができます。さらに、単一人物検出か複数人物検出かといったモデルレイヤーの選択肢もありますが、これらはモデルチームのアーキテクチャ上の決定事項であり、トレーニングデータの特性ではありません。姿勢モデルの成否を左右するのは検出戦略ではなく、学習したキーポイントの精度、一貫性、および網羅性です。これはデータの問題であり、チームが過小評価しがちな部分です。
姿勢データが物理AIにとって欠けている要素である理由
物理的なAIシステムは、チャットボットが決して行わないループを閉じる必要がある。つまり、世界を認識し、判断を下し、そして物理的にそれに基づいて行動するのだ。知覚能力は成熟し、ロボットは物を見ることができるようになった。難しいのは、ロボットが見たものを、協調的で物理的に正しい行動に結びつけることであり、姿勢と動作データこそがそれを可能にするものなのだ。
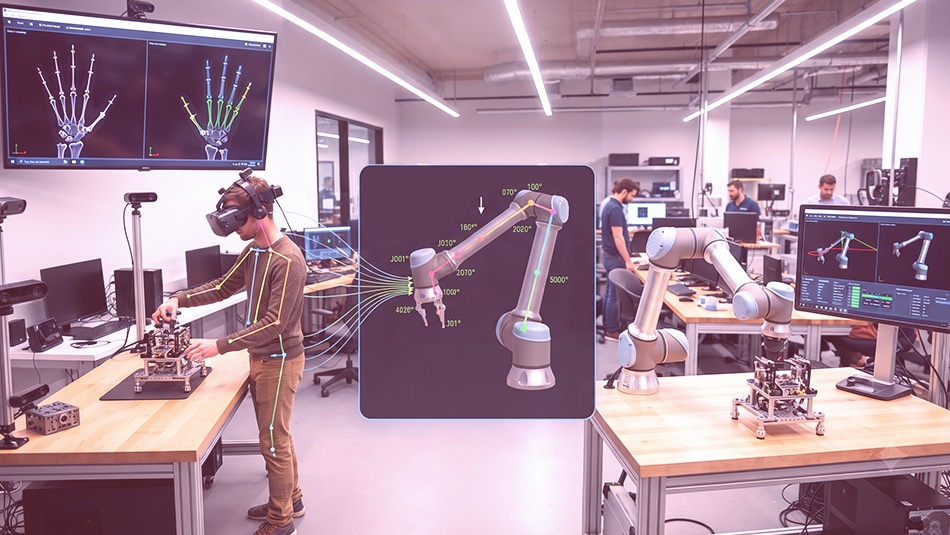
現代のロボット学習パイプラインがどのようにスキルを獲得するかを考えてみましょう。遠隔操作で撮影された実際のロボットのデモンストレーションは正確ですが、収集に時間がかかり、コストもかかります。そのため、チームはますます、はるかに豊富なデータ、つまり人間がタスクを実行するビデオで事前学習を行うようになっています。最近のロボット工学の研究では、大規模な自己中心的な人間のビデオで事前学習されたポリシーは、ロボットデータのみで学習されたポリシーよりも汎化性能が高いことが示されています。これは、人間のビデオには、実験室で収集されたロボットデータでは大規模に再現できない多様性、物理法則、タスク構造が含まれているためです。
しかし、生の人間動画はロボットが直接利用できるものではありません。ロボットは人間と全く同じ体を持っているわけではなく、独自の関節、エンドエフェクタ、自由度を持っています。姿勢推定は、その変換レイヤーです。人間の動作を構造化された骨格、特に手の骨格に還元することで、その動きをロボットの運動学に再ターゲットし、ポリシーが学習できる動作軌跡に変換できます。これこそが、視覚・言語・行動(VLA)モデルがまさに求めている入力なのです。
姿勢データは、物理AIスタック全体で3つの形式で繰り返し登場します。遠隔操作中に取得されたオペレーターの姿勢、人と安全に空間を共有する必要がある協働ロボットの作業者の姿勢、そして一人称視点の動画から抽出され、ロボットの動作に再ターゲットされた人間のデモンストレーション姿勢です。いずれの場合も、骨格の質がロボットが学習できる動作の質の限界を決定します。
モーションキャプチャからロボットモーションまで
人間の動きからロボットの動きへの橋渡しは、多くの場合、パラメトリック3Dボディモデル技術によって行われます。この技術では、全身(手も含む)を推定されたキーポイントに適合させ、通常のビデオから物理的に整合性のある動きを生成します。これは実質的にマーカーレスモーションキャプチャです。ロボット工学においては、適合させたボディが、到達、把持、持ち上げ、配置、解放といった各段階をセグメント化し、タイミングを計った、クリーンな動作軌跡のソースとなります。基となる姿勢注釈の精度が高ければ高いほど、リターゲットされた軌跡もよりクリーンになります。
2Dポーズと3Dポーズ ― あなたのロボットに本当に必要なのはどちら?
これはロボットチームが最もよく尋ねる質問であり、正直な答えは「ロボットがその姿勢とどのような関係にあるかによる」ということだ。
2D姿勢推定では、画像平面上のキーポイントが得られます。これは、形状チェック、ジェスチャー認識、動作分類には十分であり、撮影コストも安く、アノテーションも迅速です。しかし、手がマグカップからどれだけ離れているか、あるいは空間における関節の真の角度は分かりません。
3D姿勢推定では、奥行き軸を追加することで、3次元空間に配置されたメートル単位の骨格を生成します。把持、配置、接触の多い作業といった操作においては、ロボットが何かに触れる瞬間に把持点と関節角度にメートル単位の精度が必要となるため、これは通常必須となります。3次元姿勢は通常、ステレオカメラや深度カメラ、LiDAR、マルチカメラシステム、または2Dから3Dへの変換によって取得されますが、取得とアノテーションの両方でコストがかかります。
弊社がクライアントにお伝えしているルールはこうです。システムが動きを理解するだけでよい場合は、2Dで十分かもしれません。しかし、物理世界で動きを再現する必要がある場合は、3Dを想定して計画を立て、最初の把持失敗の後ではなく、最初から3Dを前提としたセンサー構成と注釈スキーマを設計してください。
手のポーズと器用さ
体の姿勢がロボットを対象物に近づける役割を果たすとすれば、手の姿勢はロボットが対象物に到達した後の動作を成功させる鍵となる。器用な操作は、指関節、接触点、把持構成のきめ細かなトラッキングに依存しており、片手につき20個以上のキーポイントが存在することが多い。物理AIの現状におけるボトルネックはまさにここにあり、アノテーションの基準が最も高いのもこの部分である。動画と手の姿勢を組み合わせたデータは、操作の学習に非常に有効であることが証明されているが、それを安定的に大量に生成するには専門的な知識が必要となる。
ポーズデータが途切れる場所
姿勢モデルは予測可能な形で失敗するが、そのほとんどすべてはアーキテクチャではなく、トレーニングデータに起因している。
- 閉塞。 手足は胴体の後ろに隠れ、手は物体の後ろに隠れ、被写体は画面から外れてしまう。隠れた重要なポイントを正直に指摘するか、推測するかによって、モデルの信頼性が左右される。
- 複数人による重複。 遺体が交差すると、重要なポイントが入れ替わったり融合したりするので、規律ある身元追跡が重要になる。
- 視点、照明、服装の違い。 清潔で正面を向き、照明が十分な画像のみで学習させたモデルは、現実世界では機能しなくなる。
- 深さの曖昧さ。 3Dポーズの場合、限られた視点から奥行きを推測することは本質的に難しく、誤った形状を教えないようにするためには、一貫した注釈付けが求められる。
- 動的な動き。 動きが速いとブレやフレーム間のずれが生じるため、キーポイントは単一フレーム内で正確であるだけでなく、時間を通して安定していなければなりません。
- 解剖学的整合性。 ある画像では手首の位置がマークされているのに、次の画像では前腕の中央の位置がマークされているという状況は、データセットを密かに汚染する。
要点は、姿勢モデルはキーポイントのあらゆる矛盾を継承し、物理AIにおいてはそれらの矛盾が誤った、場合によっては危険な動きにつながるということである。アノテーションパイプラインの規律は、データの量そのものと同じくらい重要だ。
実際のポーズパイプラインの内部:Shaipによる150,000万フレームのキーポイントプロジェクト
あるコンピュータビジョンクライアントのために、Shaipは、顔のランドマークと全身の骨格からなるカスタム36キーポイントスキーマに基づいて、 15万フレームの画像とビデオにアノテーションを付けました。このスキーマは、ポーズ推定と顔の動きの分析を1回の処理でサポートするために構築されました。作業は、さまざまなポーズ、角度、照明、服装に及び、オクルージョンは正直に処理され(隠れたランドマークはフラグ付けされ、推測されることはありませんでした)、すべてのフレームが構造化された品質保証(QA)を通過し、校正済みの精度ベンチマークに合格しました。その結果、クライアントのポーズ、モーション、フィットネス、ヘルスケア動作モデルの背後にある、すぐに使用できるパイプラインが完成しました。詳細については、当社の「人体キーポイントアノテーション」ケーススタディをご覧ください。
要点:このプロジェクトでは人間の動きのモデルを訓練したが、それに必要だった規律――緻密なカスタムスキーマ、正確なオクルージョン処理、大規模な姿勢の多様性――は、ヒューマノイドロボットや協働ロボットのポリシーに求められる規律と同じである。アプリケーションは変わっても、データの標準は変わらない。
姿勢推定のユースケース:実世界における応用例
姿勢と動作データは、ロボット工学の枠を超えて様々なシステムの学習に活用されており、各分野が独自のキーポイントスキーマと精度基準を設定している。物理AIチームにとって有益な洞察は、これらが同一の資産、すなわち身体性知能へと転用可能な高精度な人間動作データの重複する情報源であるということだ。
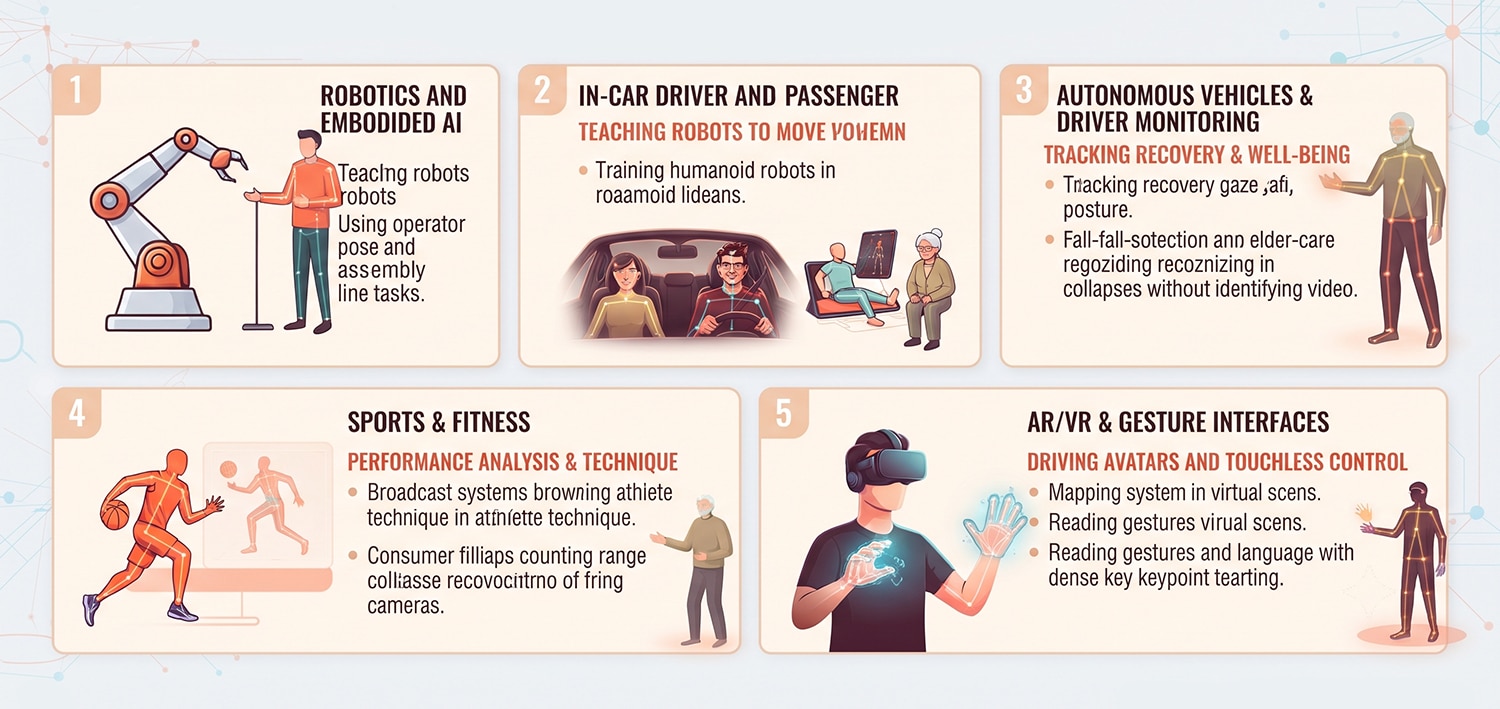
ロボット工学と身体化されたAI――それが最先端分野だ。姿勢データは、人間のデモンストレーションから学習することでロボットの動き方を教える。倉庫でコンテナを持ち上げてコンベアに載せる動作を学習するヒューマノイドロボットは、同じ作業を行う人々の姿勢追跡ビデオを部分的に学習し、遠隔操作セッションからのオペレーターの姿勢データによって正確な動作軌道が提供される。組立ラインでは、協働ロボットがリアルタイムの作業員の姿勢データを使用して安全な距離を保ち、衝突することなく部品を手渡す。こうしたコンテナの取り扱いやラインサイド作業は、現在、物流工場や自動車工場で試験的に導入されている。
自動運転車とドライバーモニタリング。車内では、姿勢推定によってドライバーの頭の位置、視線、上半身の姿勢を追跡し、眠気や注意散漫を検知します。Euro NCAPの2026年安全評価基準を満たすために新車に搭載されるドライバーモニタリングシステムは、まさにこの顔のランドマークとキーポイントのデータに依存しています。
医療とリハビリテーション。姿勢推定は、身体が実際にどのように動くかを測定するもので、臨床医はこれを利用して回復状況を追跡します。理学療法アプリは、スマートフォンのカメラを通して患者の運動を観察し、可動域を計測し、不適切なフォームを警告することができます。高齢者介護施設における転倒検知システムは、識別可能な動画を保存することなく、骨格の動きだけで転倒を検知できます。
スポーツとフィットネス。骨格追跡技術によって、普通の映像がパフォーマンスデータへと変換される。放送局はアスリートの体にリアルタイムの骨格画像を重ね合わせて技術を分析する一方、一般消費者向けのフィットネスアプリはスマートフォンのカメラだけで反復回数をカウントし、正しいフォームを指導する。
AR/VRとジェスチャーインターフェース。身体と手のポーズによってアバターが動き、非接触操作が可能になります。手を仮想シーンにマッピングするヘッドセットや、ジェスチャーや手話を読み取るインターフェースは、強い自己遮蔽下における高密度な手のキーポイントトラッキングに依存しています。
ポーズおよびキーポイントデータパートナーの選択
姿勢データの構築をどのベンダーに依頼すべきかを検討する際、ベンダーを区別する基準となるのは、表面的なものではなく、運用上の問題です。