コードに基づいて動作するソフトウェア開発と同様に、実用的な人工知能および機械学習モデルの開発には、高品質のデータが必要です。アルゴリズムはタスクを実行するために継続的にトレーニングする必要があるため、モデルには、生産の複数の段階で正確にラベル付けされ、注釈が付けられたデータが必要となります。
しかし、質の高いデータを入手するのは容易ではありません。データセットには、プロジェクトの成果に影響を与える可能性のあるエラーが含まれている場合もあります。データサイエンスの専門家は、データの評価や分析よりも、データのクリーニングやスクラブに多くの時間を費やしていると口を揃えるでしょう。
そもそもデータセットにエラーが存在するのはなぜですか?
正確なトレーニングデータセットが不可欠なのはなぜですか?
AIトレーニングデータのエラーにはどのような種類がありますか?また、それらを回避するにはどうすればよいでしょうか?
いくつかの統計から始めましょう。
マサチューセッツ工科大学(MIT)コンピュータ科学・人工知能研究所の研究者グループは、10万回以上引用されている10個の大規模データセットを精査した。その結果、分析対象となったすべてのデータセットにおける平均エラー率は約3.4%であることが判明した。また、これらのデータセットには、画像、音声、テキストの感情分析におけるラベル付けミスなど、様々な種類のエラーが含まれていることも明らかになった。
そもそもデータセットにエラーが存在するのはなぜですか?

たとえば、オフィスアシスタントに、すべてのロケーションビジネスに関する完全な詳細を収集し、それらをスプレッドシートに手動で入力するように依頼することを想像してみてください。 いずれかの時点で、エラーが発生します。 アドレスが間違ったり、重複が発生したり、データの不一致が発生したりする可能性があります。
機器の故障、センサーの劣化、または修理のためにセンサーによって収集された場合にも、データのエラーが発生する可能性があります。
正確なトレーニングデータセットが不可欠なのはなぜですか?
すべての機械学習アルゴリズムは、提供されたデータから学習します。ラベル付けされ、注釈が付けられたデータは、モデルが関係性を見つけ、概念を理解し、意思決定を行い、パフォーマンスを評価するのに役立ちます。コストやトレーニングに必要な時間を気にすることなく、エラーのないデータセットで機械学習モデルをトレーニングすることが不可欠です。長期的に見れば、質の高いデータの取得に費やす時間は、AIプロジェクトの成果を高めることにつながります。
正確なデータでモデルをトレーニングすることで、モデルの予測精度が向上し、パフォーマンスも向上します。データの質、量、そして使用するアルゴリズムが、AIプロジェクトの成否を左右します。
AIトレーニングデータエラーの種類は何ですか?
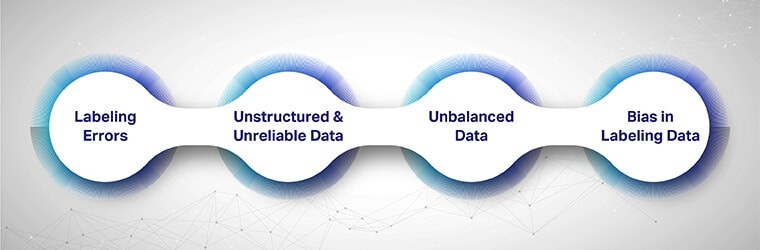
ラベル付けエラー、信頼性の低いデータ、不均衡なデータ、データバイアス
最も一般的なXNUMXつのトレーニングデータエラーとそれらを回避する方法を見ていきます。
ラベル付けエラー
ラベル付けエラーは、トレーニングデータで最もよく見られるエラーの一つです。モデルのテストデータに誤ったラベル付けのデータセットが含まれている場合、得られるソリューションは役に立ちません。データサイエンティストは、モデルのパフォーマンスや品質について、正確で意味のある結論を導き出すことができなくなるでしょう。
ラベル付けエラーにはさまざまな形式があります。 簡単な例を使用して、要点をさらに詳しく説明します。 データアノテーターが画像内の各猫の周りに境界ボックスを描画するという単純なタスクを持っている場合、次のタイプのラベル付けエラーが発生する可能性があります。
- 不正確な適合:モデルの過剰適合 バウンディングボックスがオブジェクト(猫)の近くに描画されておらず、意図したものの周りにいくつかのギャップが残っている場合に発生します。
- ラベルがありません: この場合、アノテーターは画像内の猫のラベル付けを見逃す可能性があります。
- 指示の誤解: アノテーターに提供される指示は明確ではありません。 画像内の各猫の周りにXNUMXつのバウンディングボックスを配置する代わりに、アノテーターはすべての猫を囲むXNUMXつのバウンディングボックスを配置します。
- オクルージョン処理: アノテーターは、猫の見える部分の周りにバウンディングボックスを配置する代わりに、部分的に見える猫の予想される形状の周りにバウンディングボックスを配置します。
非構造化データと信頼性の低いデータ
MLプロジェクトの範囲は、トレーニング対象のデータセットのタイプによって異なります。 企業は、リソースを使用して、更新され、信頼性が高く、必要な結果を表すデータセットを取得する必要があります。
更新されていないデータでモデルをトレーニングすると、アプリケーションに長期的な制限が生じる可能性があります。 不安定で使用できないデータでモデルをトレーニングすると、AIモデルの有用性が反映されます。
不均衡なデータ
データの不均衡は、モデルのパフォーマンスにバイアスを引き起こす可能性があります。 高性能または複雑なモデルを構築する場合は、トレーニングデータの構成を慎重に検討する必要があります。 データの不均衡には、次のXNUMXつのタイプがあります。
- クラスの不均衡: クラスの不均衡は、 トレーニングデータ 非常に不均衡なクラス分布を持っています。 つまり、代表的なデータセットはありません。 データセットにクラスの不均衡がある場合、実際のアプリケーションでビルドするときに多くの問題が発生する可能性があります。
たとえば、アルゴリズムが猫を認識するようにトレーニングされている場合、トレーニングデータには壁に猫の画像しかありません。 その場合、モデルは壁の猫を識別するときにうまく機能しますが、さまざまな条件下ではうまく機能しません。 - データの最新性: 完全に最新のモデルはありません。 すべてのモデルは、 現実の世界 環境は絶えず変化しています。 これらの環境変化についてモデルが定期的に更新されない場合、その有用性と価値は低下する可能性があります。
たとえば、最近まで、スプートニクという用語をざっと検索すると、ロシアのロケットに関する結果が表示されていた可能性があります。 ただし、パンデミック後の検索結果は完全に異なり、ロシアのCovidワクチンで満たされます。
ラベル付けデータのバイアス
トレーニングデータの偏りは、時々発生し続けるトピックです。 データの偏りは、ラベリングプロセス中またはアノテーターによって引き起こされる可能性があります。 データバイアスは、アノテーターのかなりの異種チームを使用する場合、またはラベル付けに特定のコンテキストが必要な場合に発生する可能性があります。
世界各地のアノテーター、あるいは地域に特化したアノテーターに作業を依頼することで、バイアスを軽減することが可能です。世界各地のデータセットを使用する場合、アノテーターがラベル付けに誤りを犯す可能性が高くなります。
たとえば、世界中のさまざまな料理を扱っている場合、英国のアノテーターはアジア人の食べ物の好みに精通していない可能性があります。 結果として得られるデータセットには、英語を支持するバイアスがあります。
AIトレーニングデータエラーを回避する方法は?
トレーニングデータエラーを回避する最善の方法は、ラベリングプロセスのすべての段階で厳格な品質管理チェックを実装することです。
アノテーターに明確かつ正確な指示を与えることで、データラベル付けのエラーを回避できます。これにより、データセットの均一性と正確性を確保できます。
データセットの偏りを避けるため、最新かつ更新された、代表的なデータセットを入手してください。機械学習モデルのトレーニングとテストを行う前に、データセットが新規かつ未使用であることを確認してください。
強力なAIプロジェクトが最高のパフォーマンスを発揮するには、新鮮で偏りのない、信頼性の高いトレーニングデータが不可欠です。ラベル付けとテストの各段階で、さまざまな品質チェックと対策を講じることが極めて重要です。トレーニングエラーは、プロジェクトの成果に影響を与える前に特定して修正しなければ、重大な問題となる可能性があります。
機械学習プロジェクトにおいて質の高いAIトレーニングデータセットを確保する最善の方法は、プロジェクトに必要な専門知識と経験を持つ、多様なアノテーターを雇用することです。
Shaipの経験豊富なアノテーターチームは、多様なAIプロジェクト向けにインテリジェントなラベリングおよびアノテーションサービスを提供しており、迅速な成功を実現します。ぜひお電話ください。AIプロジェクトの品質とパフォーマンスを確実に向上させます。