AI、ビッグデータ、機械学習は、世界中の政策立案者、企業、科学界、メディア、そして様々な産業に影響を与え続けています。報告によると、AIの世界的な導入率は2022年時点で35%に達しており、2021年から4%も増加しています。さらに、企業の42%がAIのビジネスにおける多くのメリットを模索しているとのことです。
数多くのAIイニシアチブや機械学習ソリューションを支えているのはデータです。AIの性能は、アルゴリズムに供給されるデータの質に左右されます。質の低いデータは、質の低い結果や不正確な予測につながる可能性があります。
機械学習(ML)や人工知能(AI)ソリューションの開発には多くの注目が集まっている一方で、質の高いデータセットとは何かという認識が欠けている。本稿では、質の高いAIトレーニングデータの歴史を辿り、データ収集とトレーニングの理解を通してAIの未来像を明らかにする。
AI トレーニング データの定義
ML ソリューションを構築する場合、トレーニング データセットの量と質が重要です。 ML システムは、大量の動的で偏りのない貴重なトレーニング データを必要とするだけでなく、大量のトレーニング データも必要とします。
しかし、AI トレーニング データとは何ですか?
AI トレーニング データは、正確な予測を行うために ML アルゴリズムをトレーニングするために使用されるラベル付きデータのコレクションです。 ML システムは、パターンを認識して識別し、パラメーター間の関係を理解し、必要な決定を下し、トレーニング データに基づいて評価しようとします。
たとえば、自動運転車の例を見てみましょう。 自動運転 ML モデルのトレーニング データセットには、車、歩行者、道路標識、その他の車両のラベル付き画像と動画を含める必要があります。
つまり、ML アルゴリズムの品質を向上させるには、適切に構造化され、注釈が付けられ、ラベル付けされた大量のトレーニング データが必要です。
高品質のトレーニング データの重要性とその進化
高品質のトレーニング データは、AI および ML アプリの開発における重要なインプットです。 データはさまざまなソースから収集され、機械学習の目的には適さない整理されていない形式で表示されます。 ラベル付け、注釈付け、タグ付けされた高品質のトレーニング データは常に整理された形式であり、ML トレーニングに最適です。
高品質のトレーニング データを使用すると、ML システムがオブジェクトを認識し、事前に定義された特徴に従ってそれらを分類しやすくなります。 分類が正確でない場合、データセットは悪いモデル結果をもたらす可能性があります。
AI トレーニング データの黎明期
AIが現在のビジネス界や研究界を席巻しているにもかかわらず、機械学習が人工知能を支配する以前の初期の時代は、全く異なっていた。
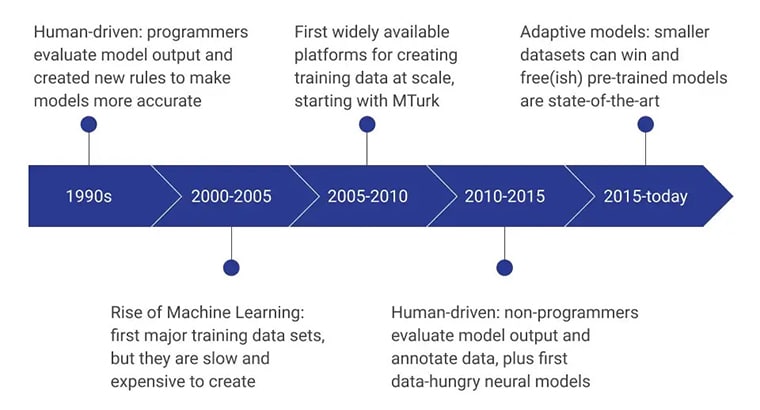
次の数年間は、非プログラマーによるデータ モデルの作成と評価に焦点が当てられました。 現在、高度なトレーニング データ収集方法を使用して開発された事前トレーニング済みモデルに焦点が当てられています。
質より量
かつて、データサイエンティストはAIトレーニングデータセットの信頼性を評価する際、質よりも量に重点を置いていた。
たとえば、大規模なデータベースが正確な結果を提供するという一般的な誤解がありました。 データの膨大な量は、データの価値を示す良い指標であると考えられていました。 量は、データセットの価値を決定する主要な要因の XNUMX つにすぎません。データ品質の役割が認識されました。
データ品質は、データの完全性、信頼性、妥当性、可用性、および適時性に依存するという認識が高まった。最も重要なのは、プロジェクトに対するデータの適合性が、収集されたデータの品質を決定づけるということである。
不十分なトレーニング データによる初期の AI システムの制限
不十分なトレーニング データは、高度なコンピューティング システムの欠如と相まって、初期の AI システムのいくつかの約束が果たされなかった理由の XNUMX つです。
質の高いトレーニング データが不足しているため、ML ソリューションは視覚パターンを正確に特定できず、ニューラル研究の発展を妨げていました。 多くの研究者が音声言語認識の可能性を認識していましたが、音声データセットが不足しているため、音声認識ツールの研究や開発は実現できませんでした。 ハイエンドの AI ツールを開発する際のもう XNUMX つの大きな障害は、コンピューターの計算能力とストレージ能力の欠如でした。
高品質のトレーニング データへの移行
データセットの品質が重要であるという認識に顕著な変化がありました。 ML システムが人間の知性と意思決定能力を正確に模倣するためには、大量の高品質のトレーニング データで成功する必要があります。
機械学習データはアンケート調査のようなものだと考えてください。データサンプルのサイズが大きいほど、予測精度は高くなります。サンプルデータにすべての変数が含まれていない場合、パターンを認識できなかったり、不正確な結論を導き出したりする可能性があります。
AI 技術の進歩とより良いトレーニング データの必要性

より良いトレーニング データが信頼できる ML モデルの可能性を高めるという理解は、より良いデータ収集、注釈、およびラベル付けの方法論を生み出しました。 データの品質と関連性は、AI モデルの品質に直接影響を与えました。

データの品質と精度への関心の高まり
ML モデルが正確な結果を提供し始めるために、反復的なデータ調整ステップを経る高品質のデータセットが提供されます。
たとえば、人間は特定の犬種を写真、ビデオ、または直接紹介されてから数日以内に認識できる場合があります。 人間は自分の経験と関連する情報から引き出して、必要に応じてこの知識を記憶し、引き出します。 しかし、機械にとってはそう簡単には機能しません。 マシンは、その特定の品種と他の品種の明確な注釈とラベル付きの画像 (数百または数千) を入力して、接続を確立する必要があります。
AIモデルは、学習データと現実世界で提示された情報を関連付けることで結果を予測します。学習データに関連情報が含まれていない場合、このアルゴリズムは役に立ちません。
多様で代表的なトレーニングデータの重要性
データセットは、特定の人口、人種、性別、選択、知的意見に偏り、モデルが不正確になる可能性があります。
被験者プールの選択、キュレーション、注釈、ラベル付けを含むデータ収集プロセス全体の流れが、適切に多様で、バランスが取れており、母集団を代表していることを確認することが重要です。

AI トレーニング データの未来
AI モデルの将来の成功は、ML アルゴリズムのトレーニングに使用されるトレーニング データの質と量にかかっています。 このデータの質と量の関係はタスク固有のものであり、明確な答えがないことを認識することが重要です。
最終的に、トレーニング データ セットの妥当性は、構築された目的に対して確実に適切に機能する能力によって定義されます。
データ収集と注釈技術の進歩
ML はフィードされたデータに敏感であるため、データ収集と注釈ポリシーを合理化することが不可欠です。 データ収集、キュレーション、虚偽表示、不完全な測定、不正確なコンテンツ、データの重複、および誤った測定におけるエラーは、不十分なデータ品質の一因となります。
データ マイニング、Web スクレイピング、およびデータ抽出による自動データ収集は、より高速なデータ生成への道を開いています。 さらに、事前にパッケージ化されたデータセットは、迅速なデータ収集手法として機能します。
クラウドソーシングは、データ収集におけるもう一つの画期的な手法です。データの正確性を保証することはできませんが、世論を把握するための優れたツールとなります。また、専門的なデータ収集の専門家が、特定の目的に合わせたデータ収集を行うこともあります。
トレーニング データにおける倫理的配慮の重要性が高まる
現在、データには顔画像、指紋、音声録音、その他の重要な生体認証データが含まれているため、費用のかかる訴訟や評判への損害を回避するために、法的および倫理的な慣行を確実に遵守することが非常に重要になっています。
将来的にはさらに質の高い多様なトレーニング データの可能性
将来、高品質で多様なトレーニングデータが得られる可能性は非常に大きい。これは、データ品質への意識の高まりと、AIソリューションの品質要求に応えるデータプロバイダーの存在によるものだ。
現在のデータ プロバイダーは、画期的なテクノロジを使用して、倫理的かつ合法的に膨大な量の多様なデータセットを調達することに長けています。 また、さまざまな ML プロジェクト用にカスタマイズされたデータにラベルを付け、注釈を付け、提示するための社内チームもあります。

結論
高度なAIモデルを開発するには、データと品質に対する深い理解を持つ信頼できるベンダーと提携することが重要です。Shaipは、お客様のAIプロジェクトのニーズと目標を満たすカスタマイズされたデータソリューションを提供する、業界トップクラスのアノテーション企業です。ぜひ当社と提携し、当社の能力、コミットメント、そして協業体制をご体験ください。