強化学習(RL)は、報酬信号が明確で環境が寛容な場合に、何をすべきかを学習するのに非常に優れています。しかし、現実世界の多くの状況はそうではありません。複雑で、リスクが高く、「ほぼ正解」の判断が数多く存在します。そこで、専門家が検証した推論データセットが大きな効果を発揮します。これらのデータセットは、モデルに結果だけでなく、行動の背後にある理由を教えるからです。
RLパフォーマンスの隠れたボトルネック:弱い推論信号
RLエージェントは、トレーニングでは優れたパフォーマンスを発揮するように見えても、実際にデプロイすると失敗することがあります。よくある理由の一つは、モデルが近道を学習してしまうことです。近道とは、慣れ親しんだシナリオでは報酬を獲得できるものの、状況が変化すると機能しなくなるパターンです。
RL システムを出荷したことがある人ならわかるミニストーリーを次に示します。
倉庫ロボット開発チームは、商品のピッキングと配置を行うエージェントを訓練した。シミュレーションでは成功率は急速に上昇した。しかし、実際の現場では、ロボットはシミュレーターではうまくいくものの、反射面付近で衝突を引き起こすような危険な軌道を描き始め、設定を「悪用」し始めた。報酬関数自体は間違っていなかった。モデルが学習した推論が不完全だったのだ。
データが結果(「成功/失敗」またはスカラー報酬)のみをキャプチャする場合、制約、安全性チェック、およびステップの順序付けなど、人間が本能的に使用する中間決定ロジックが失われます。
「専門家による検証済みの推論データ」に実際に含まれるもの
実用的なレベルでは、専門家が検証した推論データとは、ドメイン専門家が最終結果だけでなく意思決定のパスも検証した、厳選された一連の例です。
推論の痕跡:ミッシングミドル
推論トレースとは、観察→意思決定→行動という段階的なルートです。ユースケースによっては、以下のような形になるかもしれません。
- 関連する信号を特定する(「センサードリフトが検出されました。信頼性が低下しました」)
- ドメインルールを適用する(「進入前に譲る、歩行者を優先する」)
- 制約付きで行動を選択する(「盲点を避けるためにパスBを選択する」)
「審査済み」の意味(平易な英語で)
「審査済み」には通常、次のものが含まれます。
- 専門家が執筆またはレビューしたガイドライン
- 一貫したラベル付けルーブリック(2人の専門家が同じケースを同様に解決できるようにするため)
- 矛盾や手順の不足を体系的にチェックする
- ガイドラインの進化に伴う変更の監査証跡
これが重要なのは、小さな論理エラーが連鎖的に発生する可能性があるためです。特に、後で報酬モデルをトレーニングしたり、人間のフィードバック ループを使用したりする場合は注意が必要です。
推論データセットが強化学習モデルのパフォーマンスを向上させる仕組み
メリットは神秘的なものではなく、物理的なものです。
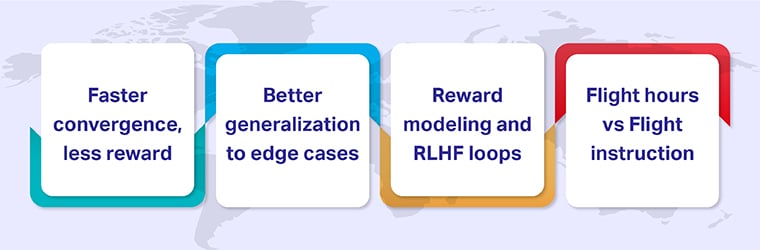
収束が速くなり、報酬ハッキングが減少
推論トレースは探索空間を縮小します。エージェントは盲目的に探索するのではなく、どの中間ステップが有効であるかに関する構造化された信号を受け取ります。これは通常、行き止まりで無駄になるトレーニング反復が減り、報酬関数の「巧妙な」利用が減ることを意味します。
RLHFと報酬モデリングに関する研究では、ノイズの多い、あるいは質の低い選好/フィードバックデータに対して、訓練がいかに敏感になり得るかが繰り返し強調されています(出典:Association for Computational Linguistics, 2024)。この敏感さはRLにおいて消えるのではなく、むしろ増幅されます。
エッジケースへのより優れた一般化
専門家の推論は、安全境界、コンプライアンス規則、因果関係といった、適用可能な制約と原則を符号化する。環境が変化しても、ピクセル、テキスト、状態遷移の正確な形状が変わっても、これらの原則は依然として有効である。
より安定した報酬モデリングとRLHFループ
RLHFスタイルのトレーニング後処理を使用している場合、推論データはより優れた報酬モデルの構築に役立ちます。報酬モデルは「適切な回答」だけでなく「適切な意思決定パス」も評価できるようになるためです。これは、最適化中の更新の一貫性が向上し、トレーニングのスケール変更時に回帰が減少することにつながります。
RLHFパイプラインを構築または拡張する場合、ShaipのRLHFソリューションは、専門家主導のワークフローと品質管理に基づいて設計されており、一貫性のあるアライメントデータをサポートします。
例え話:飛行時間と飛行訓練
強化学習のトレーニングは、パイロットの訓練に似ていると考えてください。シミュレーターで何時間も練習することはできますが、間違った習慣を身につけてしまうと、それが強化されてしまいます。教官は単に「合格/不合格」を告げるだけではありません。飛行中に、スキャン順序、意思決定のタイミング、リスク処理など、推論を修正してくれます。専門家によって検証された推論データセットは、強化学習においてまさにその「教官」の役割を果たします。つまり、モデルが着陸できたかどうかだけでなく、タスクをどのように考え抜くかを教えるのです。
比較表: 社内 vs クラウドソーシング vs アウトソーシングの審査モデル
ほとんどのチームは最終的にハイブリッドになりますが、トレードオフについて明確にしておくと役立ちます。
RLおよびRLHFパイプラインに接続する、より広範なラベリングニーズに対して、Shaipのデータアノテーションサービスは、ガイドラインの設計から多段階の品質保証まで、あらゆることをサポートします。特に、大規模な環境で再現性のある品質が必要な場合に最適です。
専門家による検証済みの推論データセットのための実用的なQCプレイブック
ここに、高パフォーマンスのチームが実践している内容を示すプレイブックがあります。
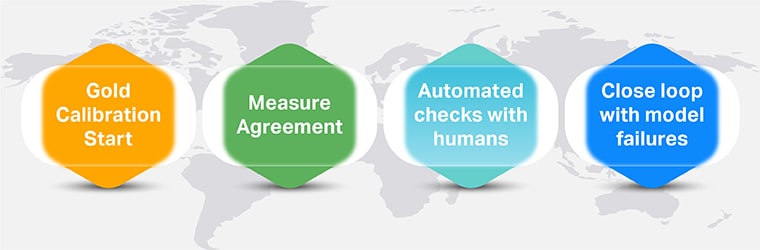
1. 「ゴールド」とキャリブレーションから始める
標準的な例(難しいエッジケースも含む)のゴールドセットを作成します。これを用いて、注釈者を調整し、「適切な推論」とはどのようなものか専門家間で認識を一致させます。
2. 合意を測定し、不一致を適切に解決する
適切な場合には、アノテーター間の合意を活用し(本質的に曖昧なケースでは合意を強制しない)、仲裁を行うことが重要です。意見の相違は、単なるコイン投げのようなラベル付けではなく、より良いガイドラインを生み出すべきです。
3. 自動チェックを導入するが、人間による管理は維持する
検証が安価なものを自動化します。
- フォーマットの一貫性(ステップ数、スキーマの妥当性)
- ルール違反(制約の不足、禁止されたアクション)
- 矛盾検出(ステップでは「A」と言っているが、後で「Aではない」と示唆している)
フラグが付けられた項目は専門家によるレビューに回されます。ここで、人間とAIによるハイブリッドQCが効果を発揮します。機械が「明らかな間違い」を検知し、専門家が「微妙な間違い」を修正します。
4. モデルの失敗をループで閉じる
デプロイメントの失敗はデータセットのフィードバックとして扱います。モデルが失敗した場合は、次の点を検討します。
- 推論トレースに制約が欠けていましたか?
- ガイドラインではエッジケースが十分に指定されていませんか?
- 私たちは「ハッピーパス」ロジックに過剰適合したのでしょうか?
このループによって、データセットは一度限りの成果物ではなく、常に活用される資産へと変化します。データパイプラインをエンドツーエンド(収集→品質保証→配信)で構築するチームにとって、ShaipのAIトレーニングデータサービスは、このプロセスを継続的に運用するのに役立ちます。
意思決定フレームワーク:適切な審査戦略を選択する方法
次の 6 つの質問を参考にして、社内サービス、クラウド サービス、マネージド サービスの適切な組み合わせを選択してください。