新しい従業員を雇う場面を想像してみてください。一人の候補者は「何でも屋」で、あらゆる分野を少しは知っているものの、深くは知らないタイプです。もう一人は、まさにあなたの業界で10年の経験を持っています。あなたは、重要なビジネス上の意思決定を誰に任せられるでしょうか?
これが、汎用大規模言語モデル(LLM)とドメイン特化型LLMの違いです。GPT-4やGeminiのような汎用モデルは幅広く柔軟性がありますが、ドメイン特化型LLMは、医学、法律、金融、工学といった特定の分野向けに訓練または微調整されています。
この記事では、ドメイン固有の LLM とは何か、実際の例、構築方法について説明し、その利点と制限の両方について説明します。
ドメイン固有 LLM とは何ですか?
ドメイン特化型言語モデル(LLM)とは、汎用的な言語理解ではなく、特定の専門分野で優れた性能を発揮するように最適化されたAIモデルです。これらのモデルは、多くの場合、対象ドメインから厳選されたデータセットを用いて、大規模な基盤モデルを微調整することで作成されます。
👉スイスアーミーナイフとメスを想像してみてください。一般的なLLMは、多くのタスクをそこそここなすことができます(スイスアーミーナイフのように)。一方、専門分野に特化したLLMは、鋭く、精密で、特定の作業のために作られています(メスのように)。
ドメイン特化型LLMの例
ドメイン特化モデルはすでに業界全体で大きな話題になっています。
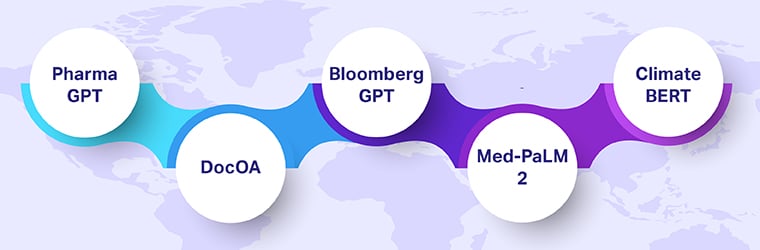
- ファーマGPT – バイオ医薬品と創薬に焦点を当てたモデル。最近の研究(arXiv:2406.18045)によると、このモデルは より高い精度 GPT-4 よりも少ないリソースを使用しながら、生物医学タスクを実行します。
- ドコア – 変形性関節症向けにカスタマイズされた臨床モデル。2024年にベンチマークテスト(arXiv:2401.12998)を実施したところ、専門的な医学的推論タスクにおいて一般的な法学修士課程の成績を上回りました。
- ブルームバーグGPT – 金融市場向けに構築され、公開されている金融文書と独自のデータセットを組み合わせて学習されています。投資リサーチ、コンプライアンス、リスクモデリングをサポートします。
- Med-PaLM 2 – Google DeepMind によって開発されたこのヘルスケアに特化したモデルは、医療試験の質問に回答する際に最先端の精度を実現します。
- 気候BERT – 気候科学文献に基づいてトレーニングされた言語モデル。研究者が持続可能性レポートや気候情報開示を分析するのに役立ちます。
これらはいずれも、特定の分野において、高度な専門化がいかに汎用性の高い巨大企業を凌駕できるかを示している。
ドメイン特化型LLMの利点
なぜ企業は独自のドメインLLMの構築を急いでいるのでしょうか? 主な利点として、次のようなものが挙げられます。
ドメイン特化型LLMの構築方法
すべての人に当てはまるアプローチはありませんが、プロセスには通常、次の主要な手順が含まれます。
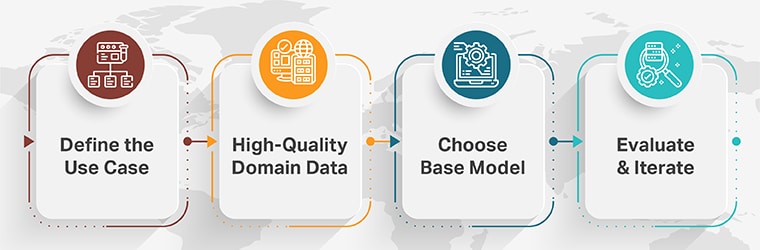
1. ユースケースを定義する
目標が顧客サポート、コンプライアンス監視、創薬、法的分析、またはその他の分野固有のタスクのいずれであるかを特定してください。
2. 高品質なドメインデータをキュレーションする
業界関連の注釈付きデータセットを収集しましょう。ここでは量より質が重要です。小さくても質の高いデータセットは、大きくてもノイズの多いデータセットよりも優れた結果をもたらすことがよくあります。
3. ベースモデルを選択する
一般的な基礎モデル (LLaMA、Mistral、GPT-4 など) から始めて、ドメインに合わせて調整します。
- 微調整: 重みを調整するためにドメイン固有のデータでトレーニングします。
- 検索拡張生成 (RAG): リアルタイムのグラウンディングのためにモデルを知識ベースに接続します。
- 小規模LLM(SLM): 効率的でありながら高度に専門化されたコンパクトなモデルをトレーニングします。
4. 評価と反復
汎用LLMとのベンチマークを行い、精度の向上を確実にします。幻覚発生率、レイテンシ、コンプライアンス指標を追跡します。
ドメイン特化型LLMと汎用型LLM
ドメイン特化型モデルは、汎用型モデルと比べてどうでしょうか?比較してみましょう。