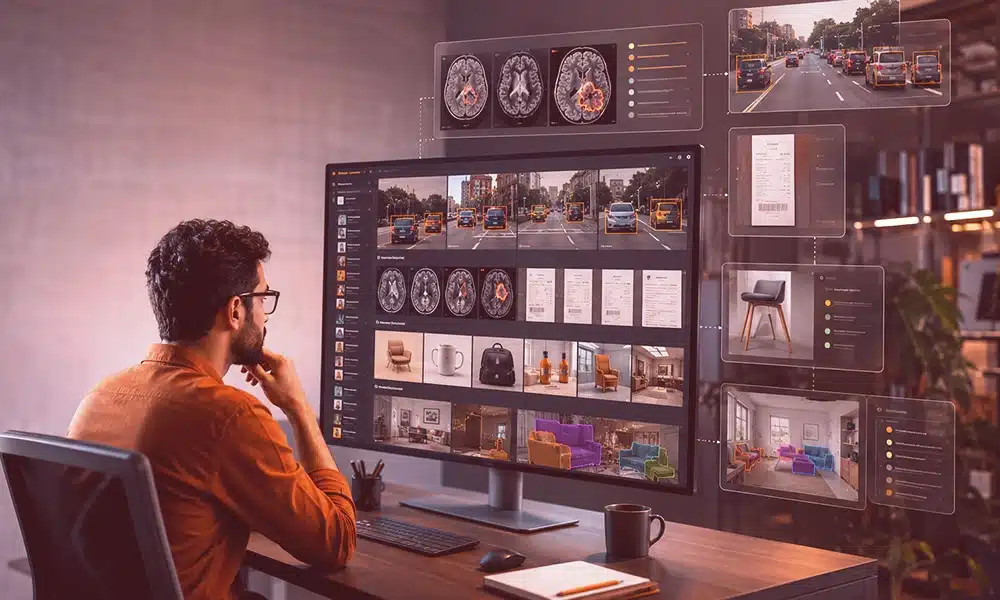
コンピュータビジョンモデルの精度は、学習に使用する画像の精度に左右されます。クリーンでラベル付けの適切なデータセットを与えれば、腫瘍の検出、レシートの読み取り、自動運転車の車線維持などを学習できます。しかし、ノイズの多いデータセットを与えれば、誤った結果を出すばかりです。そのため、多くの初心者チームにとって、コンピュータビジョンに適した画像データセットは、モデルアーキテクチャよりも重要であり、カスタムデータに投資する前にプロトタイプを作成する最速の方法として、無料のオープンソースデータセットが依然として有効なのです。
以下に、タスクごとにグループ化された最も有用なオープンソースデータセット22個と、その中から1つを選ぶ方法、そしてこのリスト以外を探す場所についての簡単なガイドを示します。世界のコンピュータビジョン市場は2025年に207億5000万ドルと評価され、2026年の241億4000万ドルから2034年には728億ドルに成長すると予測されているため(Fortune Business Insights、2025年)、高品質のトレーニング画像の需要は高まる一方です。
主要なポイント(要点)
- オープンソースの画像データセット カスタムデータを作成する前に、コンピュータビジョンモデルを無料で試作できます。
- データセットをタスクに合わせてください。分類、検出、セグメンテーションなど、それぞれ異なるラベルが必要です。
- ImageNet、COCO、Open Imagesといったベンチマークデータセットは、依然として業界標準となっている。
- 無料のデータセットは、あなたの用途に完全に合致することは稀です。カスタムデータ取得の手順を計画しましょう。
コンピュータビジョンにおける画像データセットとは何ですか?
コンピュータビジョン用の画像データセットは、視覚情報を解釈するモデルの学習と検証に使用される、ラベル付けされた画像の体系的なコレクションです。各画像には、アルゴリズムが何を見ているのかを学習するための注釈(クラスラベル、バウンディングボックス、ピクセルレベルのマスクなど)が付与されています。注釈は、生のピクセルを教師あり学習信号に変換するラベル付けレイヤーです。注釈がなければ、モデルは画像を持っていても、そこから学ぶべき教訓を得ることができません。
画像データセットのタスク: 分類、セグメンテーション、検出など

画像分類は、コンピュータビジョンにおける最も基本的なタスクの一つです。このプロセスでは、モデルは画像の内容に基づいて画像全体にラベルを割り当てることを学習します。例えば、画像分類データセットは、モデルが猫と犬の画像を区別したり、異なる種類の植物を識別したりするのに役立ちます。このタスクは、写真の自動タグ付け、医療画像からの疾患診断、シーン分類ベンチマークなどのアプリケーションにとって非常に重要です。
物体検出は、画像内の物体の存在を識別するだけでなく、境界ボックスを用いてその位置を特定することで、さらに一歩進んだ技術です。境界ボックス付きの注釈付き画像を含むような物体検出用データセットは、自動運転車における歩行者検出、セキュリティ監視、小売分析といったアプリケーションにとって不可欠です。また、物体検出は、現実世界のシナリオに対応した堅牢なコンピュータビジョンアルゴリズムを開発する上でも重要な要素となります。

セマンティックセグメンテーションとは、画像内の各ピクセルを特定のカテゴリに分類することで、シーンの詳細な理解を得る手法です。このピクセルレベルのトリマップセグメンテーションは、臓器や腫瘍の正確な輪郭抽出が求められる医療画像処理や、道路、歩道、車両の区別が重要な自動運転などの都市環境において特に重要です。
汎用性の高い画像データセットとして最適なものは何ですか?
一般的なデータセットとは、モデルのベンチマークや、より狭いタスクでの微調整を行う前にネットワークを事前学習するために使用される、大規模で広範なラベル付けが施されたデータの集合体です。
- ImageNet — 1,000のカテゴリにわたる1.2万枚の画像。WordNetの階層構造に基づいて整理されている。現代のディープラーニングの礎となったベンチマーク。
- Google Open Images V7 約9万枚の画像に、ラベル、ボックス、セグメンテーション、および関係性に関する注釈が600種類以上のオブジェクトクラスにわたって付与されている。
- CIFAR-10 — 10種類のクラスに分類された、60,000万枚の小さな32×32ピクセルのカラー画像。手軽な実験のための標準的なスターターセットです。
- オックスフォード-IIIT ペットデータセット — 37種類のペットの品種について、品種ラベル、頭部ボックス、ピクセルレベルのトリマップ分割が提供されています。
- SA-1B(セグメント・エニシング) — 1.1万枚以上の画像と11億個のマスクを含む、入手可能な最大のセグメンテーションデータセット。
- ADE20K — 25,000枚以上の高密度に注釈が付けられたシーン画像。これはセマンティックセグメンテーションの重要なベンチマークとなる。
- セレブA — 20万点以上の有名人の画像と、画像1点につき40個の属性注釈。
- YouTube-8M ―動画理解のための、機械生成された視覚的エンティティラベルが付いた数百万の動画ID。
適切なコンピュータビジョンデータセットはどのように選べばよいのでしょうか?

データセットを選択する際は、タスク、アノテーションの種類、ドメインの3つの要素を一致させることが重要です。分類プロジェクトにはクラスラベル、検出プロジェクトにはバウンディングボックス、セグメンテーションプロジェクトにはマスクが必要です。ラベルの種類を間違えると、何週間も無駄にしてしまいます。次に、ドメインギャップを確認します。きれいなストックフォトでトレーニングされたモデルは、粗い実写映像ではうまく機能しないことがよくあります。これは、スペイン語の会話集しか勉強していない人が、街頭での速い会話で言葉に詰まってしまうのと同じです。データセットの画像が、照明、角度、解像度、人口統計など、実際の運用条件に近いほど、再トレーニングの必要性は少なくなります。
また、ライセンス条項(多くの研究用データセットは商用利用を禁止している)、クラスバランス、ラベル精度も考慮する必要があります。Shaipチームは、数百ものコンピュータビジョンプロジェクトを通して、公開データセットは動作するプロトタイプまでは作成できるものの、それ以上の精度を実現することはほとんどないことを一貫して発見しています。実運用レベルの精度を達成するには、ほぼ常に、使用するカメラ、環境、および特殊なケースを反映したデータが必要となります。
代わりにカスタムデータセットを作成すべきなのはどのような場合ですか?

精度、網羅性、コンプライアンスのギャップがコスト増につながり始めたら、カスタムデータを作成しましょう。中規模の保険会社が自動車の損害見積もりを自動化しようとしていると想像してみてください。公開されている車両データセットには、スタジオで撮影されたきれいな写真が掲載されていますが、実際の請求には、へこんだバンパーを写した、ぼやけて雑然とした携帯電話の写真が届きます。このようなデータに一致する公開データセットは存在しないため、代表的な画像でモデルをトレーニングするまでは、モデルの性能は低下します。これが転換点です。
公開データセットではエッジケースが網羅されていない場合、カスタムデータ収集とアノテーションによって、モデルがデモ用か本番用かを決定づける稀で困難なシナリオを含む、お客様の状況を正確に反映した画像を作成し、ラベル付けすることができます。また、ライセンスやプライバシーのルールで公開データセットが使用できない場合、クラスがオープンデータセットにほとんど含まれていない場合、またはラベルの品質がクラウドソーシングによるアノテーションでは保証できないほど高い基準を満たす必要がある場合にも、カスタムデータは重要です。プロジェクトが無料データセットの対応範囲を超えた場合は、次のステップとして、お客様のユースケースに特化した収集量、アノテーション仕様、およびコンプライアンス要件の範囲を定める必要があります。
Shaipは、カスタムコンピュータビジョンデータセットに関してどのように役立ちますか?
Shaipは、お客様のモデル、環境、および特殊なケースに合わせて設計されたカスタム画像データセットを構築します。これは、無料のデータセットでは提供できないレベルのものです。オープンデータは汎用的ですが、私たちの取り組みはお客様の課題から始まります。つまり、お客様が使用するカメラ、直面する照明や角度、本番環境で精度を損なう稀なシナリオなどです。これが、マネージド型のエンドツーエンドサービスとしてどのように実現されるかをご紹介します。